简介
本书另有英文原版(English)。
PurRDF 是一个 RDF 1.2 工具包:图原语、编解码器、SPARQL、SHACL、ShEx、蕴涵与图传输,以 Rust 实现一次,并原样带入 Python、WebAssembly/JavaScript 与 C,但有一处例外须先行说明:GTS 容器可从 Rust、CLI(作为输入格式)、Python 与 C 访问,而 wasm/JavaScript 包并不公开它。每一个已发布的 crate 都能构建到 wasm32-unknown-unknown,因此在服务器上回答某条查询的引擎,也会在浏览器标签页中逐字节地给出同一答案。它由黑猫信息科技(Blackcat Informatics® Inc.)开发,以 MIT OR Apache-2.0 OR MulanPSL-2.0 发布。
译注:本书为英文文档的中文译本;未翻译或标为待确认的段落保留英文原文。运行时字符串——命令行
--help、诊断消息与 Python__doc__——不作本地化;稳定诊断代码的中文说明见诊断代码参考。
同一个 RDF 引擎。同一套行为。每一种语言。
它从架构中移除了什么。 通常让一个 PostgreSQL 实例伴随三元组存储运行的三项工作——带排名的全文检索、空间谓词与向量相似度——都在 PurRDF 内部得到回答:进程内、同一数据集、同一条 SPARQL 查询,没有第二个数据库,也没有同步作业。数值契约是明确的:精确的文本得分、经过认证的地理结果,以及确定的 binary64 向量得分。见下文一个引擎取代三个数据库。
PurRDF 为何存在?
RDF 工具沿两条轴线碎片化。
跨语言:每个生态都有自己的解析器,带着自己的缺陷、自己对边界情况的解读,以及自己所实现的规范子集。把一张图从 Rust 服务搬到 Python 流水线再搬到浏览器,数据的含义就已被悄悄改变了三次。
跨时间:RDF 1.2——三元组项、具体化节点(reifier)、基础方向字面量——是标准的现行修订版,而几乎没有哪个现存的库承载它。
PurRDF 之所以存在,是为了让一张图在任何地方都是同一张图。它是一个从零实现、依赖极简的 Rust 核心——从解析器到 SPARQL 引擎到 SHACL 验证器再到二进制传输——经由原生绑定公开,而不是逐语言重新实现。
里面有什么
- RDF 1.2 图原语——一个不可变的、按值驻留的数据集 IR(
TermId空间、字符串存储区、写时复制的变更),带有宾语位置的三元组项、具体化节点/注解侧表(side table),以及基础方向字面量。参见驻留数据集 IR。 - 原生编解码器——Turtle、TriG、N-Triples、N-Quads、RDF/XML、TriX、HexTuples、JSON-LD (star) 与 YAML-LD 的第一方解析器/序列化器,输出逐字节确定。参见编解码器与确定性。每种语法都经由同一个 RFC 3986 层解析相对 IRI(国际化资源标识符)引用,而作用域内没有基准的相对引用是硬错误。参见基准 IRI 与相对引用。
- 规范化——在 RDF 1.1 子集上是 W3C RDFC-1.0;在 RDF 1.2 构造之上,则是扁平形式(在
rdf:reifies三元组上运行 RDFC-1.0)或第一方的purrdf-rdfc12profile 二者之一,以不同的名字区分——外加数据集 diff 与同构判定。参见规范化与 Diff。 - 投影与载体——确定性的 LPG、CSVW、OBO Graphs、数据集描述与 Research Object(RO)投影,每一种都带有定位到具体位置的损失台账。参见图、表格与 Research Object 投影。
- SPARQL 1.1/1.2——原生解析器 → 代数 → 多重集求值器,带有完整的 Update、SEP-0002 时间算术、
LATERAL(SEP-0006)、SEP-0008 的 SHA-3 哈希内建函数(SHA3-224/256/384/512)、能CONSTRUCT进命名图的四元组模板(这是第一方扩展,并非 SPARQL 1.2 特性)、SEP-0009 复合数据类型(cdt:List/cdt:Map、FOLD、UNFOLD——并有一处明确陈述的分歧:PurRDF 允许 RDF 1.2 三元组项与带方向的语言标签字面量作为复合元素,这是一个词法超集,符合 SEP-0009 的读取器会将其判为格式错误)、调用方注册的聚合函数与属性函数(包括逐跳绑定遍历过程的路径见证(path witness))、带逐节点解释回执的受调控执行,以及一个SERVICE扩展点——一个宿主注入的、携带逐服务上下文的服务解析器(resolver);不附带 HTTP 客户端,也不附带服务解析器,因此在每个随库发布的接口上,SERVICE与LOAD都会按名称失败,除非写作SILENT——全部由 W3C 一致性套件把关。参见 SPARQL。 - 核心 crate
purrdf-core之外的 SPARQL 扩展——采用精确定点 BM25 的确定性全文检索(全文检索)、保留精确坐标输入并提供数值认证的 GeoSPARQL 1.1(GeoSPARQL),以及在 PURREMB 嵌入空间上的最近邻搜索(嵌入最近邻)——每一个都是扩展点(extension seam)的使用方,在调用方提供的 IRI 之下注册。 - SHACL 与 ShEx——两种形状语言的原生验证器;SHACL 引擎实现了 SHACL 1.2 Core、SPARQL 扩展、节点表达式与推理规则,以及 SPARQL 1.2 RL 规则语言。参见验证。
- 蕴涵——Simple/RDF/RDFS/OWL-RL/D 物化(全部 78 条 OWL 2 RL 规则均已实现——这是规则表覆盖率,有别于蕴涵一致性;在这份随库固化(vendored)的 W3C 语料上,OWL 2 RL 蕴涵测试的成绩是正例 27/27、负例 23/23)、一个 OWL-Direct tableau,以及 RIF-Core 规则,每次求推理闭包都附带推理报告。参见蕴涵,其求值基于 Datalog 不动点引擎。
- GTS 图传输——面向 RDF 1.2 图与二进制载荷的单文件、内容寻址、仅追加的容器。参见 GTS 图传输。
- 切片、映射与溯源——切片目录、显式的 RDF↔GTS 损失台账、SSSOM 与 FnO。参见切片、映射与溯源。
一个引擎取代三个数据库
需要带排名的文本检索、空间谓词或最近邻搜索的 RDF 项目,通常正是为了这三项工作而在三元组存储旁边运行一个 PostgreSQL。PurRDF 直接在已加载到内存的数据集上、通过求值器提供的、以调用方为键的扩展点,用 SPARQL 回答全部三项——下面每个页面都以「它的接口取代了什么、止步于何处」开篇。
| 所需能力 | 通常来自 | 如今在 PurRDF 之内 | 止步于何处 |
|---|---|---|---|
| 带排名的全文检索 | PostgreSQL tsvector/tsquery | 全文检索:purrdf-text,一个覆盖 RDF 1.2 字面量的倒排索引,以精确的 i128 定点数做 BM25 排名,crate 内没有浮点。 | 精确 BM25F、显式词干提取与词典分析,以及独立的汉字检索;没有停用词表或查询方言;检索冻结数据集的内存索引。 |
| 空间谓词 | PostGIS | GeoSPARQL:通过 purrdf-geo 使用 purrdf-geo-kernel,包括精确的 WKT/GeoJSON 坐标、DE-9IM 关系、地理度量、缓冲区及显式坐标操作;不依赖 GEOS 或 PROJ。 | 参考系、单位、操作链、数值上限及容差均须显式指定。不支持栅格;凹包及叠加集合运算仍按名称返回拒绝错误。具体函数覆盖范围见该章。 |
| 向量相似度 | pgvector | 嵌入最近邻:在 PURREMB 嵌入空间上的精确 top-k,binary64 且累加顺序固定。 | 由调用方提供的 KnnGuard 限定的精确扫描,三种度量,没有近似索引;PurRDF 不计算嵌入——向量来自由调用方填充的 PURREMB 工件,该工件由 PurRDF 自身写出(EmbeddingBuilder、EmbeddingStreamWriter;仅限 Rust),并以失败即关闭(fail-closed)的方式打开。 |
文本排名使用精确定点数;嵌入搜索使用固定的 binary64 累加顺序和规范的并列判定。地理请求保留精确的输入坐标,并采用显式数值认证。原生测试固定数值与序列化的预期结果。make wasm 为 wasm32-unknown-unknown 构建这些功能的发布 crate;针对性的可移植测试实际执行分派、内核与宿主接口。文本索引与嵌入空间通过 Rust 宿主的注册扩展点接入,使用调用方提供的 IRI,宿主也可编译到 wasm32。打包后的地理宿主入口见 GeoSPARQL。
第一天就值得知道的两条设计规则
没有语义性的 Cargo feature。 每个使用方得到同样的、逐字节相同的语义。唯一的 feature 声明是 cargo-c 所需的空兼容性标记 purrdf-capi:capi = [];它不控制任何代码。CI 拒绝其他 feature、可选依赖及受 feature 控制的行为。
应用词汇表必须显式指定。 PurRDF 是工具包,不是本体。结构化 Markdown 与有序 JSON 提供具名的标准 profile;调用方须有意选择它们,或自行提供词汇表。其他应用词汇表均由调用方配置,没有杜撰的默认值。在缺少其词汇表的情况下使用某项功能,要么硬错误,要么保持未激活。测试夹具使用 example.org。
完整的不变量清单见设计规则与不变量。
版本号所承诺的内容
自 1.0.0 起,整套软件完整遵循语义化版本:破坏性变更递增主版本号,次版本递增仅作增补,补丁版本递增仅修复缺陷,而 crates.io、PyPI 与 npm 上的包以同一个工作区版本同步发布。唯一的例外是 C ABI(purrdf.h),它带有自己的 0.x ABI 版本,每当导出签名变更时递增,且并未冻结。参见版本与发布。
为什么是 RDF 1.2?
RDF 1.2(以及 SPARQL 1.2)为数据模型加入了一等的陈述级元数据:可出现在宾语位置的三元组项、为三元组的某次出现命名的具体化节点,以及用于双向文本的基础方向字面量(rdf:dirLangString)。PurRDF 把它们当作核心数据模型而非扩展:它们贯穿 IR、编解码器、SPARQL、SHACL 1.2(具体化节点形状与三元组项节点类型)、RDF/JS 接口以及 GTS 传输。参见 RDF 1.2 特性。
PurRDF 的位置
PurRDF 是一小族关联数据项目的库层:它是 GMEOW 技术栈的数据骨干,也是 Rust 版 GTS 引擎的参考实现所在——但它对调用方的本体或应用不作任何假设。
如何阅读本书
API 参考文档位于 docs.rs/purrdf;仓库是 github.com/Blackcat-Informatics/purrdf。
入门:Rust
Rust 下游唯一需要的依赖是总括 crate purrdf。它在根部重新导出 RDF 1.2 实现接口,并把其他每个已发布的 crate 置于一个稳定的模块之下(purrdf::sparql、purrdf::shapes、purrdf::shex、purrdf::gts、purrdf::entail、purrdf::validate、purrdf::slice、purrdf::iri、purrdf::xsd、purrdf::events)——使用方合理导入的任何内容都只凭 purrdf 即可到达,绝不需要深入某个子 crate。
cargo add purrdf
MSRV 为 Rust 1.98,位于 stable 通道:按政策,代码不使用任何 nightly(不稳定)特性,因此 stable 1.98 即可构建。仓库自身的工具链浮动跟随 nightly,以获得更锐利的 lint;参见版本管理与发布。
译注:中国大陆镜像。 如需使用 crates.io 镜像,可参考 TUNA、USTC 与 rsproxy.cn 的说明,在 ~/.cargo/config.toml 中通过 [source] 配置源替换。具体配置以各镜像站的说明为准。
构建、冻结、序列化、解析
use purrdf::{parse_dataset, serialize_dataset, RdfDatasetBuilder, RdfLiteral, SerializeGraph};

// 在驻留的 TermId 空间中构建数据集。
let mut b = RdfDatasetBuilder::new();
let alice = b.intern_iri("https://example.org/alice").unwrap();
let knows = b.intern_iri("http://xmlns.com/foaf/0.1/knows").unwrap();
let bob = b.intern_iri("https://example.org/bob").unwrap();
let name = b.intern_iri("http://xmlns.com/foaf/0.1/name").unwrap();
let hi = b.intern_literal(RdfLiteral::simple("Alice")).unwrap();
b.push_quad(alice, knows, bob, None).unwrap();
b.push_quad(alice, name, hi, None).unwrap();
let ds = b.freeze().expect("freeze");

// 序列化为任一原生编解码器的格式并解析回来,不丢失信息。
let ttl = serialize_dataset(&ds, "text/turtle", SerializeGraph::Dataset).unwrap();
let back = parse_dataset(&ttl, "text/turtle", None).unwrap();
assert_eq!(back.quad_count(), 2);
构建器→冻结的拆分是这套 API 的核心:在可变的 RdfDatasetBuilder 上驻留项并推入四元组,然后 freeze() 为一个不可变、带索引的 RdfDataset,每个引擎(SPARQL、SHACL、ShEx、蕴涵)都在其上求值。项驻留与插入会返回带类型的存储失败;应用代码应向上传递这些错误,而不是忽略它们。参见驻留数据集 IR。
直接解析文本
let turtle = r#"
    @prefix ex: <https://example.org/> .
    ex:cat ex:says "meow" .
"#;
let dataset = purrdf::parse_dataset(turtle.as_bytes(), "text/turtle", None)
    .expect("valid Turtle");
assert_eq!(dataset.quad_count(), 1);
格式错误的输入会得到一个带类型的 RdfDiagnostic,并在编解码器能够提供时附带源位置——绝不会是静默的部分解析。
到达其他引擎
每个引擎都挂在同一个门面之下。例如,IRI 层(不依赖任何第三方包)与 ShEx 模式层:
let iri = purrdf::iri::parse("https://example.org/cat").expect("valid IRI");
assert_eq!(iri.as_str(), "https://example.org/cat");

let schema = purrdf::shex::parse_shexc(
    "PREFIX ex: <https://example.org/>\nex:Cat { ex:says . }",
    None,
).expect("valid ShExC");
何时应改为依赖子 crate
大多数应用只需依赖 purrdf。子 crate(purrdf-core、purrdf-rdf、purrdf-columnar、purrdf-sparql-algebra、purrdf-sparql-eval、purrdf-sparql-results、purrdf-cdt、purrdf-shapes、purrdf-jsonschema、purrdf-shex、purrdf-gts、purrdf-datalog、purrdf-entail、purrdf-geo、purrdf-text、purrdf-validate、purrdf-slice、purrdf-iri、purrdf-lex、purrdf-xsd、purrdf-events、purrdf-hash、purrdf-wasm)是为只想要恰好一个引擎的使用方准备的——例如,只需要 IRI 解析的工具可以仅依赖 purrdf-iri,它的依赖是第一方词法层 purrdf-lex 与零依赖的 purrdf-hash。crate 一览见仓库 README。
每个发布的 crate 都能干净地构建到 wasm32-unknown-unknown,因此同样的 Rust 代码路径在原生宿主与 wasm 宿主中都能工作。
后续步骤
- 驻留数据集 IR——IR 如何工作,以及它为何快速。
- 图、表格与 Research Object 投影——通过总括 crate 获得确定性的 LPG、CSVW、OBO Graphs、SKOS 与 Research Object 载体。
- SPARQL:查询——在冻结的数据集上运行查询。
- docs.rs/purrdf——完整的 API 参考。
入门:Python
Python 包封装的是同一个原生 Rust 引擎,而非重新实现,因此解析、序列化、SPARQL 与验证的行为与 Rust、JavaScript 和 C 接口完全一致。
译注:中国大陆镜像。 如需使用 PyPI 镜像,可参考 TUNA、USTC 与 阿里云 的说明。例如,pip install -i https://pypi.tuna.tsinghua.edu.cn/simple purrdf 使用 TUNA 镜像。具体配置以各镜像站的说明为准。
pip install purrdf
解析
import purrdf

quads = purrdf.parse(
    '<https://example.org/alice> <http://xmlns.com/foaf/0.1/name> "Alice" .',
    purrdf.RdfFormat.TURTLE,
)
验证:SHACL 与 ShEx
原生验证引擎以顶层子模块的形式公开,与 Rust 的 purrdf 门面 crate(umbrella crate)保持同构——绝不直接经由内部的 purrdf_native 扩展模块:
from purrdf import shapes, shex

report = shapes.validate(shapes_ttl=my_shapes, data_nt=my_data)
print(report["conforms"])

results = shex.validate(my_schema_shexc, my_data_ttl,
                        [("https://example.org/alice", "https://example.org/PersonShape")])
print(results[0]["conformant"])
SHACL 结果字典保留稳定的键 focus、path、value、severity、component、source_shape 与 messages(每条 sh:resultMessage,连同其语言标签与方向)。两个引擎各自覆盖的范围见 SHACL 与 ShEx。
蕴涵
purrdf.entail 在某一 SPARQL 蕴涵机制(entailment regime)下对数据集求闭包。它不是 purrdf.shapes.entail——后者应用的是_形状_图所声明的 SHACL-AF sh:rule;这里不接受任何形状,只使用该蕴涵机制自身规范中的规则表。
import purrdf
from purrdf import entail

dataset = purrdf.RdfDataset(my_turtle, purrdf.RdfFormat.TURTLE)
closure, report = entail.materialize(dataset, "rdfs", "", [], [])
print(closure.to_nquads())
print(report)          # 已触发的、未触发的、边界、预算、契约哈希
推理报告是第二个返回值,且永远不可省略——这与 Rust、WebAssembly 和 C 接口所执行的纪律一致。两个 [] 参数分别是该数据集的 owl:imports 表——由 (ontology_iri, nquads) 对组成——以及读取该数据集所用的 IRI:导入了某份文档的数据集会在合并结果上求推理闭包,而该表无法解析的导入会抛出点名它的 ValueError。entail.materialize_nt(text, regime, program, imports, premise_iris) 是其对应的文本进、文本出版本,供持有 N-Triples/N-Quads 文档的调用方使用。
覆盖率是可测量的,而非口头断言:entail.rules(regime) 是规范用以定义该蕴涵机制的规则表,entail.implemented_rules(regime) 则是其中实际会触发的子集。"owl-direct" 与 "rif" 在此返回 []——二者都没有自己的规范规则表,一个通过 tableau 判定,另一个在调用方自己的规则下蕴涵——而不是抛出错误。完整说明见蕴涵,逐条规则的表格见规则清单。
rdflib 兼容
本包附带一个 rdflib 兼容层:
from purrdf.compat.rdflib import Graph
若需要逐字不改的 import rdflib,可选装一个 extra:
pip install "purrdf[rdflib]"
这会拉入独立的 purrdf-rdflib 分发包,其顶层 rdflib 包重新导出兼容层的接口,于是现有第三方代码中的 import rdflib / from rdflib.namespace import RDF 便透明地运行在 PurRDF 之上。注意:该影子包占用了 rdflib 这一导入名,绝不可与真正的 rdflib 同时安装——二者无法共存于同一环境。它是一个独立的分发包(从不打进主 purrdf wheel),正是为了让需要真实 rdflib 的环境直接不装它即可。
兼容层在 CI 中以 rdflib 7.6 自带的、随库固化(vendored)的测试套件加上第一方的差分对等性测试套件把关——细节以及已知的、已入台账的分歧见 rdflib 兼容。
GTS 关系型行
Python 包把一个 GTS 容器读回为内存中的关系型行:
from purrdf import gts_relational_rows_from_bytes

rows = gts_relational_rows_from_bytes(gts_bytes)  # 项、四元组、具体化节点、注解、二进制块
gts_to_sqlite(data, path)、gts_to_duckdb(data, path) 与 gts_to_parquet(data, out_dir) 按投影自身的行顺序写出同样的五张表——因此把一个容器导出两次会产生相同的内容。SQLite 只需标准库;另外两者会抛出 ModuleNotFoundError,并指明需要安装的 extra(purrdf[duckdb]、purrdf[parquet])。
图、表格与 Research Object(RO)归档
purrdf.project(data, format=..., profile=..., config=...) 返回规范的 USTAR 字节与结构化的损失记录。purrdf.lift(archive, profile=..., config=...) 则为十个双向 profile 重建 RDF。每个宿主都使用同一套严格配置与同样确定性的 Rust 代码路径;各 profile 及完整示例见图、表格与 Research Object 投影。
后续步骤
- rdflib 兼容——直接替换方案的深入说明。
- 验证——在 Python 中使用 SHACL 与 ShEx。
- 蕴涵——各蕴涵机制、推理报告,以及各自触发的规则。
- GTS 图传输——导出功能所读取的容器格式。
- 图、表格与 Research Object 投影——LPG、CSVW、OBO、SKOS 与五种 Research Object 载体。
Python API 指南
使用公开的 purrdf 包。它的 Store、词项和查询结果与 Rust API 调用同一个原生引擎。通过 purrdf.shapes、purrdf.shex 和 purrdf.entail 导入验证与蕴涵功能。
完整签名参考 记录主包和 purrdf.geo 的权威 stub,包括属性、重载、命名空间别名和辅助类型。下文说明所有权、配置、结果解释和失败行为。签名中以下划线开头的类型描述实现或返回类型;列出这些类型并不意味着它们是公开构造器。例如,在注解中使用 purrdf.shapes.PreparedShapes,不要导入 _PreparedShapes。
TypedDict 声明描述字典结果的结构;不要假定每个结构名称都是导出的原生构造器。通过文档所述的生成方获取记录,再读取其命名字段。
加载与查询
Store.load(input, format, *, path, base) 接受文本、字节或由 path 指定的文件。必须提供且仅提供一个输入源,并指定格式。返回值是解析后文档的已解析前缀映射,按前缀排序;没有前缀声明的格式返回空映射。相对引用需要文档自身的基址声明或显式绝对 base。
import purrdf

store = purrdf.Store()
prefixes = store.load(
    '@prefix ex: <https://example.org/> . ex:alice ex:name "Alice" .',
    purrdf.RdfFormat.TURTLE,
)
assert prefixes == [("ex", "https://example.org/")]
rows = list(store.query(
    "SELECT ?name WHERE { <https://example.org/alice> "
    "<https://example.org/name> ?name }"
))
assert rows[0]["name"].value == "Alice"
SELECT 返回 QuerySolutions。结果行支持变量名、Variable 对象和整数位置,包括负索引。未绑定的投影单元格是 None,不会被省略。不存在的变量名引发 KeyError,越界位置引发 IndexError。ASK 返回 QueryBoolean。默认图上的 CONSTRUCT/DESCRIBE 结果迭代产生 Triple;携带命名图的结果迭代产生 Quad。
RDF 词项与精确值
NamedNode.value 是该节点的 IRI。Literal.value 保留词法形式;数据类型、语言和方向分别由其他属性表示。语言标签的身份比较忽略大小写。用 datatype=NamedNode(iri) 构造带数据类型的字面量,用 language= 构造语言字面量,同时指定 language= 和 direction= 构造带方向的语言字面量。
name = purrdf.NamedNode("https://example.org/alice")
text = purrdf.Literal("你好", language="zh-Hans")
assert name.value == "https://example.org/alice"
assert text.value == "你好"
assert text.language == "zh-Hans"
默认策略在商为有限小数时保留全部数字,否则舍入到小数点后 18 位,采用半偶舍入。division="exact" 将无限循环商作为表达式错误,使该单元格未绑定;division="N" 截断到小数点后 N 位,division="N:ROUNDING" 显式选择舍入方式。exact-or-N[:ROUNDING] 保留精确的有限商,只对循环商舍入。无效策略在执行前引发 ValueError。
result = store.query("SELECT ((1 / 1048576) AS ?value) {}")
assert list(result)[0]["value"].value == "0.00000095367431640625"
result = store.query("SELECT ((2 / 3) AS ?value) {}", division="2:half-even")
assert list(result)[0]["value"].value == "0.67"
xsd = "http://www.w3.org/2001/XMLSchema#"
assert purrdf.xsd_canonical_lexical("+00042", xsd + "integer") == "42"
assert purrdf.xsd_value_compare("1.00", xsd + "decimal", "1", xsd + "integer") == 0

result = store.query(
    'PREFIX xsd: <http://www.w3.org/2001/XMLSchema#> '
    'SELECT (xsd:dateTimeStamp("2024-02-29T12:30:00.123456789012345678901Z"'
    '^^xsd:dateTime) AS ?value) {}'
)
calendar = list(result)[0]["value"]
assert calendar.value == "2024-02-29T12:30:00.123456789012345678901Z"
assert calendar.datatype.value == xsd + "dateTimeStamp"
对于精确十进制数和时间值,应使用词法形式,不要先转换为 Python float 或小数位更少的表示。XSD 辅助函数对不支持的数据类型或格式错误的词法形式返回 None;若值空间无法为二者排序,例如涉及 NaN,比较也返回 None。
预备查询
用 Store.prepare(..., parameters=[...]) 声明参数名。每次运行都必须把每个已声明名称绑定到 RDF 词项。未知名称或缺失绑定会引发错误。配置在预备时固定,每次运行从存储读取源行。参数名不带 ?。
prepared = store.prepare(
    "SELECT ?name WHERE { ?person <https://example.org/name> ?name }",
    parameters=["person"],
)
assert prepared.parameters == ["person"]
rows = list(prepared.run(person=purrdf.NamedNode("https://example.org/alice")))
assert rows[0]["name"].value == "Alice"
资源治理与不完整答案
query_governed 在查询选项上增加 fuel、deadline_ms、max_answers、max_intermediate_cells、max_scratch_bytes、max_remote_requests、no_ceiling 和 cancel。上限包含边界值。省略上限仍保留计量。no_ceiling=True 关闭核算和资源上限,但保留截止期限与取消;它不能与显式上限同时使用。
stopped = store.query_governed("SELECT ?s ?p ?o WHERE { ?s ?p ?o }", fuel=0)
assert not stopped.is_complete
assert stopped.result is None
assert stopped.tripped is not None
complete = store.query_governed(
    "SELECT ?name WHERE { <https://example.org/alice> <https://example.org/name> ?name }")
assert complete.is_complete
assert list(complete.result)[0]["name"].value == "Alice"
只有 is_complete 为真时才有完整结果。发生中断时检查 tripped、partial 和 evidence,不要把部分答案当成全部结果。update_governed 返回自己的执行结果;中断的更新不应用任何修改。
命名图与引擎配置
默认 Store 记住已声明的空命名图。remember_empty_graphs=False 显式选择由行决定图存在性的另一模式。这些模式改变图是否存在,不改变已有 RDF 陈述的解释。
remembered = purrdf.Store()
remembered.update("CREATE GRAPH <https://example.org/empty>")
assert remembered.named_graphs() == [purrdf.NamedNode("https://example.org/empty")]
implicit = purrdf.Store(remember_empty_graphs=False)
implicit.update("CREATE GRAPH <https://example.org/empty>")
assert implicit.named_graphs() == []
查询、更新和预备入口接受显式扩展命名空间、属性函数命名空间、立场谓词、关系表、聚合命名空间、指定日期的 XPath 正则配置(profile)、地理配置和除法策略。依赖命名空间的扩展需要调用方提供配置。关系声明作为数据跨越边界,不是 Python 回调。
关系表、图内表与遍历
relations 将精确的谓词 IRI 映射到 (input_arity, output_arity, rows)。行包含原生 RDF 词项,展平后的宽度必须符合声明。relations_from_graph 提供列表头和相同的元数,从查询数据集读取表。path_relations 提供允许的谓词与方向步骤、最少和最多跳数、路径与展开限制,以及 walk 或 shortest。这些是数据声明,不是 Python 回调,因此求值可以释放 GIL。
遍历为每一跳输出一行,绑定端点、路径身份、长度、步骤、节点和经过的陈述。陈述是 RDF 1.2 三元组项,可以与普通图模式连接。每个遍历限制都必须显式指定;最少跳数为零、无效或重复步骤以及不可用的限制会引发 ValueError。有效路径若没有匹配边,则不贡献行。
可选证明声明为 (generation, incompleteness),两者分别为字符串或 None,独立记录索引版本和宿主声明的数据不完整原因。None 表示没有声明,不是整个索引的完整性证明。受治理查询在 relation_witness 中返回这些声明;不受治理的调用无法报告已声明的缺失,因此拒绝该调用。三个关系映射之间重复注册、行宽不一致和破损 RDF 列表都是错误。已注册的精确 IRI 不需要命名空间设置;声明 property_fn_namespaces 后,这些前缀下未注册的 IRI 会成为硬错误,而不是普通图模式。
aggregate_namespace 注册十个内置统计聚合:MEDIAN、PERCENTILE、STDDEV、STDDEV_POP、VARIANCE、VAR_POP、MODE、FIRST、LAST 和 TOPK。它不注册任意 Python 累加器回调。xpath_regex 从 XPATH_REGEX_PROFILES 中选择规则;省略时保留兼容规则。模式或标志被拒绝属于表达式错误,原生 xpath-* 资源拒绝则引发 ValueError。standpoint_predicates 提供调用方的两个谓词 IRI;库不自行编造。
读取执行证据
CancellationToken.cancel() 是单调操作;检查 cancelled,并为另一段独立的取消生命周期创建新令牌。触发资源治理(governor)限制会返回执行结果,KeyboardInterrupt 则仍为异常。TrippedGovernor 提供 kind、label、dimension、limit、consumed、estimate 和 cause;准入估计不是实测消耗。
GovernorEvidence.consumed 和 limits 是按维度组织的映射,也可以通过 consumed_in() 和 limit_for() 读取。expression_errors 按完整限定 XPath 错误码统计已吸收的数值表达式错误,并保留零值条目。例如,投影中的除法错误可使单元格未绑定,但查询仍完成;COALESCE 可以恢复该错误。
PartialAnswers.certainty 区分 certain(每个返回行都是答案)、at-most(所有答案都包含在返回候选中)和 unknown(任何行都不可使用)。is_positional_prefix 是独立属性;可靠的子多重集未必是完整结果的前若干行。barrier 指明阻止认证的运算符。必须依据证书读取 result。UpdateOutcome.is_applied=False 表示没有发布任何修改。
始终存在的 QueryOutcome.relation_witness 将已调用关系 IRI 映射到调用次数、不同代次及声明的不完整原因。空映射不能证明完整性。调用次数反映执行调度,不能跨线程数或预算把它当作稳定索引身份比较。核算、优先级和区间保证见资源治理(governor)配置(profile)。
容器、修改与快照
| 类型 | 用途与所有权 |
|---|---|
Store | 可修改的四元组存储,支持查询、更新、加载、准备和检查点操作。其 add 和 remove 返回 None。 |
MutableDataset | 共享相同的查询与更新接口,提供返回布尔值的 add/remove、contains、quads_for_pattern 和显式 compact。 |
Dataset | 可修改的四元组集合,支持迭代、长度和原地空节点规范化。它不是冻结的 RdfDataset。 |
RdfDataset | 不可变的已解析 RDF 1.2 数据集,支持计数以及规范、文本、GTS 和列式导出。 |
QuadIter | 可修改容器返回的四元组迭代器;按普通迭代器协议使用。 |
load 和 bulk_load 返回文档最终已解析的前缀映射,不是陈述数量。add_graph 遵循构造器选择的图存在性模式;silent=True 抑制已存在的记忆图槽错误,不会抑制无效图名。named_graphs 排除默认图,并在存储记忆空图时包含已声明空槽。
批量加载后,Store.checkpoint() 将当前增量并入冻结基底,内容不变。随后 change_size() 报告该检查点之后的新增与删除。在增量验证序列前,应在加载完成后建立一次检查点,否则初始加载本身也属于待处理修改。压缩是显式工作,不应在每次单独修改后执行。
预备查询保留其来源存储,每次 run 都读取该存储的当前内容。从图派生的关系表与遍历会针对本次数据集重新构建,并重新进行计划准入。配置固定并不表示数据已冻结。PreparedQuery 不是线程安全的,运行尚未结束时不能重入。
查询在返回前物化拥有所有权的结果。QuerySolutions、QueryTriples 和 QueryQuads 是迭代器;以后还要遍历时应复制结果行。QuerySolutions.variables 提供有序结构。QueryQuads.graph_names 返回按 N-Triples 词项语法排序的图标记。将携带图的查询结果序列化为单图语法会引发 ValueError,不会默默擦除图名。四元组模板 CONSTRUCT 是本库扩展,不属于 SPARQL 1.2 的定义。
词项、格式与序列化
NamedNode 和 BlankNode 提供 value;Variable.value 是变量名。Triple 提供 subject、predicate 和 object;Quad 另有 graph_name。RDF 1.2 允许三元组项出现在宾语位置,不允许出现在主语位置。默认图由 DefaultGraph 表示,四元组构造器也接受 None 表示默认图。词项支持文档规定的相等比较和哈希;语言标签的相等比较忽略大小写,Literal.value 保留词法形式。普通字面量的数据类型读取值为 xsd:string;语言字面量和带方向的语言字面量分别返回 rdf:langString 和 rdf:dirLangString。
RdfFormat 成员为 TURTLE、N_TRIPLES、N_QUADS、TRIG、TRIX、HEXTUPLES、JSON_LD、YAML_LD 和 RDF_XML。文档自身的基址声明优先于传入的 base。相对引用若两者皆无,则引发带 iri-relative-no-base 的 ValueError;不会编造检索 IRI。输出时,不支持基址声明的格式使用绝对 IRI。
parse 返回四元组列表。serialize 和存储的 dump 重载向二进制输出写入字节;不传输出时返回字节。from_graph 选择导出图;base 选择输出基址,并与该选择组合。CompiledJsonLdContext 接受严格的选项 JSON,可以用 from_prefixes 构造,并提供可保留的 canonical_context_json。按声明传入支持的选项或已编译上下文;不要假定普通 Python 字典可以与 JSON 文本互换。
dump_with_loss 返回 SerializeLoss:包含 bytes,以及 statement_rows_dropped、directional_literals_dropped、named_graph_rows_dropped 和 empty_named_graphs_dropped。前三项按原因统计丢失的行或修饰信息;第四项统计只有声明而没有可计数行的图。应读取所有计数器。它们表示此次输出实际发生的损失,不同于 loss_matrix_json() 或 rdf_gts_loss_matrix_json() 返回的静态格式对矩阵。
to_json_ld、serialize_jsonld、from_json_ld、to_rdf_xml 和 from_rdf_xml 在 RDF 字节与文本形式之间转换。statement_vocab 是调用方显式提供的元数据词汇;其 class、subject、predicate、object 和 objectLiteral 值均为绝对 IRI。没有编造的命名空间后备。project_statements_rdf12 和 normalize_rdf12_to_owl 提供陈述编解码转换;canonicalize_turtle 返回规范字节,并可额外接收前缀映射。
Dataset.canonicalize 按 CanonicalizationAlgorithm.RDFC_1_0 或 UNSTABLE 原地重标记空节点。RdfDataset.to_nquads() 使用随库提供的平面规范化配置(profile):它在 RDF 1.1 子集上与 RDFC-1.0 一致,而 RDF 1.2 配置有独立的保留词汇、陈述层和拒绝契约。不要将 RDF 1.2 摘要标为 RDFC-1.0。规范化拒绝会引发 ValueError。将字节用作身份前,请阅读规范化章节。
XSD 辅助函数接受词法字符串和数据类型 IRI:xsd_value_compare 返回顺序,遇到不支持、格式错误或无序值时返回 None;xsd_canonical_lexical、xsd_decode_binary 和 xsd_normalize_whitespace 返回其值或 None。不要先将精确十进制数或秒的小数部分转换为 Python float。
SPARQL 结果与来源记录
serialize_sparql_solutions 接受有序变量列表,以及每个变量对应一个单元格的行;未绑定单元格保留为 None。serialize_sparql_boolean 处理 ASK。两者按 SparqlResultsFormat 中的别名和媒体类型生成确定性的 JSON、XML、CSV 或 TSV 字节。parse_sparql_results 读取 JSON 或 XML,返回带区分标记的元组:("SELECT", variables, rows) 或 ("ASK", boolean)。这里没有 CSV 或 TSV 原生读取器。
来源记录是附加信息,需要 provenance_namespace=(prefix, iri);query_hash 提供调用方的身份。provenance_from_json 和 provenance_from_xml 从该命名空间读回 query_hash 与 engine。没有来源记录时字段为 None,不会编造身份。
SHACL 验证、预备与规则
使用 purrdf.shapes;purrdf.shacl 是兼容别名。单次调用的 shapes.validate 接受 Turtle 形状和 N-Triples 数据,返回报告字典。shapes.Shapes 解析可复用形状。validate_nt 返回 ValidationReport;validate_store 直接读取 Store 或 MutableDataset 的原生快照,不经过文本往返。后续修改影响下一份报告,不改变已返回报告。
ValidationReport 提供 conforms、shapes_graph_well_formed、diagnostics 和 results,以及 to_ntriples() 和 to_sarif()。结果消息保留文本、语言、方向和数据类型。空 sh:in 或 sh:xone 列表会在结果之外生成强制诊断,但不改变符合性或报告图。单次调用报告记录 conformance_disallows:省略时使用 SHACL 默认的 Violation/Warning/Info 集合,不含 Debug 和 Trace。禁止集合为空或严重性不是 IRI 时会引发异常。
shapes_ttl = '''
@prefix sh: <http://www.w3.org/ns/shacl#> .
@prefix ex: <https://example.org/> .
ex:PersonShape a sh:NodeShape;
    sh:targetNode ex:alice;
    sh:property [ sh:path ex:name; sh:minCount 1 ] .
'''
shapes = purrdf.shapes.Shapes(shapes_ttl)
assert shapes.validate_store(store).conforms
prepared_shapes = shapes.prepare()
product = purrdf.shapes.ShapesProduct.open(prepared_shapes.to_product())
restored = product.admit_expecting(product.identity_digest())
assert restored.validate_nt(
    '<https://example.org/alice> <https://example.org/name> "Alice" .'
).conforms
导入与执行环境
每个形状入口从调用方提供的有序 imports 表解析导入,条目为 (IRI, Turtle document)。它不获取网络内容。未解析或无效导入、未使用条目及不兼容版本会引发 shapes.ShapesImportError;按 kind 分支并检查 iris。数据图中的 sh:shapesGraph 链接必须由手头材料解析。预备形状不能在数据到达时默默加入另一个链接图;未持有的链接会被拒绝。
shapes_base(或 Shapes(..., base=...))解析相对形状 IRI。shapes_graph 命名 SHACL-SPARQL 通过 $shapesGraph 读取的图;省略时不编造图。这是 SHACL 1.0 的预绑定,已从 SHACL 1.2 移除。subclass_of_in_shapes_graph=True 还会读取形状图中的子类三元组判断类成员;rdf:type 仍来自数据图。xpath_regex 将指定日期的规则用于分面和嵌入式 SPARQL。资源拒绝会引发异常,不会返回空报告或符合报告。
Shapes.extension_usage 在验证前检查声明:sites 按给定命名空间和注册项区分调用与数据谓词;unreadable 和 complete 表明准入失败。因此可以区分未识别关系与没有结果行的有效关系。shapes.lint_shapes 执行冷审计,报告发现、加载错误、强制诊断、已被取代的验证器、未执行的查询声明、导入锚定和确定性报告文本。两者都不是数据验证。
预备产物与增量报告
Shapes.prepare() 返回 PreparedShapes;to_product() 写入确定性字节。shapes.pack_product() 组合解析、准备和写入。ShapesProduct.open() 验证封装并读取自描述信息,但不准入可执行预备结果。检查 format_version、stage_id、stage_known、identity_digest、identity_components 和 explain;to_bytes 返回封装。admit 恢复已知阶段,rebuild 在需要时重建。它们的 _expecting 形式绑定预期身份,并以维度 shapes-graph 拒绝不匹配。certify 检查产物的认证义务。应按 ShapesProductError.dimension 分支,不解析异常文本。PreparedShapes.provenance() 区分已解析、恢复后准入和恢复后重建的预备结果。
PreparedShapes.validate_store_changes(store) 返回 ChangeValidation。读取 report.conforms 前先检查 bounded:为真时,报告仅覆盖受影响焦点节点,不对无法到达的旧违规作出断言;为假时,报告覆盖修改后图的完整验证。受限分支的 focus_nodes 为计数,否则为 None;reason 标识需要完整运行的构造。待处理修改由调用方上一次 checkpoint 决定;验证不重新定义该检查点。
规则与节点表达式
shapes.entail 应用形状图的默认规则集,返回基底与推导三元组。它不同于 purrdf.entail.materialize,后者使用蕴涵机制的规则表,不需要形状图。shapes.apply_rules 运行 SRL 文档,仅返回推理图;explain=True 时另有证明文本。check_rules 按所选检查级别准入规则集:level 接受 syntax、well-formed 或 stratified;省略时选择 stratified。它报告声明、导入、版本和分层。存储事实数、连接步数、生成词项数和生成轮数均由显式关键字参数限制;耗尽时引发对应限制的 ValueError。
eval_node_expr 必须恰好选择一个表达式:具名 IRI 或空节点标签,从 expr_at 经 expr_via 的唯一遍历,或只有一个根的内联 expr_turtle 文档。focus 和 scope 提供词项;保留的 focusNode 不能重新绑定。选择器有歧义、遍历步骤缺失或多值以及求值失败都会引发异常。输出为有序 N-Triples 词项字符串,并附有强制诊断。完整契约见 SHACL 与预备产物。
ShEx
purrdf.shex.parse 将 ShExC 或 ShExJ 转换为规范 ShExJ 文本。shex.validate 接受模式、数据和固定形状映射。每个 (node, shape) 对会在 ShexResultEntry 中原样返回,并附有 conformant 和可选 reason。节点可为裸 IRI、尖括号 IRI、_: 标签或 Turtle 字面量标记;START 选择起始形状。模式格式为 shexc 和 shexj;数据格式为 turtle、ntriples 和 nquads。base 解析两个输入中的相对 IRI。被所选 XPath 规则拒绝的模式使该条目不符合;原生资源拒绝则对整个映射引发异常。参见 ShEx。
蕴涵、判定与证明
purrdf.entail.Regime 包含 SIMPLE、RDF、RDFS、OWL_RL、OWL_DIRECT、RIF 和 D;函数也接受命令行的小写拼写。未知拼写会引发异常。materialize 返回 (RdfDataset, report),materialize_nt 返回 (canonical_text, report);报告始终存在。program 为 RIF 文档,其他机制必须传空值。必需的 imports 和 premise_iris 描述前提的导入闭包;[] 表示没有。非绝对前提 IRI、未解析导入和不可达表条目会引发异常,不会被获取或忽略。rules、implemented_rules 和 extensions 分别提供规范规则表、已实现子集和具名非规范扩展。
chase 报告描述规则覆盖情况;OWL Direct-Semantics 服务返回判定证书。规则表不完整与判定耗尽工作上限是两回事。应解包证书并与答案一起保留。
| 服务 | 问题 |
|---|---|
consistency | 知识库是否存在模型;假与未知是不同结果。 |
classify | 具名类等价、传递包含、直接边和不可满足类。 |
realize | 蕴涵的个体类型,以及最具体的直接类型。 |
instances | 以 N-Triples 词项传入一个类,查询其具名实例。 |
entails | 是否蕴涵一个 OWL RDF 映射公理;不同于 graph_entails。 |
profile | OWL 语法配置(profile)的认证与阻碍项,不执行判定搜索。 |
extract_module | 在 bot、top 或 star 下,为种子签名提取局部性模块。 |
justify | 充分且极小的公理子集,并重新判定充分性与极小性。 |
explain_conclusion | 可检查的 chase 推导,不是 tableau 论证。 |
step_cap 和 work_cap 只能收紧判定引擎推导的上限;零表示选择引擎自身的上限,不是零工作。证书报告轮数、工作量、判定次数、峰值节点数、分支次数和深度。预算耗尽为 unknown,不是否定定理。除 consistency 外,判定服务拒绝没有模型的本体,不会把空真蕴涵作为普通答案。未提及的类可以返回空实例答案,不必报错。
entail.Reasoner 保留已解析数据,按需惰性构建知识库,并在对应服务方法间复用两者。上限在构造时固定。proofs=True 启用轨迹,records_proofs 报告该选择。prove 返回答案、证书和证明;proof_services 列出支持的服务名。不记录证明的会话会拒绝证明请求。check_proof 针对调用方的本体、问题、答案和证书检查;未记录的证明绝不会通过验证。空答案或空证书请求较弱的检查,报告会明确说明。论证与执行证明回答不同问题。
certain_answers 查询在所有模型中成立的替换,不只是某个闭包中的匹配。谓词变量及三元组项中的变量可绑定;空节点不是区分变量。应阅读 limit 行以识别未穷尽边界。graph_entails 查询结论图,明确区分蕴涵、不蕴涵和未判定。verify_entailment 根据原样前提复查现有蕴涵证据(warrant)。这些调用要求导入和前提 IRI,并拒绝签名无法表达所需输入的机制。字面量数据类型位置上的变量会被拒绝。
Store.query_entailment_governed 有两个阶段。闭包构建停止时,产生 EntailmentQueryOutcome.phase == "closure-stopped",没有查询结果或闭包报告。否则阶段为 answered,带普通的受治理查询结果和报告。图内关系读取闭包。若 OWL Direct 闭包通过遍历暴露生成的存在见证,则以 reasoning-closure-relation-witness 拒绝。完整服务与证书语法见蕴涵。
地理会话
purrdf.geo.GeoProfile 拥有不可变的严格地理配置;to_json 返回含显式限制的规范版本一记录。GeoSession 接受该配置、另一个会话、配置 JSON 或 None;省略时选择标准 CRS84 配置。profile() 返回所选配置。查询、更新和预备方法通过 geo 接受相同选择。
GeoSession.call 求值严格的标量或批量 JSON 请求;point_index 构建不可变原生点桶并返回 GeoPointIndex,其 call 用相同比较规则精化搜索。语义结果保持规范 JSON;操作性拒绝引发 ValueError。这些路径使用共享 Rust 编解码器,没有 Python 几何实现。参见 GeoSPARQL。
GTS 容器与不可变数据集
GTS 函数既可从包根访问,也归组在 purrdf.gts 中;命名空间别名引用相同操作和类型。gts_from_quads 和 gts_from_rdf12_bytes 按请求的 profile、transform 和 base 将 RDF 字节摄入快照。snapshot_content_id_native 读取对应快照身份。
compile_gts_native 接受基底文档、可选 RDF 1.2 层、命名图及其作用域、文档或报告 blob 和切片产物。签名输入与 rsyncable 阈值是显式编译参数。blob 行携带字节、媒体类型和表示;切片产物行还包含切片 IRI、名称、角色和逻辑路径。必须保留声明的元组位置,不能根据最后一项的类型猜测。
compile_gts_with_report 返回 GtsCompileResult,将 snapshot_bytes 与同一次解析和驻留操作的摄入回执配对。gts_ingest_report 只读取回执。GtsIngestReport 记录 rows_consumed、terms_interned、declarations_omitted 和 scratch_bytes。只有声明的命名图在冻结分发载荷中没有行;其 IRI 会报告为已省略,而不是被静默驻留后改变快照身份。空四元组表不能证明没有丢失声明。feedback_bundle_native 将报告 blob 附加到所提供的 RDF 输入。
RdfDataset 拥有冻结的已解析数据集。其 quad_count、term_count 和长度是检查方法。to_nquads 提供上文所述的规范平面文本;serialize_jsonld 支持声明的 JSON-LD/YAML-LD 选项和已编译上下文。to_gts、columnar_rows 和 to_parquet_files 导出同一个原生载体。字典的数值词项标识符只属于该所有者;跨独立数据集时应解析词项。
frozen = purrdf.RdfDataset(
    '<https://example.org/alice> <https://example.org/name> "Alice" .',
    purrdf.RdfFormat.N_TRIPLES,
)
container = frozen.to_gts()
view = purrdf.GtsFoldViewNative.from_bytes(container)
assert view.quad_count() == 1
alice_id = view.tid_of_iri("https://example.org/alice")
assert alice_id is not None
assert view.public_text(alice_id, "https://example.org/name") == "Alice"
折叠视图与语言选择
GtsFoldViewNative.from_bytes 读取容器;from_parts 准入调用方提供的词项、四元组、具体化节点(reifier)和注解表。两者都以 gts-self-reaching-term 拒绝能够到达自身的词项,不会暴露无限递归的渲染器。curie_prefixes 提供宿主的 CURIE 映射;只有文档列出的 W3C 命名空间是内置的。
四个计数方法报告表大小。term_tuple、is_iri、is_bnode、is_literal、iri、lex、lang、datatype、nq_token 和 python_value 检查本地词项;tid_of_iri 执行反向查找,curie 缩写 IRI。quads、subjects_by_type、objects、value、predicate_objects、has 和 rdf_list 查询所选 scope。reifiers 和 annotations 返回各自的陈述层表。不要把其中的整数 ID 与另一个独立构建视图的 ID 比较。
省略作用域或传 None 时选择默认图。purrdf.GTS_ALL_SCOPE 选择所有图;命名图 IRI 选择该图,未知 IRI 没有匹配行。全图哨兵不是命名图 IRI。
tag_map 和 available_languages 提供视图中的语言选择。public_text 和 public_literal 选择公开值;_with_fallback 形式还接受请求语言,并报告是否使用后备值。public_texts 返回请求的多个选择及该元数据。如果展示依赖于所请求译文是否实际存在,应保留语言和后备字段。
关系式与 Parquet 导出
relational_rows 和 gts_relational_rows_from_bytes 返回 GtsRelationalRows:词项、四元组、具体化节点、注解和 blob;其中 directions 数组与 terms 按位置对应。方向不是附加在位置词项元组末尾的新字段。ColumnarRows 则携带原生 v1 结构和投影后的五表行,其按值排序的稠密标识符不必等于原始 GTS ID。
gts_columnar_rows_from_bytes 返回该投影;gts_columnar_parquet_from_bytes 和 RdfDataset.to_parquet_files 返回文件名到字节的映射。gts_to_sqlite、gts_to_duckdb 和 gts_to_parquet 将五表投影写到指定目标。SQLite 使用标准库,DuckDB 需要其可选依赖组,Parquet 写入使用原生编解码器;PyArrow 是互操作读取器,不是写出器。参见 GTS 与列式配置(profile)。
图与表格投影包
project 接受 RDF 文本或字节、对应 RdfFormat、显式 ProjectionProfile 和严格配置 JSON,返回含所选 profile、确定性 USTAR archive 和结构化 losses 的 ProjectionPackage。每个 ProjectionLoss 包含 code、source、target、note 和可选 location;应检查记录,不要假定每种配置都能往返。可选 assets 输入属于包配置。
配置(profile)为 lpg-csv、neo4j-csv、open-cypher、graphml、csvw-exact、csvw-terms、okf-terms、obo-graphs、skos、croissant-1.1、ro-crate-1.3、datacite-4.6、dcat-3、dcat-rdf、void 和 frictionless-data-package-1。lift 支持 LiftProfile 子集,返回 ProjectionLift.dataset 和损失;把单向配置名传给 lift 不会使它变成双向配置。
流式 LPG 产物通过 project_artifacts 以 (event, path, chunk) 调用产物回调。ArtifactEvent 值界定生命周期:begin-package、begin-artifact、chunk、finish-artifact、commit-package 和 abort-package。只有提交后才能发布保留的产物,并且必须处理中止。可选进度回调接收不可变 ProjectionProgress 快照,包含阶段及节点、边、产物和字节计数。返回的 ProjectionStream 报告配置(profile)与损失。这些是显式产物回调,不同于只接受数据的 SPARQL 关系声明。各配置的严格设置和往返契约见投影。
SSSOM 映射文档
validate_sssom 返回 SssomDiagnostic 字典,包含严重性、错误码、消息、检查项和可选实例。无问题文档返回 [];解析失败返回检查项为 parse 的 FATAL 诊断,不是成功的空验证。sssom_to_rdf 从 TSV 生成 RDF;sssom_roundtrip_tsv 写出已解析的映射文档,sssom_default_validation_types 提供原生默认验证类型。这些是原生 SSSOM 编解码功能,不会导入外部 sssom 包。
切片目录与所有权
purrdf.slice.SliceCatalog.discover(root, namespace) 使用调用方命名空间读取清单。records 包含带清单、清单路径、切片目录和产物记录列表的 SliceRecord 值;core_slice_iris 报告核心成员。ManifestView 提供标识符、切片 IRI、标签、标题、层级、创建者和使用者。ArtifactRecord 提供角色、逻辑路径、媒体类型、原始摘要、语义摘要和内容。
fix_deps() 返回含原始文本和建议文本的 ManifestPatch;调用方决定何时写入这些补丁。OwnershipAnalyzer 在构造时立即执行分析;analyze() 返回保留的 OwnershipReport,analysis_graph_turtle() 序列化分析图。报告提供所有权错误、缺陷标志,以及含来源、目标、语义或物理状态和声明核对结果的 DependencyEdge。这是清单与产物所有权,不是根据目录名推断。参见切片。
排序检索与精确融合
purrdf.retrieval 提供 plan、compile 和 search,以及冷文档检查和融合规则设计查询。plan 不执行查询,只记录规范请求、各分层深度、查询过的统计、生成方决策和未服务词项。compile 准入该计划并生成各分层 SPARQL。search 执行完整的计划、编译、执行和融合流程。Python 没有分别暴露 execute 与 fuse 的流句柄入口。
文本生成方将生成方 IRI 映射到 (stratum, predicate, graph, analyzer)。分析器必须选择 lexicon,并按需要声明文档规定的词典产物或条目、标量限制、重音、词干、输入与投影模式以及子串预算。图选择器为 any、default 或命名图 IRI。可选尾部位置依次为域、索引证明声明和搜索保真度;元组宽度有歧义或不受支持时引发异常。索引证明声明为 (generation, incompleteness),保真度为 (completeness, order);二者描述不同事实。
knn_producers 和 hnsw_producers 在调用方提供的 (IRI, vector) 行上注册精确扫描和近似图搜索,以实体请求作为种子。向量须具有相同的有限宽度和唯一有效 IRI;余弦拒绝零向量。候选与邻居限制均须显式指定且为正。生成方度量为 cosine、negative_dot 和 squared_euclidean。HNSW 还声明 (m, m0, ef_construction, ef_search),并验证 m >= 2、m0 >= m、ef_construction >= m0 和 ef_search >= 1。三个映射不能重复注册生成方 IRI 或分层。调用方还提供统计的 source 与 revision;基数和以百万分比整数表示的选择率是可选的。未知测量值为 None,不是零。
请求是带类型元组的序列;生成方适用性由计划阶段报告,因此写出请求类型并不会为它自动创建生成方。
| 种类 | 元组 |
|---|---|
| 词法 | ("lexical", text, language_or_none, predicate_or_none) |
| 向量 | ("vector", components, metric, hint_or_none),请求度量为 cosine、dot 或 euclidean |
| 空间 | ("spatial", geometry, predicate, max_distance_raw_or_none) |
| 时间 | ("temporal", predicate, lower_or_none, upper_or_none) |
| 数值 | ("numeric", predicate, lower_raw_or_none, upper_raw_or_none) |
| 实体 | ("entity", term),包括用作向量空间种子的 N-Triples IRI 词项 |
候选域要么不受限(None),要么只有一个不同的宿主域标签。空标签或多个不同标签会被拒绝;同一标签的多次重复仍表示一个域。域声明授权排除操作,因此生成方若把某个候选列在不相交域中,就属于错误;不能在分数认证后默默扩大声明。唯一流中重复的候选也会被拒绝。
retrieval = purrdf.retrieval
notes = '''
<https://example.org/a> <https://example.org/note> "the quick brown fox" .
<https://example.org/b> <https://example.org/note> "a quick red fox" .
'''
ranking = retrieval.search(
    notes,
    [("lexical", "quick fox", None, "https://example.org/note")],
    text_producers={
        "https://example.org/pf/search": (
            "https://example.org/stratum/lexical",
            "https://example.org/note", "any", {"lexicon": "empty"},
        )
    },
    weights={"https://example.org/stratum/lexical": retrieval.SCALE},
    statistics={"source": "host-statistics", "revision": "r1"},
    k=60, decay="reciprocal_rank", top_k=10,
)
assert len(ranking["rows"]) == 2
assert isinstance(ranking["rows"][0]["score"], str)
规则、深度与文档检查
权重是以原始定点单位表示的 Python 整数:SCALE 为一个完整单位,SCALE_DIGITS 为其指数。分数和贡献返回精确十进制字符串,绝不是浮点近似。k、decay 和 top_k 均显式指定。reciprocal_rank 先截断倒数再乘权重;weighted_reciprocal_rank 对加权商只舍入一次。两者是不同的内容寻址规则。将原始权重 1 与按 SCALE 倍数表示的权重混用,会使权重比例改变该倍数。
top_k 也是计划输入。在不相交候选域上,它可以在保留答案的同时减少读取。编译单元的 depth 是可报告的行界限;其 SPARQL LIMIT 比该界限多一行,用于探测。不要将探测行报告为值,也不要从查询文本读取界限。declared_rows=None 表示没有声明行数,不是零。调用 compile 时,weights、k 和 decay 必须同时提供或同时省略;没有规则时不会编造排名分辨率声明。
canonical_bytes 和 plan_id 标识计划。certify_plan 检查收到文档中记录的深度推导及所查询统计的投影,不认证外部统计是否最新。explain_depth 读取记录的限制原因,不执行认证。对被拒文档应按 retrieval.PlanDocumentError.refusal 分支。
设计期查询为 weight_for_depth、class_width、deepest_rank_within_width 和 crossing_rank_at,依次查询最小区分权重、某排名的等贡献类宽度、宽度容差内的最深前缀,以及超过融合阈值的首项排名。None 表示可表达排名域内没有有限结果,不是测得的极大数。输入必须满足规则对正权重、排名、平滑参数和容差的约束。宽度容差查询遍历非单调曲线并持有 GIL,应在设计时使用,不放在热点循环中。
读取排名证据
保留三个身份:plan_id 标识问题和计划输入,profile_id 标识融合规则,evidence_id 标识回答所用的索引代次与排除证据。planned_resolution 描述执行前深度;observed_resolution 报告已读取排名、碰撞、排除查找和物化行数。提前认证可使实际工作更少,但这不是对计划的修正。
应结合 fidelities 读取各分层的终止 statuses。exhausted 表示该搜索不再产生行,不表示有损搜索找到了所有可能匹配。depth_reached、row_bound_reached 和 ceiling_reached 是不同停止条件。共享词汇还包括用于更广泛 Rust 生成方与包接口的 supplied_query_ended、execution_failed 和 terms_rejected;不要将它们合并为空结果标志。
attestations 记录索引代次及准入的不完整性;fidelities 独立记录完整或有损搜索、忠实或扰动顺序,以及生成方自身的原因。未声明索引完整性不能证明覆盖整个语料。即使 HNSW 图由所提供向量精确构建,它仍是有损生成方。
exactness 指明缺失、膨胀和无界分层。候选缺失可能使其他候选排名上升,因此降级证据既可能使分数偏高,也可能使其偏低。每行的 interval 量化有界误差,或列出顺序受扰动的分层;certain_prefix 统计在所声明降级下仍保持位置的前导行。unemitted_ceiling 限制答案之外候选可能达到的分数;若顺序扰动使有限界限不可得,则为 None。这些声明涉及成员资格,并不证明每个未返回项都不存在。应将 domains 和 exclusion_bases 与授权跳过流的证据一起保留。参见检索设计。
错误与边界选择
无效配置、资源拒绝、表达式错误和经认证的部分结果是不同结果。若提供结构化诊断属性,应保留它们:message_id 和 presentation 标识原生失败;ShapesImportError.kind、ShapesProductError.dimension 和 PlanDocumentError.refusal 分别是对应的稳定区分字段。不要解析本地化消息文本来判断结果是否完整。未绑定 SELECT 单元格既不是缺失列,也不一定是异常。
迁移 rdflib 使用方时,请阅读 rdflib 兼容章节。query_rdflib 接受其命名图与默认图控制,原生入口保留这里所述的契约。单独的 purrdf-rdflib 替身发行包占用 rdflib 导入名,不能与真正的 rdflib 共享环境。公开调用直接通过 purrdf,不要使用内部 purrdf_native 扩展模块。
Python API 签名
本参考页记录权威 Python stub 中的每个声明,包括类、属性、重载、类型别名和命名空间成员。它描述公开包;下划线名称也声明公开签名使用的辅助类型,但不保证这些类型的构造器可以单独导入。
已安装包的签名测试用 Python 语法树比较两个完整清单,因此参数种类、注解、默认值、重载和属性装饰器不能悄悄偏离。配套的原生参数比较覆盖引擎命名空间;仅清单一致并不能证明每个原生可调用对象都实现了声明的签名。
用法见 Python 入门,语义契约见其中链接的引擎章节。本参考页在所有语言中都保留 Python 标识符。
__init__.pyi
from __future__ import annotations
import builtins
from collections.abc import Iterator, Mapping, Sequence
from types import CapsuleType
from typing import IO, Any, Callable, Required, TypeAlias, TypedDict, overload
from typing import Literal as TypingLiteral
from . import geo as geo
type GeoConfiguration = geo.GeoProfile | geo.GeoSession | str | None
def project_statements_rdf12(owl_ttl: str) -> str:
...
def normalize_rdf12_to_owl(rdf12_ttl: str) -> str:
...
def loss_matrix_json() -> str:
...
def rdf_gts_loss_matrix_json() -> str:
...
def canonicalize_turtle(turtle_bytes: bytes, extra_prefixes: list[tuple[str, str]]=...) -> bytes:
...
XPATH_REGEX_PROFILES: tuple[str, ...]
type ProjectionProfile = TypingLiteral['lpg-csv', 'neo4j-csv', 'open-cypher', 'graphml', 'csvw-exact', 'csvw-terms', 'okf-terms', 'obo-graphs', 'skos', 'croissant-1.1', 'ro-crate-1.3', 'datacite-4.6', 'dcat-3', 'dcat-rdf', 'void', 'frictionless-data-package-1']
type LiftProfile = TypingLiteral['lpg-csv', 'neo4j-csv', 'open-cypher', 'graphml', 'csvw-exact', 'croissant-1.1', 'ro-crate-1.3', 'datacite-4.6', 'dcat-3', 'frictionless-data-package-1']
type ArtifactEvent = TypingLiteral['begin-package', 'begin-artifact', 'chunk', 'finish-artifact', 'commit-package', 'abort-package']
class ProjectionLoss:
@property
def code(self) -> str:
...
@property
def source(self) -> str:
...
@property
def target(self) -> str:
...
@property
def note(self) -> str:
...
@property
def location(self) -> str | None:
...
class ProjectionPackage:
@property
def profile(self) -> str:
...
@property
def archive(self) -> bytes:
...
@property
def losses(self) -> list[ProjectionLoss]:
...
class ProjectionProgress:
@property
def phase(self) -> str:
...
@property
def input_records(self) -> int:
...
@property
def model_records(self) -> int:
...
@property
def nodes(self) -> int:
...
@property
def edges(self) -> int:
...
@property
def artifacts(self) -> int:
...
@property
def bytes(self) -> int:
...
@property
def path(self) -> str | None:
...
class ProjectionStream:
@property
def profile(self) -> str:
...
@property
def losses(self) -> list[ProjectionLoss]:
...
@property
def input_records(self) -> int:
...
@property
def model_records(self) -> int:
...
@property
def nodes(self) -> int:
...
@property
def edges(self) -> int:
...
class ProjectionLift:
@property
def dataset(self) -> RdfDataset:
...
@property
def losses(self) -> list[ProjectionLoss]:
...
def project(data: bytes | str, *, format: RdfFormat, profile: ProjectionProfile, config: bytes | str, assets: bytes | None=...) -> ProjectionPackage:
...
def project_artifacts(data: bytes | str, *, format: RdfFormat, profile: TypingLiteral['lpg-csv', 'neo4j-csv', 'open-cypher', 'graphml'], config: bytes | str, artifact_callback: Callable[[ArtifactEvent, str | None, bytes], None], progress_callback: Callable[[ProjectionProgress], None] | None=...) -> ProjectionStream:
...
def lift(archive: bytes, *, profile: LiftProfile, config: bytes | str) -> ProjectionLift:
...
class RdfFormat:
TURTLE: RdfFormat
N_TRIPLES: RdfFormat
N_QUADS: RdfFormat
TRIG: RdfFormat
TRIX: RdfFormat
HEXTUPLES: RdfFormat
JSON_LD: RdfFormat
YAML_LD: RdfFormat
RDF_XML: RdfFormat
class CompiledJsonLdContext:
def __init__(self, options_json: str) -> None:
...
@staticmethod
def from_prefixes(prefixes: dict[str, str]) -> CompiledJsonLdContext:
...
def canonical_context_json(self) -> str:
...
class CanonicalizationAlgorithm:
RDFC_1_0: CanonicalizationAlgorithm
UNSTABLE: CanonicalizationAlgorithm
class NamedNode:
def __init__(self, value: str) -> None:
...
@property
def value(self) -> str:
...
def __hash__(self) -> int:
...
def __eq__(self, other: object) -> bool:
...
class BlankNode:
def __init__(self, value: str) -> None:
...
@property
def value(self) -> str:
...
def __hash__(self) -> int:
...
def __eq__(self, other: object) -> bool:
...
class Literal:
def __init__(self, value: str, *, datatype: NamedNode | None=..., language: str | None=..., direction: str | None=...) -> None:
...
@property
def value(self) -> str:
...
@property
def language(self) -> str | None:
...
@property
def direction(self) -> str | None:
...
@property
def datatype(self) -> NamedNode:
...
def __hash__(self) -> int:
...
def __eq__(self, other: object) -> bool:
...
class Triple:
def __init__(self, subject: _Subject, predicate: NamedNode, object: _Term) -> None:
...
@property
def subject(self) -> _Subject:
...
@property
def predicate(self) -> NamedNode:
...
@property
def object(self) -> _Term:
...
def __hash__(self) -> int:
...
def __eq__(self, other: builtins.object) -> bool:
...
class DefaultGraph:
def __init__(self) -> None:
...
class Quad:
def __init__(self, subject: _Subject, predicate: NamedNode, object: _Term, graph_name: NamedNode | BlankNode | DefaultGraph | None=...) -> None:
...
@property
def subject(self) -> _Subject:
...
@property
def predicate(self) -> NamedNode:
...
@property
def object(self) -> _Term:
...
@property
def graph_name(self) -> NamedNode | BlankNode | DefaultGraph:
...
def __hash__(self) -> int:
...
def __eq__(self, other: builtins.object) -> bool:
...
class Variable:
def __init__(self, value: str) -> None:
...
@property
def value(self) -> str:
...
def __hash__(self) -> int:
...
def __eq__(self, other: object) -> bool:
...
_Subject = NamedNode | BlankNode
_Term = NamedNode | BlankNode | Literal | Triple
_Attestation = tuple[str | None, str | None]
_Relation = tuple[int, int, Sequence[Sequence[_Term]]] | tuple[int, int, Sequence[Sequence[_Term]], _Attestation]
_RelationFromGraph = tuple[_Term, int, int] | tuple[_Term, int, int, _Attestation]
_PathStep = tuple[_Term, str]
_PathRelation = tuple[Sequence[_PathStep], int, int, int, int, str] | tuple[Sequence[_PathStep], int, int, int, int, str, _Attestation]
class QuerySolution:
def __getitem__(self, key: str | Variable | int) -> _Term | None:
...
def __len__(self) -> int:
...
def __iter__(self) -> Iterator[_Term | None]:
...
class _QuerySolutionIterator:
def __iter__(self) -> _QuerySolutionIterator:
...
def __next__(self) -> _Term | None:
...
def __length_hint__(self) -> int:
...
class QuerySolutions:
@property
def variables(self) -> list[Variable]:
...
def __iter__(self) -> QuerySolutions:
...
def __next__(self) -> QuerySolution:
...
def __len__(self) -> int:
...
class QueryTriples:
def __iter__(self) -> QueryTriples:
...
def __next__(self) -> Triple:
...
def __len__(self) -> int:
...
def serialize(self, format: RdfFormat, *, base: str | None=...) -> bytes:
...
class QueryQuads:
def __iter__(self) -> QueryQuads:
...
def __next__(self) -> Quad:
...
def __len__(self) -> int:
...
@property
def graph_names(self) -> list[str]:
...
def serialize(self, format: RdfFormat) -> bytes:
...
class SerializeLoss:
@property
def bytes(self) -> bytes:
...
@property
def statement_rows_dropped(self) -> int:
...
@property
def directional_literals_dropped(self) -> int:
...
@property
def named_graph_rows_dropped(self) -> int:
...
@property
def empty_named_graphs_dropped(self) -> int:
...
class QueryBoolean:
def __bool__(self) -> bool:
...
type GovernorKind = TypingLiteral['budget', 'stopped', 'refused', 'unknown']
type PartialCertainty = TypingLiteral['certain', 'at-most', 'unknown']
class CancellationToken:
def __init__(self) -> None:
...
def cancel(self) -> None:
...
@property
def cancelled(self) -> bool:
...
class TrippedGovernor:
@property
def kind(self) -> GovernorKind:
...
@property
def label(self) -> str:
...
@property
def dimension(self) -> str | None:
...
@property
def limit(self) -> int | None:
...
@property
def consumed(self) -> int | None:
...
@property
def estimate(self) -> int | None:
...
@property
def cause(self) -> str | None:
...
def __str__(self) -> str:
...
class GovernorEvidence:
@property
def consumed(self) -> dict[str, int]:
...
@property
def limits(self) -> dict[str, int]:
...
@property
def tripped(self) -> TrippedGovernor | None:
...
@property
def is_complete(self) -> bool:
...
@property
def expression_errors(self) -> dict[str, int]:
...
def consumed_in(self, dimension: str) -> int:
...
def limit_for(self, dimension: str) -> int:
...
class PartialAnswers:
@property
def certainty(self) -> PartialCertainty:
...
@property
def is_certain(self) -> bool:
...
@property
def result(self) -> QuerySolutions | QueryTriples | QueryQuads | QueryBoolean | None:
...
@property
def is_positional_prefix(self) -> bool | None:
...
@property
def barrier(self) -> str | None:
...
class RelationAttestations(TypedDict):
invocations: int
generations: list[str | None]
incompleteness: list[str]
class QueryOutcome:
@property
def is_complete(self) -> bool:
...
@property
def result(self) -> QuerySolutions | QueryTriples | QueryQuads | QueryBoolean | None:
...
@property
def partial(self) -> PartialAnswers | None:
...
@property
def tripped(self) -> TrippedGovernor | None:
...
@property
def evidence(self) -> GovernorEvidence:
...
@property
def relation_witness(self) -> dict[str, RelationAttestations]:
...
class EntailmentQueryOutcome:
@property
def phase(self) -> TypingLiteral['answered', 'closure-stopped']:
...
@property
def is_complete(self) -> bool:
...
@property
def outcome(self) -> QueryOutcome | None:
...
@property
def report(self) -> str | None:
...
@property
def tripped(self) -> TrippedGovernor | None:
...
class UpdateOutcome:
@property
def is_applied(self) -> bool:
...
@property
def tripped(self) -> TrippedGovernor | None:
...
@property
def evidence(self) -> GovernorEvidence:
...
class PreparedQuery:
@property
def parameters(self) -> list[str]:
...
def run(self, **bindings: _Term) -> QuerySolutions | QueryTriples | QueryQuads | QueryBoolean:
...
class QuadIter:
def __iter__(self) -> QuadIter:
...
def __next__(self) -> Quad:
...
class _QuadStore:
def __iter__(self) -> QuadIter:
...
def add_graph(self, graph: NamedNode | BlankNode, *, silent: bool=False) -> None:
...
def named_graphs(self) -> list[NamedNode | BlankNode]:
...
def query(self, query: str, *, substitutions: dict[Variable, _Term] | None=..., extension_namespaces: list[str] | None=..., property_fn_namespaces: list[str] | None=..., standpoint_predicates: tuple[str, str] | None=..., relations: dict[str, _Relation] | None=..., relations_from_graph: dict[str, _RelationFromGraph] | None=..., path_relations: dict[str, _PathRelation] | None=..., aggregate_namespace: str | None=..., xpath_regex: str | None=..., geo: GeoConfiguration=..., division: str | None=...) -> QuerySolutions | QueryTriples | QueryQuads | QueryBoolean:
...
def query_rdflib(self, query: str, *, substitutions: dict[Variable, _Term] | None=..., extension_namespaces: list[str] | None=..., property_fn_namespaces: list[str] | None=..., standpoint_predicates: tuple[str, str] | None=..., relations: dict[str, _Relation] | None=..., relations_from_graph: dict[str, _RelationFromGraph] | None=..., path_relations: dict[str, _PathRelation] | None=..., aggregate_namespace: str | None=..., xpath_regex: str | None=..., geo: GeoConfiguration=..., division: str | None=..., named_graphs: bool=..., default_graph: NamedNode | BlankNode | None=..., default_union: bool=...) -> QuerySolutions | QueryTriples | QueryQuads | QueryBoolean:
...
def query_governed(self, query: str, *, substitutions: dict[Variable, _Term] | None=..., extension_namespaces: list[str] | None=..., property_fn_namespaces: list[str] | None=..., standpoint_predicates: tuple[str, str] | None=..., relations: dict[str, _Relation] | None=..., relations_from_graph: dict[str, _RelationFromGraph] | None=..., path_relations: dict[str, _PathRelation] | None=..., aggregate_namespace: str | None=..., xpath_regex: str | None=..., geo: GeoConfiguration=..., division: str | None=..., fuel: int | None=..., deadline_ms: int | None=..., max_answers: int | None=..., max_intermediate_cells: int | None=..., max_scratch_bytes: int | None=..., max_remote_requests: int | None=..., no_ceiling: bool=False, cancel: CancellationToken | None=...) -> QueryOutcome:
...
def query_entailment_governed(self, query: str, entailment: str, *, program: str=..., imports: Sequence[tuple[str, str]] | None=..., premise_iris: Sequence[str] | None=..., max_stored_facts: int | None=..., max_join_steps: int | None=..., max_term_arena_bytes: int | None=..., substitutions: dict[Variable, _Term] | None=..., extension_namespaces: list[str] | None=..., property_fn_namespaces: list[str] | None=..., standpoint_predicates: tuple[str, str] | None=..., relations: dict[str, _Relation] | None=..., relations_from_graph: dict[str, _RelationFromGraph] | None=..., path_relations: dict[str, _PathRelation] | None=..., aggregate_namespace: str | None=..., xpath_regex: str | None=..., geo: GeoConfiguration=..., division: str | None=..., fuel: int | None=..., deadline_ms: int | None=..., max_answers: int | None=..., max_intermediate_cells: int | None=..., max_scratch_bytes: int | None=..., max_remote_requests: int | None=..., no_ceiling: bool=False, cancel: CancellationToken | None=...) -> EntailmentQueryOutcome:
...
def update(self, update: str, *, extension_namespaces: list[str] | None=..., property_fn_namespaces: list[str] | None=..., standpoint_predicates: tuple[str, str] | None=..., relations: dict[str, _Relation] | None=..., relations_from_graph: dict[str, _RelationFromGraph] | None=..., path_relations: dict[str, _PathRelation] | None=..., aggregate_namespace: str | None=..., xpath_regex: str | None=..., geo: GeoConfiguration=..., division: str | None=...) -> None:
...
def update_governed(self, update: str, *, extension_namespaces: list[str] | None=..., property_fn_namespaces: list[str] | None=..., standpoint_predicates: tuple[str, str] | None=..., relations: dict[str, _Relation] | None=..., relations_from_graph: dict[str, _RelationFromGraph] | None=..., path_relations: dict[str, _PathRelation] | None=..., aggregate_namespace: str | None=..., xpath_regex: str | None=..., geo: GeoConfiguration=..., division: str | None=..., fuel: int | None=..., deadline_ms: int | None=..., max_intermediate_cells: int | None=..., max_scratch_bytes: int | None=..., max_remote_requests: int | None=..., no_ceiling: bool=False, cancel: CancellationToken | None=...) -> UpdateOutcome:
...
def dump_with_loss(self, format: RdfFormat) -> SerializeLoss:
...
def __len__(self) -> int:
...
def _store_capsule(self) -> CapsuleType:
...
class Store(_QuadStore):
def __init__(self, *, remember_empty_graphs: bool=True) -> None:
...
def load(self, input: bytes | str | None=..., format: RdfFormat | None=..., *, path: str | None=..., base: str | None=...) -> list[tuple[str, str]]:
...
def bulk_load(self, input: bytes | str | None=..., format: RdfFormat | None=..., *, path: str | None=..., base: str | None=...) -> list[tuple[str, str]]:
...
def add(self, quad: Quad) -> None:
...
def remove(self, quad: Quad) -> None:
...
def checkpoint(self) -> None:
...
def change_size(self) -> tuple[int, int]:
...
def prepare(self, query: str, *, parameters: list[str] | None=..., extension_namespaces: list[str] | None=..., property_fn_namespaces: list[str] | None=..., standpoint_predicates: tuple[str, str] | None=..., relations: dict[str, _Relation] | None=..., relations_from_graph: dict[str, _RelationFromGraph] | None=..., path_relations: dict[str, _PathRelation] | None=..., aggregate_namespace: str | None=..., xpath_regex: str | None=..., geo: GeoConfiguration=..., division: str | None=...) -> PreparedQuery:
...
@overload
def dump(self, output: IO[bytes], format: RdfFormat, *, from_graph: NamedNode | BlankNode | DefaultGraph | None=..., jsonld_options: str | None=..., jsonld_context: CompiledJsonLdContext | None=..., yaml_schema_url: str | None=..., base: str | None=...) -> None:
...
@overload
def dump(self, output: None=..., *, format: RdfFormat, from_graph: NamedNode | BlankNode | DefaultGraph | None=..., jsonld_options: str | None=..., jsonld_context: CompiledJsonLdContext | None=..., yaml_schema_url: str | None=..., base: str | None=...) -> bytes:
...
class MutableDataset(_QuadStore):
def __init__(self, *, remember_empty_graphs: bool=True) -> None:
...
def load(self, input: bytes | str | None=..., format: RdfFormat | None=..., *, path: str | None=..., base: str | None=...) -> list[tuple[str, str]]:
...
def add(self, quad: Quad) -> bool:
...
def remove(self, quad: Quad) -> bool:
...
def contains(self, quad: Quad) -> bool:
...
def quads_for_pattern(self, subject: _Subject | None=..., predicate: NamedNode | None=..., object: _Term | None=..., graph_name: NamedNode | BlankNode | DefaultGraph | None=..., *, any_graph: bool=...) -> list[Quad]:
...
@overload
def dump(self, output: IO[bytes], format: RdfFormat, *, from_graph: NamedNode | BlankNode | DefaultGraph | None=..., jsonld_options: str | None=..., jsonld_context: CompiledJsonLdContext | None=..., yaml_schema_url: str | None=..., base: str | None=...) -> None:
...
@overload
def dump(self, output: None=..., *, format: RdfFormat, from_graph: NamedNode | BlankNode | DefaultGraph | None=..., jsonld_options: str | None=..., jsonld_context: CompiledJsonLdContext | None=..., yaml_schema_url: str | None=..., base: str | None=...) -> bytes:
...
def compact(self) -> None:
...
class Dataset:
def __init__(self, quads: object | None=...) -> None:
...
def add(self, quad: Quad) -> None:
...
def canonicalize(self, algorithm: CanonicalizationAlgorithm) -> None:
...
def __iter__(self) -> QuadIter:
...
def __len__(self) -> int:
...
def parse(input: bytes | str, format: RdfFormat, *, base: str | None=...) -> list[Quad]:
...
@overload
def serialize(input: QueryTriples | QueryQuads, output: IO[bytes], format: RdfFormat, *, base: str | None=...) -> None:
...
@overload
def serialize(input: QueryTriples | QueryQuads, output: None=..., *, format: RdfFormat, base: str | None=...) -> bytes:
...
def xsd_value_compare(left_lexical: str, left_datatype: str, right_lexical: str, right_datatype: str) -> int | None:
...
def xsd_canonical_lexical(lexical: str, datatype: str) -> str | None:
...
def xsd_decode_binary(lexical: str, datatype: str) -> bytes | None:
...
def xsd_normalize_whitespace(lexical: str, datatype: str) -> str | None:
...
_ResultRow = list[_Term | None]
_ProvenanceNamespace = tuple[str, str]
type SparqlResultsFormat = TypingLiteral['json', 'srj', 'sparql-json', 'application/sparql-results+json', 'xml', 'sparql-xml', 'application/sparql-results+xml', 'csv', 'text/csv', 'tsv', 'text/tab-separated-values']
def serialize_sparql_solutions(format: SparqlResultsFormat | str, variables: list[str], rows: list[_ResultRow], *, provenance_namespace: _ProvenanceNamespace | None=..., query_hash: str | None=...) -> bytes:
...
def serialize_sparql_boolean(format: SparqlResultsFormat | str, value: bool, *, provenance_namespace: _ProvenanceNamespace | None=..., query_hash: str | None=...) -> bytes:
...
def parse_sparql_results(format: SparqlResultsFormat | str, data: bytes) -> tuple[Any, ...]:
...
_ProvenanceDict = dict[str, str | None]
def provenance_from_json(data: bytes, prefix: str, iri: str) -> _ProvenanceDict:
...
def provenance_from_xml(data: bytes, prefix: str, iri: str) -> _ProvenanceDict:
...
_BlobRow = tuple[bytes, str, str]
_SliceArtifactRow = tuple[str, str, str, str, bytes]
_NamedGraphRow = tuple[bytes, RdfFormat, str | None, str | None]
def gts_from_quads(data: bytes, *, format: RdfFormat, profile: str=..., transform: list[str] | None=..., base: str | None=...) -> bytes:
...
def gts_from_rdf12_bytes(data: bytes, *, format: RdfFormat, profile: str=..., transform: list[str] | None=..., base: str | None=...) -> bytes:
...
def compile_gts_native(base_data: bytes, base_format: RdfFormat, *, base_scope: str | None=..., rdf12_data: bytes | None=..., rdf12_format: RdfFormat | None=..., rdf12_graph_name: str | None=..., rdf12_scope: str | None=..., named_graphs: list[_NamedGraphRow] | None=..., transform: list[str] | None=..., doc_blobs: list[_BlobRow] | None=..., report_blobs: list[_BlobRow] | None=..., slice_artifacts: list[_SliceArtifactRow] | None=..., signer_secret: bytes | None=..., signer_kid: str | None=..., public_key_armor: str | None=..., rsyncable_threshold: int=..., base: str | None=...) -> bytes:
...
def snapshot_content_id_native(data: bytes, *, format: RdfFormat, base: str | None=...) -> str:
...
class GtsIngestReport(TypedDict):
rows_consumed: int
terms_interned: int
declarations_omitted: list[str]
scratch_bytes: int
def gts_ingest_report(base_data: bytes, base_format: RdfFormat, *, base_scope: str | None=..., rdf12_data: bytes | None=..., rdf12_format: RdfFormat | None=..., rdf12_graph_name: str | None=..., rdf12_scope: str | None=..., named_graphs: list[_NamedGraphRow] | None=..., base: str | None=...) -> GtsIngestReport:
...
class GtsCompileResult(TypedDict):
snapshot_bytes: bytes
ingest_report: GtsIngestReport
def compile_gts_with_report(base_data: bytes, base_format: RdfFormat, *, base_scope: str | None=..., rdf12_data: bytes | None=..., rdf12_format: RdfFormat | None=..., rdf12_graph_name: str | None=..., rdf12_scope: str | None=..., named_graphs: list[_NamedGraphRow] | None=..., transform: list[str] | None=..., doc_blobs: list[_BlobRow] | None=..., report_blobs: list[_BlobRow] | None=..., slice_artifacts: list[_SliceArtifactRow] | None=..., signer_secret: bytes | None=..., signer_kid: str | None=..., public_key_armor: str | None=..., rsyncable_threshold: int=..., base: str | None=...) -> GtsCompileResult:
...
def to_json_ld(data: bytes, *, format: RdfFormat, options_json: str | None=..., context: CompiledJsonLdContext | None=..., base: str | None=...) -> str:
...
def serialize_jsonld(data: bytes, *, format: RdfFormat, output_format: str, options_json: str | None=..., context: CompiledJsonLdContext | None=..., yaml_schema_url: str | None=...) -> str:
...
def from_json_ld(text: str, *, statement_vocab: dict[str, str] | None=..., base: str | None=...) -> bytes:
...
def to_rdf_xml(data: bytes, *, format: RdfFormat, base: str | None=...) -> str:
...
def from_rdf_xml(text: str, *, base: str | None=...) -> bytes:
...
def feedback_bundle_native(data: bytes, *, format: RdfFormat, report_blobs: list[_BlobRow] | None=..., base: str | None=...) -> bytes:
...
_TermRow = tuple[int, int, str | None, int | None, str | None, int | None, tuple[int, int, int] | None]
_QuadRow = tuple[int, int, int, int | None]
_ReifierRow = tuple[int, int, int, int, int | None]
_AnnotationRow = tuple[int, int, int, int | None]
_FoldReifierRow = tuple[int, tuple[int, int, int], int | None]
_BlobExportRow = tuple[str, bytes]
_InputTermRow = tuple[int, str | None, int | None, str | None, str | None, int | None, tuple[int, int, int] | None]
GTS_ALL_SCOPE: str
class GtsRelationalRows(TypedDict):
terms: list[_TermRow]
directions: list[str | None]
quads: list[_QuadRow]
reifiers: list[_ReifierRow]
annotations: list[_AnnotationRow]
blobs: list[_BlobExportRow]
class GtsFoldViewNative:
@staticmethod
def from_bytes(data: bytes, curie_prefixes: list[tuple[str, str]]=...) -> GtsFoldViewNative:
...
@staticmethod
def from_parts(terms: list[_InputTermRow], quads: list[_QuadRow], reifiers: list[_FoldReifierRow], annotations: list[_AnnotationRow], curie_prefixes: list[tuple[str, str]]=...) -> GtsFoldViewNative:
...
def term_count(self) -> int:
...
def quad_count(self) -> int:
...
def reifier_count(self) -> int:
...
def annotation_count(self) -> int:
...
def term_tuple(self, tid: int) -> _InputTermRow:
...
def is_iri(self, tid: int) -> bool:
...
def is_bnode(self, tid: int) -> bool:
...
def is_literal(self, tid: int) -> bool:
...
def iri(self, tid: int) -> str | None:
...
def lex(self, tid: int) -> str:
...
def lang(self, tid: int) -> str | None:
...
def datatype(self, tid: int) -> str:
...
def nq_token(self, tid: int) -> str:
...
def python_value(self, tid: int) -> object:
...
def tid_of_iri(self, iri: str) -> int | None:
...
def curie(self, iri: str) -> str:
...
def quads(self, scope: str | None=...) -> list[_QuadRow]:
...
def subjects_by_type(self, class_iri: str, scope: str | None=...) -> list[int]:
...
def objects(self, s_tid: int, p_iri: str, scope: str | None=...) -> list[int]:
...
def value(self, s_tid: int, p_iri: str, scope: str | None=...) -> int | None:
...
def predicate_objects(self, s_tid: int, scope: str | None=...) -> list[tuple[int, int]]:
...
def has(self, s_tid: int, p_iri: str, o_tid: int, scope: str | None=...) -> bool:
...
def rdf_list(self, head_tid: int, scope: str | None=...) -> list[int]:
...
def reifiers(self) -> list[_FoldReifierRow]:
...
def annotations(self) -> list[_AnnotationRow]:
...
def tag_map(self) -> dict[str, str]:
...
def available_languages(self) -> list[str]:
...
def public_text(self, s_tid: int, p_iri: str, scope: str | None=...) -> str:
...
def public_literal(self, s_tid: int, p_iri: str, scope: str | None=...) -> tuple[str, str | None]:
...
def public_literal_with_fallback(self, s_tid: int, p_iri: str, requested: list[str], scope: str | None=...) -> tuple[str, str | None, bool]:
...
def public_text_with_fallback(self, s_tid: int, p_iri: str, requested: list[str], scope: str | None=...) -> tuple[str, bool]:
...
def public_texts(self, s_tid: int, p_iri: str, requested: list[str], scope: str | None=...) -> list[tuple[str, str | None, bool]]:
...
def relational_rows(self) -> GtsRelationalRows:
...
def gts_relational_rows_from_bytes(data: bytes) -> GtsRelationalRows:
...
class ColumnarRows(TypedDict):
schema: dict[str, list[tuple[str, str, bool]]]
terms: list[tuple[int | str | bytes | None, ...]]
quads: list[tuple[int | str | bytes | None, ...]]
reifiers: list[tuple[int | str | bytes | None, ...]]
annotations: list[tuple[int | str | bytes | None, ...]]
blobs: list[tuple[int | str | bytes | None, ...]]
def gts_columnar_rows_from_bytes(data: bytes) -> ColumnarRows:
...
def gts_columnar_parquet_from_bytes(data: bytes) -> dict[str, bytes]:
...
def gts_to_sqlite(data: bytes, path: str) -> str:
...
def gts_to_duckdb(data: bytes, path: str) -> str:
...
def gts_to_parquet(data: bytes, out_dir: str) -> list[str]:
...
class RdfDataset:
def __init__(self, data: bytes | str, format: RdfFormat, *, base: str | None=...) -> None:
...
def quad_count(self) -> int:
...
def term_count(self) -> int:
...
def __len__(self) -> int:
...
def to_nquads(self) -> str:
...
def serialize_jsonld(self, output_format: str, *, options_json: str | None=..., context: CompiledJsonLdContext | None=..., yaml_schema_url: str | None=...) -> str:
...
def to_gts(self, profile: str=...) -> bytes:
...
def columnar_rows(self) -> ColumnarRows:
...
def to_parquet_files(self) -> dict[str, bytes]:
...
class SssomDiagnostic(TypedDict):
severity: str
code: str
message: str
check: str
instance: str | None
def validate_sssom(text: str) -> list[SssomDiagnostic]:
...
def sssom_to_rdf(text: str) -> str:
...
def sssom_roundtrip_tsv(text: str) -> str:
...
def sssom_default_validation_types() -> list[str]:
...
class ShexResultEntry(TypedDict):
"""One fixed-shape-map verdict: the input `(node, shape)` echoed verbatim."""
node: str
shape: str
conformant: bool
reason: str | None
class shex:
@staticmethod
def validate(schema: str, data: str, map: list[tuple[str, str]], *, schema_format: str=..., data_format: str=..., base: str | None=..., xpath_regex: str | None=...) -> list[ShexResultEntry]:
...
@staticmethod
def parse(schema: str, *, format: str=..., base: str | None=...) -> str:
...
class _ValidationReport:
"""A SHACL validation report."""
@property
def conforms(self) -> bool:
...
@property
def shapes_graph_well_formed(self) -> bool | None:
...
@property
def diagnostics(self) -> list[dict[str, str]]:
...
@property
def results(self) -> list[dict[str, builtins.object]]:
...
def to_ntriples(self) -> str:
...
def to_sarif(self) -> str:
...
class _Shapes:
"""Parsed SHACL shapes, reusable across many data graphs."""
def __init__(self, shapes_ttl: str, *, base: str | None=None, imports: Sequence[tuple[str, str]]=..., shapes_graph: str | None=None, subclass_of_in_shapes_graph: bool=False, shacl_profile: str | None=None) -> None:
...
def validate_nt(self, data_nt: str, *, xpath_regex: str | None=None) -> _ValidationReport:
...
def validate_store(self, data: Store | MutableDataset, *, xpath_regex: str | None=None) -> _ValidationReport:
...
def prepare(self) -> _PreparedShapes:
...
def extension_usage(self, *, relation_iris: Sequence[str] | None=None, relation_namespaces: Sequence[str] | None=None, extension_namespaces: Sequence[str] | None=None) -> dict[str, Any]:
...
class _ShapesProductError(ValueError):
"""A refusal from the prepared-shapes-product admission boundary.
`dimension` is one of the codec's pinned kebab-case labels, or `None` when the
failure happened before any product existed (a shapes or data document that did
not parse was never admitted). Branch on it, never on `str(exc)`.
"""
dimension: str | None
class _ShapesImportError(ValueError):
"""A shapes graph's `owl:imports` closure is not in hand, or the `imports` table
cannot be used — the one refusal every shapes-graph entry point raises, on every
PurRDF host alike.
`kind` is `unresolved-import` (pass the named documents in `imports`),
`unreached-import` (a table entry neither an import nor a data-graph link names),
`invalid-import` (a key that is not an absolute IRI, a key named twice, or a
document that is not Turtle), `incompatible-import-versions` (the closure holds two
versions of one series, or a graph another declares `owl:incompatibleWith`, SHACL
1.2 Core sections 1.3 and 6.1 — `iris` are the conflicting documents),
`unresolved-shapes-graph-link` (the data graph links a
graph with `sh:shapesGraph`, SHACL 1.2 Core section 6.4, that nothing in hand
resolves — pass it in `imports`) or `invalid-shapes-graph-link` (a data-graph
`sh:shapesGraph` value that is not an IRI); `iris` are the IRIs (or values) it
names. Branch on `kind`, never on `str(exc)`.
A shapes graph prepared before the data graph was known (`Shapes`,
`PreparedShapes`, a product) cannot take a linked graph in: validating a data graph
that links one it does not hold — one that is not its base, a document its import
closure absorbed, or a graph it declares — raises this class with kind
`unheld-shapes-graph-link`.
"""
kind: str
iris: list[str]
class _PreparedShapes:
"""An immutable shape preparation, reusable across data graphs and writable as
a prepared product."""
def to_product(self) -> bytes:
...
def provenance(self) -> str:
...
def validate_nt(self, data_nt: str, *, xpath_regex: str | None=None) -> _ValidationReport:
...
def validate_store_changes(self, store: Store, *, xpath_regex: str | None=None) -> _ChangeValidation:
...
class _ChangeValidation:
"""The outcome of `PreparedShapes.validate_store_changes`: the report, plus the
SCOPE the report describes.
Two facts rather than one, because a `ValidationReport` alone cannot say which
question it answered. Read `bounded` first.
"""
@property
def report(self) -> _ValidationReport:
...
@property
def bounded(self) -> bool:
...
@property
def focus_nodes(self) -> int | None:
...
@property
def reason(self) -> str | None:
...
class _ShapesProduct:
"""A prepared product whose envelope is verified and whose self-description is
decoded — but which has NOT been admitted."""
@staticmethod
def open(data: bytes) -> _ShapesProduct:
...
def to_bytes(self) -> bytes:
...
def explain(self) -> str:
...
def format_version(self) -> int:
...
def stage_id(self) -> str:
...
def stage_known(self) -> bool:
...
def identity_digest(self) -> str:
...
def identity_components(self) -> list[tuple[str, str]]:
...
def admit(self) -> _PreparedShapes:
...
def admit_expecting(self, expected_identity: str) -> _PreparedShapes:
...
def rebuild(self) -> _PreparedShapes:
...
def rebuild_expecting(self, expected_identity: str) -> _PreparedShapes:
...
def certify(self) -> None:
...
class shapes:
ValidationReport: TypeAlias = _ValidationReport
Shapes: TypeAlias = _Shapes
PreparedShapes: TypeAlias = _PreparedShapes
ChangeValidation: TypeAlias = _ChangeValidation
ShapesProduct: TypeAlias = _ShapesProduct
ShapesProductError: TypeAlias = _ShapesProductError
ShapesImportError: TypeAlias = _ShapesImportError
@staticmethod
def pack_product(shapes_ttl: str, *, shapes_base: str | None=None, imports: Sequence[tuple[str, str]]=..., shapes_graph: str | None=None) -> bytes:
...
@staticmethod
def validate(shapes_ttl: str, data_nt: str, *, shapes_base: str | None=None, conformance_disallows: Sequence[str] | None=None, imports: Sequence[tuple[str, str]]=..., shapes_graph: str | None=None, subclass_of_in_shapes_graph: bool=False, xpath_regex: str | None=None, shacl_profile: str | None=None) -> dict[str, builtins.object]:
...
@staticmethod
def entail(shapes_ttl: str, data_nt: str, *, shapes_base: str | None=None, imports: Sequence[tuple[str, str]]=..., shapes_graph: str | None=None, max_term_generating_rounds: int | None=None, max_generated_terms: int | None=None, max_stored_facts: int | None=None, max_join_steps: int | None=None, xpath_regex: str | None=None) -> dict[str, builtins.object]:
...
@staticmethod
def apply_rules(data_nt: str, shapes_ttl: str | None=None, *, srl: str | None=None, shapes_base: str | None=None, srl_base: str | None=None, explain: bool=False, max_term_generating_rounds: int | None=None, max_generated_terms: int | None=None, max_stored_facts: int | None=None, max_join_steps: int | None=None, imports: Sequence[tuple[str, str]]=..., shapes_graph: str | None=None, xpath_regex: str | None=None) -> dict[str, builtins.object]:
...
@staticmethod
def check_rules(srl: str, *, srl_base: str | None=None, imports: Sequence[tuple[str, str]]=..., level: str | None=None) -> dict[str, builtins.object]:
...
@staticmethod
def eval_node_expr(shapes_ttl: str, data_nt: str, expr: str | None, focus: str, *, expr_at: str | None=None, expr_via: Sequence[str]=..., expr_turtle: str | None=None, scope: Mapping[str, str] | None=None, shapes_base: str | None=None, imports: Sequence[tuple[str, str]]=..., xpath_regex: str | None=None) -> dict[str, builtins.object]:
...
@staticmethod
def lint_shapes(shapes_ttl: str, *, shapes_base: str | None=None, imports: Sequence[tuple[str, str]]=..., shapes_graph: str | None=None) -> dict[str, builtins.object]:
...
shacl = shapes
class _Regime:
"""A SPARQL entailment regime (`purrdf.entail.Regime.OWL_RL`)."""
SIMPLE: _Regime
RDF: _Regime
RDFS: _Regime
OWL_RL: _Regime
OWL_DIRECT: _Regime
RIF: _Regime
D: _Regime
type RegimeLike = _Regime | str
class entail:
Regime: TypeAlias = _Regime
@staticmethod
def materialize(dataset: RdfDataset, regime: RegimeLike, program: str, imports: Sequence[tuple[str, str]], premise_iris: Sequence[str], *, max_stored_facts: int | None=None, max_join_steps: int | None=None, max_term_arena_bytes: int | None=None) -> tuple[RdfDataset, str]:
...
@staticmethod
def materialize_nt(data: str, regime: RegimeLike, program: str, imports: Sequence[tuple[str, str]], premise_iris: Sequence[str], *, max_stored_facts: int | None=None, max_join_steps: int | None=None, max_term_arena_bytes: int | None=None) -> tuple[str, str]:
...
@staticmethod
def rules(regime: RegimeLike) -> list[str]:
...
@staticmethod
def implemented_rules(regime: RegimeLike) -> list[str]:
...
@staticmethod
def extensions(regime: RegimeLike) -> list[str]:
...
@staticmethod
def consistency(data: str, imports: Sequence[tuple[str, str]], premise_iris: Sequence[str], step_cap: int=..., work_cap: int=...) -> tuple[str, str]:
...
@staticmethod
def classify(data: str, step_cap: int=..., work_cap: int=...) -> tuple[str, str]:
...
@staticmethod
def realize(data: str, step_cap: int=..., work_cap: int=...) -> tuple[str, str]:
...
@staticmethod
def instances(data: str, class_: str, step_cap: int=..., work_cap: int=...) -> tuple[str, str]:
...
@staticmethod
def entails(data: str, axiom: str, step_cap: int=..., work_cap: int=...) -> tuple[str, str]:
...
@staticmethod
def profile(data: str) -> tuple[str, str]:
...
@staticmethod
def extract_module(data: str, signature: str, method: str) -> tuple[str, str]:
...
@staticmethod
def justify(data: str, axiom: str) -> tuple[str, str]:
...
@staticmethod
def explain_conclusion(data: str, regime: RegimeLike, conclusion: str) -> tuple[str, str]:
...
@staticmethod
def prove(data: str, service: str, argument: str=..., step_cap: int=..., work_cap: int=...) -> tuple[str, str, str]:
...
@staticmethod
def check_proof(data: str, service: str, argument: str, answer: str, certificate: str, proof: str) -> str:
...
@staticmethod
def proof_services() -> list[str]:
...
@staticmethod
def certain_answers(regime: RegimeLike, data: str, pattern: str, imports: Sequence[tuple[str, str]], premise_iris: Sequence[str], *, max_stored_facts: int | None=None, max_join_steps: int | None=None, max_term_arena_bytes: int | None=None) -> tuple[str, str]:
...
@staticmethod
def graph_entails(regime: RegimeLike, premise: str, conclusion: str, imports: Sequence[tuple[str, str]], premise_iris: Sequence[str], *, max_stored_facts: int | None=None, max_join_steps: int | None=None, max_term_arena_bytes: int | None=None) -> tuple[str, str]:
...
@staticmethod
def verify_entailment(regime: RegimeLike, premise: str, conclusion: str, imports: Sequence[tuple[str, str]], premise_iris: Sequence[str], *, max_stored_facts: int | None=None, max_join_steps: int | None=None, max_term_arena_bytes: int | None=None) -> tuple[str, str]:
...
class Reasoner:
def __init__(self, data: str, step_cap: int=..., work_cap: int=..., proofs: bool=...) -> None:
...
@property
def records_proofs(self) -> bool:
...
def prove(self, service: str, argument: str=...) -> tuple[str, str, str]:
...
def consistency(self) -> tuple[str, str]:
...
def classify(self) -> tuple[str, str]:
...
def realize(self) -> tuple[str, str]:
...
def instances(self, class_: str) -> tuple[str, str]:
...
def entails(self, axiom: str) -> tuple[str, str]:
...
def profile(self) -> tuple[str, str]:
...
def extract_module(self, signature: str, method: str) -> tuple[str, str]:
...
def justify(self, axiom: str) -> tuple[str, str]:
...
def explain_conclusion(self, regime: RegimeLike, conclusion: str) -> tuple[str, str]:
...
def __repr__(self) -> str:
...
_gts_from_quads = gts_from_quads
_gts_from_rdf12_bytes = gts_from_rdf12_bytes
_compile_gts_native = compile_gts_native
_compile_gts_with_report = compile_gts_with_report
_gts_ingest_report = gts_ingest_report
_snapshot_content_id_native = snapshot_content_id_native
_feedback_bundle_native = feedback_bundle_native
_to_json_ld = to_json_ld
_from_json_ld = from_json_ld
_to_rdf_xml = to_rdf_xml
_from_rdf_xml = from_rdf_xml
_gts_relational_rows_from_bytes = gts_relational_rows_from_bytes
_gts_to_sqlite = gts_to_sqlite
_gts_to_duckdb = gts_to_duckdb
_gts_to_parquet = gts_to_parquet
_RdfDataset = RdfDataset
_GtsFoldViewNative = GtsFoldViewNative
class gts:
gts_from_quads = _gts_from_quads
gts_from_rdf12_bytes = _gts_from_rdf12_bytes
compile_gts_native = _compile_gts_native
compile_gts_with_report = _compile_gts_with_report
gts_ingest_report = _gts_ingest_report
snapshot_content_id_native = _snapshot_content_id_native
feedback_bundle_native = _feedback_bundle_native
to_json_ld = _to_json_ld
from_json_ld = _from_json_ld
to_rdf_xml = _to_rdf_xml
from_rdf_xml = _from_rdf_xml
gts_relational_rows_from_bytes = _gts_relational_rows_from_bytes
gts_to_sqlite = _gts_to_sqlite
gts_to_duckdb = _gts_to_duckdb
gts_to_parquet = _gts_to_parquet
RdfDataset: TypeAlias = _RdfDataset
GtsFoldViewNative: TypeAlias = _GtsFoldViewNative
class _ArtifactRecord:
@property
def role(self) -> str:
...
@property
def logical_path(self) -> str:
...
@property
def media_type(self) -> str:
...
@property
def raw_digest(self) -> str:
...
@property
def semantic_digest(self) -> str:
...
@property
def content(self) -> builtins.bytes:
...
class _ManifestView:
@property
def identifier(self) -> str:
...
@property
def slice_iri(self) -> str:
...
@property
def label(self) -> str | None:
...
@property
def title(self) -> str | None:
...
@property
def tier(self) -> str | None:
...
@property
def creators(self) -> list[str]:
...
@property
def consumers(self) -> list[str]:
...
class _SliceRecord:
@property
def manifest(self) -> _ManifestView:
...
@property
def manifest_path(self) -> str:
...
@property
def slice_dir(self) -> str:
...
@property
def artifacts(self) -> list[_ArtifactRecord]:
...
class _DependencyEdge:
@property
def from_slice(self) -> str:
...
@property
def to_slice(self) -> str:
...
@property
def is_semantic(self) -> bool:
...
@property
def reconciliation(self) -> str:
...
class _ManifestPatch:
@property
def manifest_path(self) -> str:
...
@property
def original_text(self) -> str:
...
@property
def patched_text(self) -> str:
...
class _OwnershipReport:
@property
def edges(self) -> list[_DependencyEdge]:
...
@property
def has_ownership_defect(self) -> bool:
...
@property
def ownership_errors(self) -> list[str]:
...
class _SliceCatalog:
@staticmethod
def discover(root: str, namespace: str) -> _SliceCatalog:
...
@property
def records(self) -> list[_SliceRecord]:
...
@property
def core_slice_iris(self) -> list[str]:
...
def fix_deps(self) -> list[_ManifestPatch]:
...
class _OwnershipAnalyzer:
def __init__(self, catalog: _SliceCatalog) -> None:
...
def analyze(self) -> _OwnershipReport:
...
def analysis_graph_turtle(self) -> str:
...
class slice:
ArtifactRecord: TypeAlias = _ArtifactRecord
ManifestView: TypeAlias = _ManifestView
SliceRecord: TypeAlias = _SliceRecord
DependencyEdge: TypeAlias = _DependencyEdge
ManifestPatch: TypeAlias = _ManifestPatch
OwnershipReport: TypeAlias = _OwnershipReport
SliceCatalog: TypeAlias = _SliceCatalog
OwnershipAnalyzer: TypeAlias = _OwnershipAnalyzer
_Fidelity: TypeAlias = tuple[str | None, str | None]
class _TextAnalyzerSpec(TypedDict, total=False):
lexicon: Required[TypingLiteral['empty', 'baseline', 'dictionary']]
artifacts: list[bytes]
entries: list[tuple[str, int]]
max_token_scalars: int
accent: TypingLiteral['preserve', 'latin-greek-cyrillic', 'latin-greek-cyrillic-arabic-hebrew'] | list[TypingLiteral['latin', 'greek', 'cyrillic', 'hebrew', 'arabic']]
stemming: TypingLiteral['none', 'english']
input_mode: TypingLiteral['plain', 'html-text', 'html-attribute']
code_length: int
edit_distance: int
projection: TypingLiteral['lexical', 'han']
substring_posting_operations: int
substring_candidate_spans: int
substring_verification_bytes: int
_TextProducerSpec: TypeAlias = tuple[str, str, str, _TextAnalyzerSpec] | tuple[str, str, str, _TextAnalyzerSpec, list[str] | None] | tuple[str, str, str, _TextAnalyzerSpec, list[str] | None, _Attestation] | tuple[str, str, str, _TextAnalyzerSpec, list[str] | None, _Attestation, _Fidelity]
_VectorRows: TypeAlias = list[tuple[str, list[float]]]
_VectorMetric: TypeAlias = str
_VectorGuard: TypeAlias = tuple[int, int]
_HnswProducerSpec: TypeAlias = tuple[str, _VectorRows, _VectorMetric, _VectorGuard, tuple[int, int, int, int], list[str] | None, _Attestation, str | None]
_KnnProducerSpec: TypeAlias = tuple[str, _VectorRows, _VectorMetric, _VectorGuard, list[str] | None, _Attestation, _Fidelity]
class _PlanDocumentError(ValueError):
"""A refusal from the plan-document boundary: `certify_plan`, `explain_depth`.
`refusal` is one of the engine's pinned kebab-case names. Decode side:
`version`, `truncated`, `trailing-bytes`, `invalid-tag`, `invalid-utf8`,
`invalid-iri`, `non-ascending-keys`, `non-ascending-selectivity-terms`,
`duplicate-stratum-depth`, `duplicate-stratum-derivation`,
`duplicate-statistics-subject`, `duplicate-selectivity-term`. Certificate
side: `depth-not-derivable`, `depth-without-derivation`,
`derivation-without-depth`, `derivation-without-statistics-entry`,
`statistics-entry-contradicts-derivation`, `selectivity-term-out-of-range`,
`unconsulted-statistics-subject`. Branch on it, never on `str(exc)`.
"""
refusal: str
class retrieval:
SCALE_DIGITS: int
SCALE: int
PlanDocumentError: TypeAlias = _PlanDocumentError
@staticmethod
def plan(data: str, request: list[tuple[builtins.object, ...]], *, text_producers: dict[str, _TextProducerSpec], statistics: dict[str, builtins.object], top_k: int, hnsw_producers: dict[str, _HnswProducerSpec] | None=None, knn_producers: dict[str, _KnnProducerSpec] | None=None, data_format: str='turtle', base: str | None=None) -> dict[str, builtins.object]:
...
@staticmethod
def certify_plan(plan_bytes: bytes) -> dict[str, builtins.object]:
...
@staticmethod
def explain_depth(plan_bytes: bytes, stratum: str) -> str | None:
...
@staticmethod
def compile(data: str, request: list[tuple[builtins.object, ...]], *, text_producers: dict[str, _TextProducerSpec], statistics: dict[str, builtins.object], top_k: int, hnsw_producers: dict[str, _HnswProducerSpec] | None=None, knn_producers: dict[str, _KnnProducerSpec] | None=None, weights: dict[str, int] | None=None, k: int | None=None, decay: str | None=None, data_format: str='turtle', base: str | None=None) -> dict[str, builtins.object]:
...
@staticmethod
def search(data: str, request: list[tuple[builtins.object, ...]], *, text_producers: dict[str, _TextProducerSpec], weights: dict[str, int], statistics: dict[str, builtins.object], k: int, decay: str, top_k: int, hnsw_producers: dict[str, _HnswProducerSpec] | None=None, knn_producers: dict[str, _KnnProducerSpec] | None=None, data_format: str='turtle', base: str | None=None) -> dict[str, builtins.object]:
...
@staticmethod
def weight_for_depth(depth: int, k: int, *, decay: str) -> int:
...
@staticmethod
def class_width(weight_raw: int, k: int, rank: int, *, decay: str) -> int | None:
...
@staticmethod
def deepest_rank_within_width(weight_raw: int, k: int, max_width: int, *, decay: str) -> int | None:
...
@staticmethod
def crossing_rank_at(naming_raw: list[int], at_rank: int, sharing_raw: list[int], k: int, *, decay: str) -> int | None:
...
geo.pyi
from __future__ import annotations

class GeoProfile:
    """Immutable strict native profile; omitted input selects standard CRS84."""

    def __init__(self, profile: str | None=...) -> None:
        ...

    def to_json(self) -> str:
        ...

class GeoSession:
    """One Rust session over the strict version-one geographic records."""

    def __init__(self, geo: GeoProfile | GeoSession | str | None=...) -> None:
        ...

    def call(self, request: str) -> str:
        """Return canonical semantic outcomes; raise ValueError on operational refusal."""
        ...

    def point_index(self, request: str) -> GeoPointIndex:
        ...

    def profile(self) -> GeoProfile:
        ...

class GeoPointIndex:
    """Immutable ordered point buckets, constructed by GeoSession.point_index."""

    def call(self, request: str) -> str:
        """Search through the same native comparison law and refusal channel."""
        ...
入门:JavaScript / WebAssembly
npm 包 @blackcatinformatics/purrdf 是编译为 wasm32 的同一个 Rust 引擎,并通过 RDF/JS 形态的 API(DataFactory、DatasetCore、Stream/Sink)对外提供。它可在浏览器与 Node 中运行,完全在内存中工作。
译注:中国大陆镜像。 如需使用 npm registry 镜像,可参考 npmmirror.com(原 cnpm / 淘宝源)的说明:npm config set registry https://registry.npmmirror.com。具体配置以该镜像站的说明为准。
npm install @blackcatinformatics/purrdf
想在安装任何东西之前先试用?RDF-1.2 playground 在浏览器中运行的正是这一 wasm 构建——在客户端解析、执行 SPARQL、SHACL、序列化,以及对 RDF-1.2 图做规范化/比较,无需工具链,也无需服务器。
第一个数据集
在做任何其他事情之前,先 await 一次 ready()——它执行一次性的异步 wasm 实例化:
import { ready, DataFactory, Dataset, QueryEngine } from "@blackcatinformatics/purrdf";

await ready(); // 一次性的异步 wasm 实例化

const f = new DataFactory();
const rtl = f.directionalLiteral("مرحبا", "ar", "rtl");

const ds = new Dataset();
ds.add(f.quad(f.namedNode("https://ex/s"), f.namedNode("https://ex/says"), rtl));

const nq = ds.serialize("nquads");           // 方向在往返(转换)中得以保留
const reparsed = Dataset.parse(nq, "nquads");

const engine = new QueryEngine();
const ask = engine.ask(reparsed, "ASK { <https://ex/s> <https://ex/says> ?msg }");
RDF 1.2 的切入点
现有的 RDF/JS 库都不支持 RDF 1.2 的引用三元组项或带方向的字面量。PurRDF 的 DataFactory 两者都提供:
// 一个引用三元组,可用作主语/宾语(RDF-star / RDF 1.2)。
const quoted = f.quotedTriple(
  f.namedNode("https://ex/alice"),
  f.namedNode("https://ex/knows"),
  f.namedNode("https://ex/bob"),
);

// 一个基础方向字面量(rdf:dirLangString)。
const hello = f.directionalLiteral("مرحبا", "ar", "rtl");
API 接口
ready(bytesOrUrl?)——在做任何事之前 await 一次;它也接受已编译的WebAssembly.Module。DataFactory——namedNode、blankNode、literal(value, languageOrDatatype?)、typedLiteral、directionalLiteral、variable、defaultGraph、quad、quotedTriple、fromTerm、fromQuad。Dataset(RDF/JSDatasetCore)——Dataset.parse(input, format, base?)、serialize(format)、add/delete/has/match/quads/size,以及迭代(for (const quad of dataset))。格式:turtle、ntriples、nquads、trig、rdfxml(或它们的媒体类型);serialize还额外接受jsonld。- 图标识——
Dataset.canonicalize()返回该图的 RDFC-1.0 规范化扁平 N-Quads;Dataset.isomorphic(other)判定在空节点重新标记意义下的 RDF 图相等性(一个由完整 RDFC-1.0 规范化支撑的精确判定依据(oracle))。 - 图/表格/Research Object 载体——
Dataset.project(profile, configJson)返回规范的 USTAR 字节与损失台账 JSON;Dataset.projectWithAssets("ro-crate-1.3", configJson, payloadArchive)增加有界的 attached RO-Crate 载荷;liftProjection(...)为双向 profile 重建 RDF。参见图、表格与 Research Object 投影。 - SPARQL——
QueryEngine在多次调用之间保持原生计划缓存存活,并暴露带类型的select/ask/construct/describe、原子的update,以及queryRaw序列化。Dataset.query(...)仍作为兼容用的裸字符串辅助方法保留。每个求值方法都有一个返回 Promise 的孪生方法,接受宿主为SERVICE与LOAD提供的处理函数——见下文。 - SHACL——
shaclValidateToSarif(shapesTtl, dataNt)依据 Turtle 形状图验证 N-Triples 数据图,并返回 SARIF 2.1.0 报告;shaclEntail(shapesTtl, dataNt)物化 SHACL-AFsh:rule推论,并返回一个ShaclEntailment:ntriples以 N-Triples 形式保存结果,diagnostics保存形状图的强制诊断。须对它调用free()。 Sink——流式消费者(push(quad)/finish() → Dataset);datasetToStream/streamToDataset是异步的 RDF/JS Stream/Sink 辅助函数。
关于 RDF/JS 映射的更多内容见 JavaScript 中的 RDF/JS。
Asynchronous queries and federation
同步方法是离线通道:它们不安装任何 SERVICE 或 LOAD 来源,因此 SERVICE 或 LOAD 会按名称失败,除非写了 SILENT——此时它成功而不抓取任何内容,这正是 SPARQL 1.1 对失败调用的要求。每个求值方法还有一个返回 Promise 的孪生方法——QueryEngine 上的 queryAsync、selectAsync、askAsync、constructAsync、describeAsync、queryRawAsync、queryRawBytesAsync、queryRawWithContextAsync、queryGovernedAsync、queryEntailmentGovernedAsync、updateAsync、updateGovernedAsync 与 explainQueryAsync,以及 Dataset.queryAsync——此外还有 queryGovernedNegotiatedAsync,它把受 governor 管控的查询按 HTTP Accept 请求头协商出的格式作为文档返回。孪生方法在调用开始时为数据集拍下快照,并在快照上运行同一个求值器;它以作业的形式执行:宿主应答 SERVICE 或 LOAD 时作业挂起,求值期间作业把事件循环让出,最终兑现为与其同步孪生方法完全相同的返回值。I/O 由宿主完成,相应的策略也归宿主所有;解析、求值、连接、SILENT 语义与结果编码仍由 PurRDF 负责。
EXPLAIN 也是这类求值方法之一:它的计费台账是实际运行查询测得的,而不是根据查询文本预测的。因此,explainQuery 会因缺少来源而拒绝 SERVICE 查询,而 explainQueryAsync 则基于宿主的应答来解释它。它的测量运行与其他作业一样会让出事件循环,并在其 signal 触发时停止;它不接受任何上限,因为这次运行只计量、从不设限。
SHACL 验证同样会对 SPARQL 求值:sh:SPARQLTarget 查询、SHACL-SPARQL 约束,以及 SHACL-AF 的节点表达式与规则。因此,SHACL 函数也有孪生方法:shaclValidateToSarifAsync、shaclValidateChangesToSarifAsync、shaclEntailAsync、shaclApplyRulesAsync、shaclEvalNodeExprAsync,以及 shaclProductValidateToSarifAsync 与它的 Rebuild、Expecting 和 RebuildExpecting 形式。每个孪生方法依次接受与其同步孪生方法完全相同的参数和宿主选项,并返回与同步孪生方法完全相同的结果;被拒绝的预编译形状产物(prepared shapes product)会以同一个 ShaclProductRefusal 拒绝,手头没有的 owl:imports 闭包则以同一个 ShaclImportError 拒绝。signal 既在查询内部轮询,也在焦点节点之间轮询,因此即使一次验证中没有任何 SPARQL,它也会让出事件循环,并在信号触发时停止。SHACL-SPARQL 不允许任何查询使用 SERVICE,sh:SPARQLTarget 的查询也不例外;使用了它的查询会被拒绝,两条通道都是如此。
孪生方法运行在 WebAssembly JavaScript Promise Integration(JSPI)之上,它在 Chrome 与 Edge 137+、Firefox 139+、Safari 27、Node 24.20+ 以及 Cloudflare Workers(workerd)中默认启用。hasAsyncQueries() 报告当前引擎是否支持 JSPI;在不支持的引擎上,每个孪生方法都会在触及 wasm 之前以同一个错误拒绝,而同步 API 照常工作。
应答 SERVICE
resolveService(request, ctx) 收到的是需要发送的 SPARQL 1.1 Protocol POST 请求:endpoint、queryText、contentType(application/sparql-query)、accept(application/sparql-results+json)、userAgent、timeoutMs、headers——目录 profile 的请求头与凭据,形式为按发送顺序排列的 [name, value] 对——以及 cacheable(携带凭据的请求为 false)。ctx 携带 signal(在取消、请求超时或到达截止时间时触发)、remainingDeadlineMs、silent 与 maxIntermediateCells。处理函数的应答可以是 SPARQL Results JSON(字节或字符串)、一个 Response(非 2xx 状态视为传输失败)、{ kind: "transport", message } 或 { kind: "denied", message }。处理函数若抛出异常、返回被拒绝的 Promise、返回任何其他值,或指明了协议未定义的失败种类,即视为发生故障,而故障就是它所应答的那一次调用的失败,即 { kind: "fault" }。任何失败都会让查询失败——故障以 native-sparql-host-fault 失败,其消息携带处理函数自己的原话;在 SERVICE SILENT 下它是连接的单位元,证据中的 silenced 会记录该端点与失败的 kind(transport、denied、fault 等)。ctx.silent 仅供参考:处理函数无权自行编造一个空应答。
import { ready, Dataset, QueryEngine } from "@blackcatinformatics/purrdf";

await ready();

// 一个 SERVICE 请求,以 SPARQL 1.1 Protocol POST 发送。
async function resolveService(request, { signal }) {
  try {
    // Response 本身就是应答:2xx 响应体按 SPARQL Results JSON 读取,
    // 其他任何状态都是传输失败。
    return await fetch(request.endpoint, {
      method: "POST",
      headers: [
        ["Content-Type", request.contentType], // application/sparql-query
        ["Accept", request.accept], // application/sparql-results+json
        ...request.headers, // 目录 profile 的请求头,按发送顺序排列
      ],
      body: request.queryText,
      // 在请求超时、作业到达截止时间或被取消时触发。
      signal,
    });
  } catch (error) {
    // 网络错误是端点的失败;抛出异常则会被报告为
    // 此处理函数自身的故障。
    return { kind: "transport", message: String(error) };
  }
}

const engine = new QueryEngine();
const dataset = Dataset.parse(
  "<https://example.org/a> <https://example.org/p> <https://example.org/o1> .\n",
  "nquads",
);
const { rows } = await engine.selectAsync(
  dataset,
  `SELECT ?s ?x WHERE {
     ?s <https://example.org/p> ?o
     SERVICE <https://remote.example.org/sparql> { ?o <https://example.org/q> ?x }
   }`,
  { resolveService },
);
for (const row of rows) console.log(row.s.value, row.x.value);
以 catalog 传入的 ServiceCatalog 会在调用处理函数之前授权每一个请求——每一个 SERVICE、每一个 LOAD 来源,以及 LOAD 被重定向到的每一个位置(默认拒绝,每个端点一个 profile,另可设一个兜底 profile),其 profile 的 timeoutMs 限定每个请求的时长;被拒绝的请求会让查询失败,在 SERVICE SILENT 下则是连接的单位元。localServices 在进程内用一个 Dataset 应答指定的端点。resolveLoad 以同样的方式应答 LOAD 的一跳:返回一份文档及其媒体类型、一个 Response、一个 Dataset、{ kind: "redirect", location }(作业会解析该位置并重新鉴权,最多五跳),或一个带类型的失败:每种失败都会让请求失败,而 LOAD SILENT 会在失败时成功返回、不加载任何内容。本包抛出的每个错误都以 error.code 携带其稳定代码。
在浏览器中,由远程端点的 CORS 策略决定 fetch 能否读取其应答:不允许页面所在源的端点会表现为网络错误,上面的处理函数把它报告为传输失败。若某个端点可能不可达、且其结果行可有可无,请写 SERVICE SILENT。
变量端点 SERVICE ?e { … } 应答的每一行都带有产生该行的端点的 ?e。到达该子句的每个解都必须绑定 ?e,而 ?e 在何处绑定决定了该子句发出多少个请求。若由同一组中位于其前的模式绑定(三元组模式、VALUES、BIND,或 LATERAL { SERVICE ?e { … } }),该子句会对每个解各求值一次,并把该解的绑定代入转发的查询:每个解一个请求,因此指明同一 IRI 的两个解会向它发出两个请求,二者携带的绑定各不相同。若由右侧包含该子句的 OPTIONAL、MINUS 或组连接(group join)的左侧绑定——例如 ?g ex:endpoint ?e OPTIONAL { SERVICE ?e { … } },换成 MINUS 或 { ?g ex:endpoint ?e } { SERVICE ?e { … } } 亦然——或者,由于连接满足交换律,由包含该子句的组连接的另一侧绑定,例如 { SERVICE ?e { … } ?g ex:endpoint ?e }(OPTIONAL 或 MINUS 的右侧则不行,因为它不一定绑定 ?e),那么右侧仍然独立求值,左侧只提供需要询问的端点列表,每个不同的 IRI 只询问一次。若某个左侧行的端点没有应答任何结果,该行在 OPTIONAL 下保留其原有绑定,在 MINUS 下也不会被移除。在 SERVICE SILENT 下,失败的端点只对它自己的左侧行充当连接的单位元:在组连接或 OPTIONAL 下,它只贡献一行、且只绑定 ?e,因此它的左侧行原样保留、不被扩展,其他端点的结果行也不受影响;在 MINUS 下,左侧行按端点逐个相减,因此它不会移除自己的任何行,而应答了的端点仍会移除与之匹配的行。绑定到字面量或空节点的 ?e 并未指明任何端点:这是一个错误,在 SILENT 下则对其所在的行充当连接的单位元。若没有任何解为某个子句绑定 ?e——无处绑定、只在部分左侧解中绑定,或者只在另一个 OPTIONAL 或 MINUS 右侧、EXISTS、LIMIT/OFFSET、未按 ?e 分组的聚合或未投影 ?e 的子 SELECT 之外绑定——该子句即被拒绝,无论是否写了 SILENT:根本没有发出任何调用可供 SILENT 吸收。错误消息会给出改写方式:在该子句之前绑定 ?e,例如 ?s ex:endpoint ?e . SERVICE ?e { … }。
让出、取消与并发
- 作业每经过
yieldEveryPolls次 governor 轮询就把事件循环让出一轮(默认 65 536;0表示每次轮询都让出)。每一轮在每个宿主上都是一个setTimeout(…, 0)任务,因此已在等待的请求、定时器与 fetch 响应都会在作业的两轮之间运行。只有求值阶段会让出:冻结数据集与序列化结果都会一次运行到底,evidence.async报告每个阶段的耗时。 signal: AbortSignal会在作业下一次让出或发出宿主请求时取消它。在受 governor 管控的孪生方法上,deadlineMs包含等待处理函数的时间;一次 governor 触发——包括截止时间与取消——是一个结果,而不是一次 Promise 拒绝。- 查询读取自己的快照。同一数据集同一时刻只能有一个异步更新在途:在此期间开始的另一个更新会以
native-sparql-update-in-flight被拒绝,而不是排队等待;并且只有在其运行期间数据集未被修改时,更新才会应用。configureAsync({ maxConcurrentJobs })限定同时在途的作业数(默认 16)。 - 每个作业在自己的栈区域上求值,其大小与模块自身的影子栈——同步通道运行所用的栈——完全相同;没有任何选项可以改变它。
evidence.async.stackHighWaterBytes报告作业用到了多深;对该区域而言嵌套过深的请求,与对同步通道而言嵌套过深的请求一样,以同一个带类型的栈拒绝错误失败。每个通道都会在自身的帧上花费少量栈,因此两者各自能求值的最深请求可能相差几层。 - 栈区域只决定影子栈的大小。V8 为作业自身的调用栈分配的大小与同步通道相同(默认 984 KiB,由整个进程统一设定),PurRDF 为求值每个请求保留其中固定的一份预算,因此在两条通道上,请求的图模式最多只能嵌套 284 层。超出即为
native-sparql-host-stack-exhausted,两条通道都会在求值之前拒绝:请减少请求的嵌套深度。解析把请求的嵌套保存在线性内存中,不消耗这两种栈。 - 若某个作业的栈帧覆写了其区域底部的金丝雀字(canary word),该作业会以指名该区域的故障失败。trap、Rust panic,或穿过模块栈帧抛出的 JavaScript 异常都会毒化该实例,两条通道皆然:此后对本包的每一次调用——包括同步调用,以及对 trap 之前创建的对象的调用——都会抛出错误,异步孪生方法与
ready()会拒绝,而释放对象(free()、[Symbol.dispose]())什么也不做。只有全新的 JavaScript realm(新的页面、Worker isolate 或进程)才能再次加载本包。
Cloudflare Workers
@blackcatinformatics/purrdf/cloudflare 提供 createFetchServiceResolver、createFetchLoadResolver 与 handleSparqlRequest;后者以一个 Response 应答一个 SPARQL 1.1 Protocol 请求:200 附带协商出的文档,请求体超出 maxRequestBytes(默认 1 MiB——一个查询或更新的文本是一段程序,不是一份负载)时返回 413,governor 叫停请求时返回 422 或 503(绝不会以 200 返回部分结果),错误以 application/problem+json 给出,Server-Timing 取自作业的证据,并在配置后发送 CORS 头。引擎拒绝按原样求值的请求——不受支持的构造、未注册的函数、超出宿主栈预算的嵌套——返回 400,其 code 为引擎的诊断代码;无法解析的操作也是如此。宿主拒绝联系的 SERVICE 端点或 LOAD 来源——目录未授予所需的能力,或解析器依据自身策略拒绝——返回 403;在同一数据集的另一个更新在途时开始的更新返回 409;已联系但没有给出可用应答的端点或来源返回 502;它们都以引擎的诊断代码作为 code,并给出固定的 detail,绝不使用引擎的消息,因为那会回显目录的策略,或解析器、远程端点自己的原话。500 的 detail 只在失败确实是查询自身的失败时才是引擎的原话(解析失败、求值失败、被叫停的 governor);本 SPARQL 端点无法归因于查询本身的故障——没有解析器能到达所指名的端点、resolveService/resolveLoad 抛出异常,或适配器未能分类的任何其他异常——绝不会以自身的消息或调用栈进入响应:客户端得到的是固定的通用 detail 与一个 correlationId,真正的错误只会交给 onInternalError(默认输出一行 console.error)。若抛出异常的处理函数位于 SERVICE SILENT 或 LOAD SILENT 之下,响应则是该子句自身的应答(200,更新为 204),而该缺陷仍会以其关联 id 交给 onInternalError。超出上限的 Content-Length 会在任何内容被读取之前就被拒绝;缺失或偏小的 Content-Length 同样会被捕获——请求体流入时按字节计数,谎报的请求头绝不会因此换来比诚实请求头更大的请求体。两个解析器都以 redirect: "manual" 发起请求:SERVICE 请求绝不跟随重定向(3xx 是一个带类型的传输失败,因此目录中登记的端点的请求头与凭据绝不会到达另一个源),而 LOAD 解析器把重定向交回作业,由作业在每一跳之前按目录重新为该位置鉴权,最多五跳。一个完整的 Worker:
import wasm from "@blackcatinformatics/purrdf/purrdf_wasm_bg.wasm";
import { ready, Dataset, QueryEngine, ServiceCatalog } from "@blackcatinformatics/purrdf";
import { createFetchServiceResolver, handleSparqlRequest } from "@blackcatinformatics/purrdf/cloudflare";

await ready(wasm);
const engine = new QueryEngine();
const dataset = Dataset.parse(
  "<https://example.org/a> <https://example.org/p> <https://example.org/o1> .\n",
  "nquads",
);
const catalog = new ServiceCatalog();
catalog.addService(
  "https://remote.example.org/sparql",
  JSON.stringify({ capabilities: ["query", "network"], timeoutMs: 5_000 }),
);

export default {
  fetch(request, env) {
    const resolveService = createFetchServiceResolver({
      bindings: { "https://remote.example.org": env.REMOTE },
      cache: caches.default,
      cacheTtlSeconds: 300,
    });
    return handleSparqlRequest(request, {
      engine,
      dataset,
      catalog,
      resolveService,
      cors: { origins: "*" },
      governors: { deadlineMs: 10_000, maxRemoteRequests: 40 },
    });
  },
};
Workers 限制单次调用可以发出的子请求数量,而 maxRemoteRequests 正是与之精确对应的控制项:每个 SERVICE 请求和每个 LOAD 都在到达处理函数之前计数,因此一个请求发出的子请求绝不会超过该上限。由同一组中位于其前的模式绑定的 SERVICE ?e,按到达它的每个解各计数一次,而不是按每个端点计数一次,因此请按这些解的数量设定上限。Cache API 在 workers.dev 主机名上不起任何作用,因此缓存在那里实际上处于关闭状态;在自定义域名上它可以正常工作。未配置缓存就启动的运行时(例如在本地运行的 workerd)会以“No Cache was configured“拒绝 cache.match 与 cache.put,而失败的缓存调用就是该请求的传输失败——在 SERVICE SILENT 下是连接的单位元,不写 SILENT 则是查询的失败——因此在那里不要配置 cache。携带凭据的请求绝不会接触共享缓存。在 Workers 上,Date.now() 在 CPU 密集执行期间不会前进,因此同步的 deadlineMs 在那里无法在 CPU 密集的工作中触发;异步通道则在每一次让出和每一次宿主请求时检查截止时间。
包的 README 是这些约定的完整参考。
范围与当前限制
- 仅限内存。 SPARQL 查询在内存数据集上运行。同步方法不安装任何
SERVICE或LOAD来源,因此在那里,远程SERVICE或LOAD会显式失败,除非写了SILENT;异步孪生方法只能经由宿主传入的处理函数到达远程端点。 - 按格式区分的三元组项支持。
serialize是写出器原生通道:宾语位置的引用三元组项与 RDF 1.2 陈述层在 Turtle、N-Triples、N-Quads 与 TriG(作为<<( … )>>)、RDF/XML(作为rdf:parseType="Triple")以及 JSON-LD / YAML-LD(作为@triple)中得以保留。TriX 与 HexTuples 没有可承载三元组项的语法,因此把携带三元组项的数据集序列化为二者之一时会抛出异常,而不是静默丢弃这一层。单图目标格式(Turtle、N-Triples、RDF/XML)只输出默认图。
从源码构建
Rust cdylib 位于 crates/rdf-wasm;发布的 ESM 包由它生成:
make wasm-pkg        # 发布版 wasm + wasm-bindgen ESM 绑定 → js/pkg/
make wasm-pkg-test   # 上述内容 + TypeScript、Node 与打包 tarball 门禁
这需要 wasm32-unknown-unknown Rust 目标,以及一个固定到该 crate 所用 wasm-bindgen 版本的 wasm-bindgen-cli。
入门:C
libpurrdf 是基于原生 PurRDF 栈、稳定且遵循 SemVer 纪律的 extern "C" 接口:解析、序列化、模式迭代、写时复制修改、SPARQL、SHACL 验证/蕴涵,以及 GTS 容器往返。已提交、可复现的头文件 include/purrdf.h 就是 ABI 契约——若它与 crate 发生漂移,CI 即失败。
它是一个单一的共享库:libpurrdf 以静态方式复用 purrdf-gts Rust crate,因此语言垫片只需链接 libpurrdf,就仍然可以读写 .gts 容器。
构建
库、头文件与 pkg-config 文件由 cargo-c 生成:
make capi-build                 # cargo capi build:生成 libpurrdf.{so,a} + purrdf.h + purrdf.pc
make capi-install PREFIX=/usr   # cargo capi install:安装到某个前缀目录
make capi-check                 # 验证已提交的头文件是最新的,并运行 C 冒烟测试
第一个程序
改编自仓库中的 C 冒烟测试(crates/rdf-capi/tests/smoke.c):
#include "purrdf.h"
#include <stdio.h>
#include <string.h>

int main(void) {
    const char *doc = "<http://a> <http://b> <http://c> .";
    PurrdfDataset *dataset = NULL;
    PurrdfError *error = NULL;

    int rc = purrdf_parse((const uint8_t *)doc, strlen(doc), "text/turtle",
                          NULL, NULL, &dataset, &error);
    if (rc != PURRDF_STATUS_OK) return 1;

    size_t quad_count = 0;
    purrdf_dataset_quad_count(dataset, &quad_count);
    printf("%zu quad(s)\n", quad_count);

    /* 通过模式游标迭代每一个四元组。 */
    PurrdfGraphMatch any;
    memset(&any, 0, sizeof(any));
    any.kind = PURRDF_GRAPH_MATCH_KIND_ANY;
    PurrdfCursor *cursor = NULL;
    purrdf_quads_for_pattern(dataset, NULL, NULL, NULL, &any, &cursor, &error);

    PurrdfTermView s, p, o, g;
    uint8_t has_graph = 0;
    while (purrdf_cursor_next(cursor, &s, &p, &o, &g, &has_graph) == PURRDF_STATUS_OK) {
        printf("subject=%.*s\n", (int)s.lexical.len, (const char *)s.lexical.ptr);
    }
    purrdf_cursor_free(cursor);
    purrdf_dataset_free(dataset);
    return 0;
}
purrdf_project 与 purrdf_lift 在同一套句柄模型上增加了确定性的图/表格/Research Object 载体归档。project 返回相互独立的归档缓冲区与损失台账缓冲区;lift 返回一个数据集外加一个台账缓冲区。已编译的 purrdf_project_with_assets 入口接受一个有界的、仅含载荷的 USTAR,并输出一个附带确定性元数据与预览的 RO-Crate。已编译的示例 crates/rdf-capi/examples/projection_roundtrip.c 演示了完整的所有权与释放顺序。profile 与配置见图、表格与 Research Object 投影。
ABI 契约
- 不跨越边界展开栈。 可失败的入口使用
catch_unwind;捕获到的栈展开式 panic 成为PURRDF_STATUS_PANIC。没有错误通道的入口在捕获 panic 后返回其保护器的默认值。中止式 panic 和其他进程中止无法转换为状态码。 int32_t状态 + 输出参数。 可能失败的函数返回一个PurrdfStatus值,并通过输出指针写出结果。PURRDF_STATUS_CURSOR_EXHAUSTED是(非错误的)行结束信号。- 按 SemVer 冻结的 ABI。 状态枚举只追加;新字段与新函数都是增量式的。
purrdf_abi_version在运行时报告当前的 ABI 版本;PURRDF_ABI_MAJOR/_MINOR/_PATCH宏给出所编译时所用头文件的同一组三元版本号,比较两者就是检查一个并非自己构建的库的方法。次版本号跟踪导出的签名:对导出符号的参数列表、返回契约或文档所述行为的任何修改都会使它递增,增量式参数也包括在内,因为增量式参数对每个 C 使用方而言仍意味着重新编译。
所有权与生命周期
- 每个句柄/缓冲区/错误/游标都有恰好一个对应的
*_free(purrdf_dataset_free、purrdf_graph_free、purrdf_cursor_free、purrdf_rowcursor_free、purrdf_buffer_free、purrdf_error_free)。释放NULL不做任何操作。 - C 一侧绝不对
PurrdfStr.ptr调用free()——它借用的是库所拥有的内存;若这些字节需要比借用活得更久,请把它们复制出来。来自purrdf_cursor_next的项视图,在该游标上的下一次purrdf_cursor_next或purrdf_cursor_free之前有效。 - 模式游标会固定住数据集,并从所选的核心索引中惰性拉取行;打开游标不会为匹配行分配快照。
PurrdfDataset是冻结的,且为Send + Sync——可以从多个线程并发读取。PurrdfGraph(写时复制的可变增量)与游标是单线程的。
GTS star 层往返
GTS star 层往返(对包含引用三元组 / 具体化节点(reifier)绑定的数据集执行 purrdf_to_gts → purrdf_from_gts)以 PURRDF_STATUS_OK 成功,与不含 star 内容的往返相同。C ABI 调用的是内核的标准路径(to_gts → read_graph → import_gts_graph);一个特征化测试,即 crates/rdf-capi/tests/abi.rs 中的 gts_star_roundtrip_preserves_the_statement_layer,固定了恢复后数据集中的引用三元组与具体化节点绑定,因此任一层出现回归都会在那里失败。
完整的契约细节——状态码、项跨越边界时的表示、每种句柄的线程安全性——见 purrdf-capi README。
驻留数据集 IR
PurRDF 的驻留载体共享一种按值驻留的 RDF 1.2 项表示,由隔离的 purrdf-core 内核拥有。
项只驻留一次
每个项——IRI、空节点、字面量、三元组项——都只驻留一次,并通过一个可复制的 TermId(经过 niche 优化的 NonZeroU32)寻址。文本载荷使用字符串区块(arena);三元组项保留其组成部分的 ID。四元组是由四个 TermId 组成的行。这使得项的相等比较只需一次整数比较,使四元组保持固定的较小尺寸,也意味着一个出现在一百万个四元组中的项,其字节恰好只付一次代价。
热点映射使用固定密钥的 FixedHasher——确定性哈希是字节确定性纪律的一部分,而不只是出于速度的选择。
构建器 → 冻结
IR 具有严格的两阶段生命周期:
#![allow(unused)]
fn main() {
use purrdf::{RdfDatasetBuilder, RdfLiteral};

// 项只驻留一次;四元组是由可复制的 TermId 组成的行。
let mut b = RdfDatasetBuilder::new();
let cat = b.intern_iri("https://example.org/cat")?;
let says = b.intern_iri("https://example.org/says")?;
let meow = b.intern_literal(RdfLiteral::simple("meow"))?;
b.push_quad(cat, says, meow, None)?;

// 冻结为各引擎在其上求值的、不可变且带索引的数据集。
let ds = b.freeze().expect("well-formed dataset");
assert_eq!(ds.quad_count(), 1);
Ok::<(), Box<dyn std::error::Error>>(())
}
RdfDatasetBuilder 是可变的摄入阶段:驻留项、推入四元组、附加具体化节点与注解。freeze() 验证结构并产出一个不可变的 RdfDataset:四元组行存放在 Box<[QuadRow]> 表中,并带有惰性构建的序数置换索引(每个轴每个四元组约 4 字节)。SPARQL、SHACL、ShEx 与蕴涵读取的都是这个冻结的数据集,经由零分配的 DatasetView trait。
冻结也让并发变得简单:冻结的数据集是不可变的,因此可以在多个线程之间共享并读取(C ABI 正是把它作为一个 Send + Sync 句柄提供)。
显式无图名载体
当数据没有命名图时,选择 TripleDatasetBuilder。其断言行以 12 字节存储主语、谓词和宾语;具体化绑定占 8 字节,注释占 12 字节。它与 RdfDatasetBuilder 共享项驻留和验证,但不累积四元组行或图表。
TripleDataset::try_from 从仅含默认图的四元组数据集中移出原有的项所有者。对于任何命名行或命名图声明(包括空图),它都会以 TripleReadError::NamedGraphsUnsupported 拒绝转换。
通过 TripleDataset::read() 打开可失败的视图。即使载体为空或图名不存在,命名图查询请求也会被拒绝。该读取操作的所有子读取都保留相同的首个失败;在未改变的载体上重新打开读取会启动独立操作。引擎的普通默认图查询路径使用紧凑载体的 SPO、POS 和 OSP 顺序。
进行规则物化时,purrdf::shapes::srl::infer_triples 接受该读取视图并返回 Inference<TripleDataset>。其 Datalog 行有三个位置,分区键只含谓词。普通四元组 srl::infer API 保留原有返回类型。文本索引显式选择 TextIndexConfig::for_triples;文档键变为主语/语言,分区键变为语言,并采用独立的无图名身份。
写时复制修改
「不可变」并不意味着「静态」。MutableDataset 在冻结基底之上的写时复制增量中累积编辑。其 snapshot_view() 共享未改变的基底行、项和索引。其 freeze() 则把有效数据集压实为一个新的冻结数据集,重新驻留仍然存在的项并重建稠密 ID。SPARQL UPDATE 与 C ABI 的可变 PurrdfGraph 句柄都使用这一修改层。
内核中还有什么
在 IR 本身之外,purrdf-core 还拥有:
DatasetView——每个引擎都在其上求值的静态读取 trait。- 结构化诊断——带源位置的类型化
RdfDiagnostic(刻意不涉及 SARIF;SARIF 边界位于purrdf-validate)。 - 规范化(在 RDF 1.1 子集上为 RDFC-1.0;在具体化节点与注解上为
purrdf-rdfc12profile)、数据集差异比较以及同构判定——参见规范化与差异比较。 - 存储与引擎扩展点——由兄弟 crate 中的适配器实现的、窄小的解析器入口、序列化器出口与
SparqlEnginetrait。 - 溯源与损失台账——一个通用的溯源旁挂结构以及机器可读的 RDF↔GTS 损失矩阵,外加原生的 FnO 与 SSSOM 编解码器(参见切片、映射与溯源)。
文本编解码器_不_在内核中——解析与序列化位于上一层的 purrdf-rdf 中。这种拆分让内核保持小巧,并让其不变量能在 crate 边界上强制执行:不含 PyO3(一项卫生检查会对依赖树进行断言),wasm32-clean(可干净构建到该目标),且 IR 层不涉及文件 IO。
为何如此设计
布局是通过测量而非断言选定的:基准 crates/rdf-core/benches/ir_layout.rs 在分配次数、内存高水位以及端到端延迟上比较结构体数组、数组结构体与谓词邻接三种布局——最终发布的是胜出的那一种。参见性能。
RDF 1.2 特性
PurRDF 以 RDF 1.2 为先:RDF 1.2 Concepts 在 RDF 1.1 之上新增的特性都是核心数据模型的一部分,贯穿 IR、编解码器、SPARQL、验证、各语言绑定与 GTS 传输。
三元组项
RDF 1.2 允许三元组本身作为宾语位置上的一个项——即 RDF-star 的「引用三元组」,在 SPARQL 1.2 语法中写作 <<( s p o )>>。在 IR 中,三元组项(triple term)像任何其他项一样被驻留并获得一个 TermId,因此它能与其余一切(模式、结果、序列化)组合。
- 具备 star 能力(star-capable)的编解码器(Turtle、TriG、N-Triples、N-Quads、JSON-LD star)可往返三元组项;投影到不具 star 能力的格式时会发生什么,见编解码器与确定性。
- SPARQL 1.2 的引用三元组语法由
purrdf-sparql-algebra解析,求值则以原生方式进行——W3C SPARQL 1.2 的三元组项接口在一致性测试框架中通过(一致性与测试)。 - 在 JavaScript 中,
DataFactory.quotedTriple(...)产出同一种项(JavaScript 中的 RDF/JS)。
具体化节点与注解
RDF 1.2 用具体化节点(reifier)取代了旧式具体化:它们是为三元组的某一_出现_命名的项(rdf:reifies),使得无需断言任何古怪的内容即可为一条陈述附加元数据。在 PurRDF 中,具体化节点绑定与注解存放在数据集上专门的侧表(side table)中,而不是混入四元组表。
具体化节点绑定与注解在每一种具 star 能力的编解码器往返中都得以保留;投影到不具 star 能力的格式时,它们会被_显式_丢弃并报告,实际丢弃的数量交给损失台账(参见切片、映射与溯源)。对具体化陈述进行验证的 SHACL 支持——SHACL 1.2 的 sh:reifierShape / sh:reificationRequired 接口——见 SHACL。
基础方向字面量
RDF 1.2 新增了 rdf:dirLangString:一种带语言标签、同时携带基础方向(ltr 或 rtl)的字面量,用于正确处理双向文本。它们在 IR 和每一个绑定中都是一等公民:
const rtl = f.directionalLiteral("مرحبا", "ar", "rtl");
方向在经由具 star 能力的编解码器的序列化往返中得以保留——JavaScript 快速入门演示了 N-Quads 的往返。
RDF 1.2 是一个完整的目标,而不是草案借口
PurRDF 把 RDF 1.2 / SPARQL 1.2 规范视为完整、可实现的目标,SHACL 1.2 亦然:W3C SHACL 1.2 测试套件(含具体化节点形状)全部通过。凡有范围限定的特性,其范围都被明确陈述并由测试把关——绝不留作静默的部分实现。逐特性的实时状态见docs/CONFORMANCE.md 中的一致性矩阵。
每项特性出现在哪里
| 特性 | IR | 编解码器 | SPARQL | SHACL | RDF/JS | GTS |
|---|---|---|---|---|---|---|
| 三元组项(宾语位置) | 驻留的项 | 具 star 能力的格式 | <<( s p o )>> | 经由路径/值 | quotedTriple | 按规范映射 |
| 具体化节点 / 注解 | 侧表 | 具 star 能力的格式 | 具体化节点接口 | sh:reifierShape、sh:reificationRequired | — | rdf:reifies 映射 |
| 基础方向字面量 | 字面量种类 | 可往返 | 可匹配/可产出 | 值节点 | directionalLiteral | 可承载 |
三元组项与 rdf:reifies 的 GTS 映射在 GTS 规范中形式化,该规范将其 RDF 1.2 基底固定在 2026 年 4 月 7 日的 W3C 候选推荐快照上。
RDF 1.2 可视化
PurRDF 在生成布局或 SVG 之前,先把 RDF 投影为一个与渲染器无关的陈述模型。该投影使结构性三元组项、断言出现、具体化节点标识、注解、图上下文、嵌套以及 RDF 方言诊断彼此保持区分。SVG 以内嵌 JSON 元数据的形式携带该模型,因此它既是可视化文档,也是无损的机器可读导出。
下面的示例直接由 Rust 可视化接口生成。线条颜色在每个语义关系类别内部略有变化,使密集的连线更易于追踪;线宽、虚线样式、标签与箭头语法继续承载 RDF 含义,而不依赖颜色。
普通的共享资源
紧凑视图保留了人们熟悉的 RDF 资源图,同时把共享节点的连线分开。
已断言、已具体化与带注解的陈述
实线箭头仍表示断言。可寻址的陈述锚点把这些断言连接到具体化节点资源,而这些资源的普通 RDF 属性承载溯源、置信度、时间戳以及带方向的语言字面量。
仅被引用的三元组项与嵌套三元组项
仅被引用(未被断言)的三元组是一个带边框的陈述图元(glyph),绝不是实线断言箭头。具体化节点资源与其所具体化的结构性陈述保持区分。
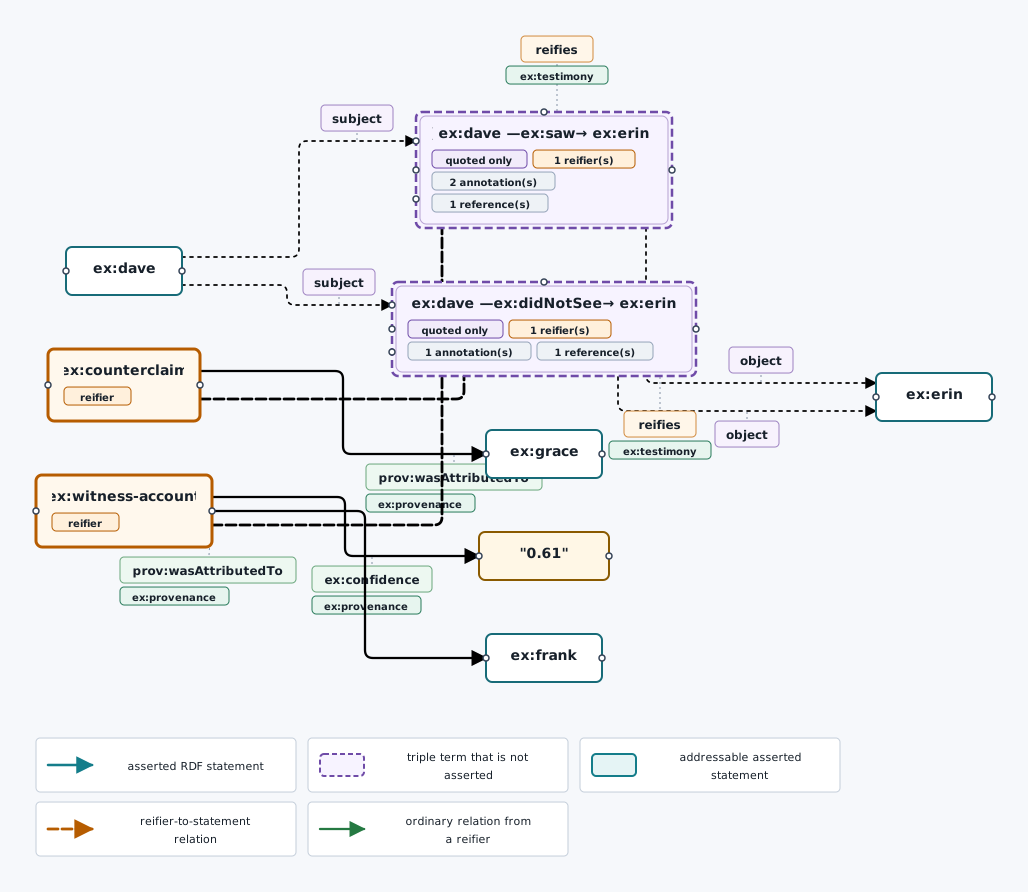
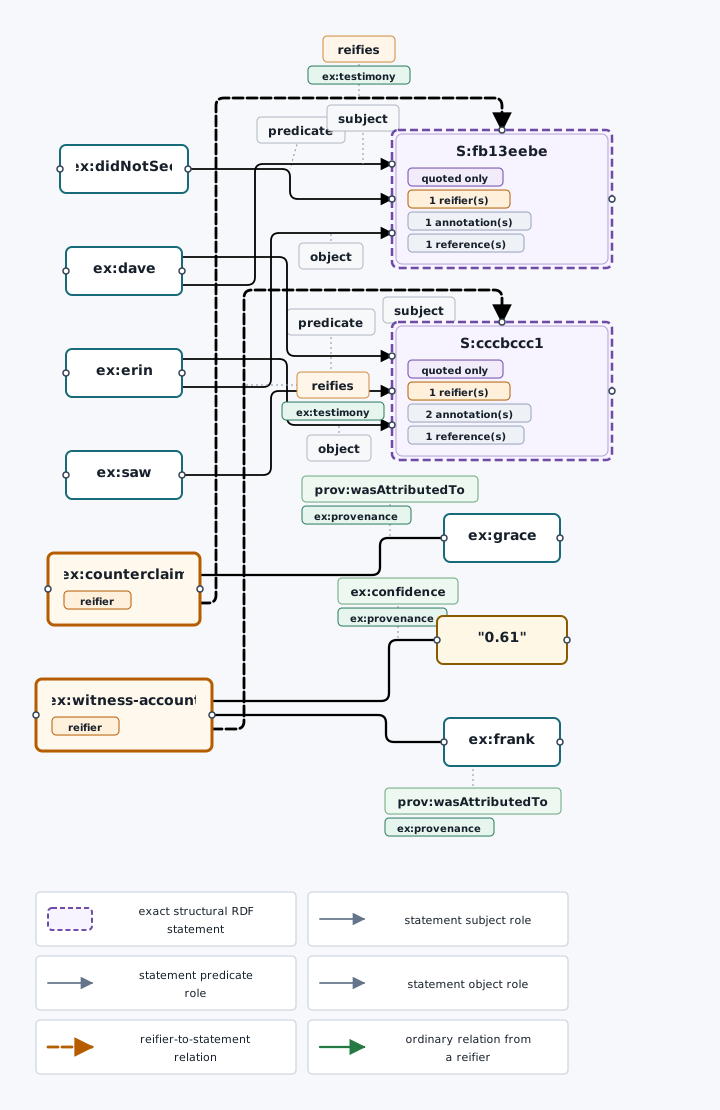
嵌套三元组项保留递归的陈述标识。方言徽标把对称或广义 RDF 位置显式标出,而不是静默地把它们渲染为普通的 RDF 1.2。
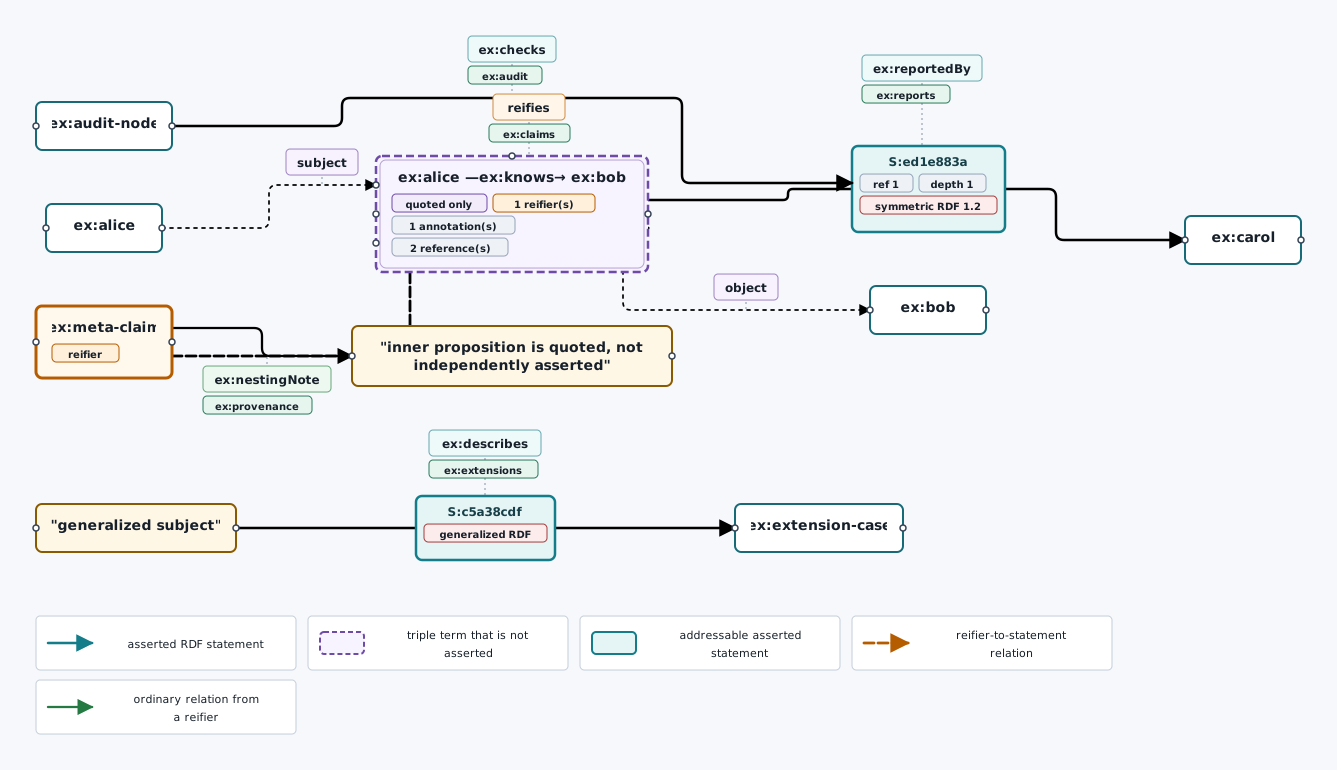
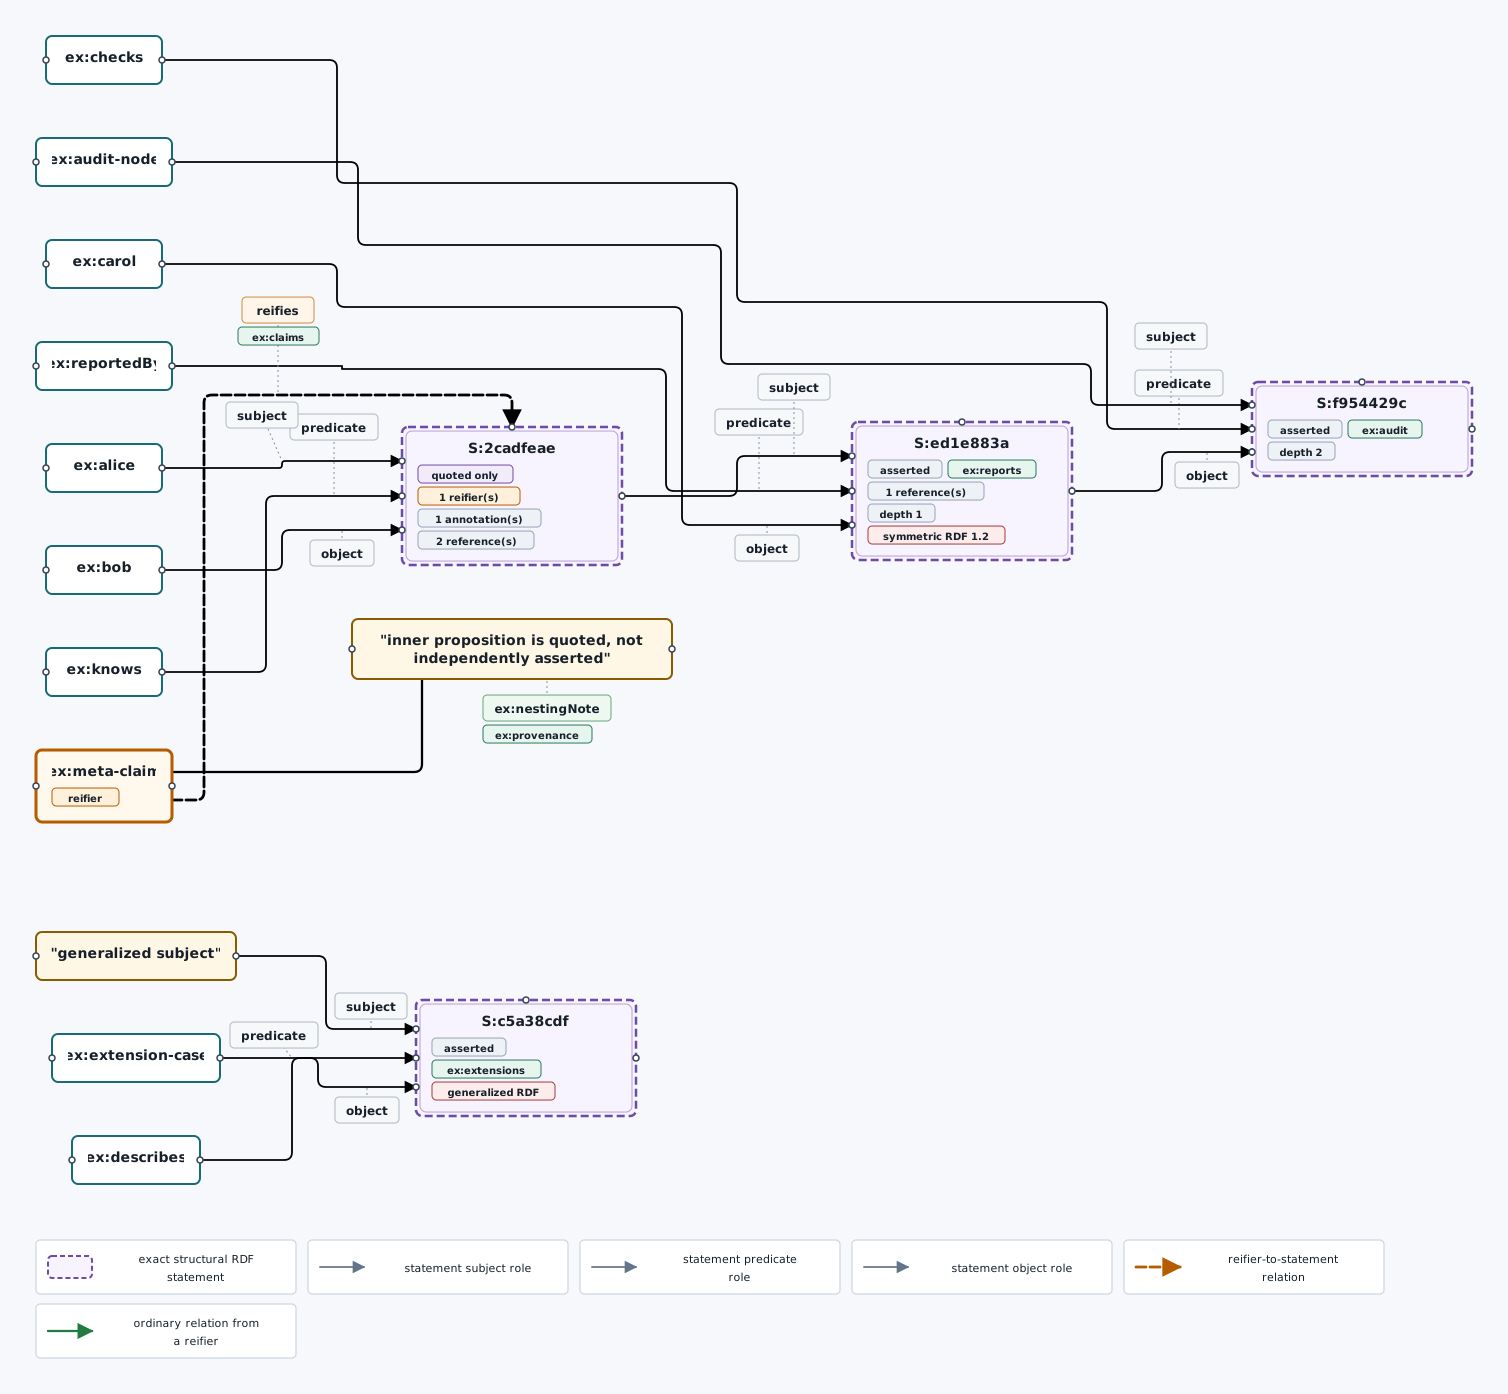
密集连接的数据
精确视图使用相互分隔的垂直通道与圆角直角转弯,使单个主语、谓词、宾语、具体化与注解连线在密集连接的数据集中仍可追踪。
重新生成示例
已提交的 SVG 是 Rust 测试夹具的投影,而不是手工编辑的书籍插图:
make book-samples
make book
make check 会在临时目录中重新生成同样的工件,并拒绝渲染器与本书之间的任何漂移。
图、表格、数据集描述与 Research Object 投影
PurRDF 把 RDF 1.2 数据集投影为图、表格、数据集描述与 Research Object 格式,而不让其中任何一种格式成为语义权威。一个 Rust 引擎实现该映射,把其工件打包为规范的 USTAR,并原样通过 Rust、CLI、Python、WebAssembly 与 C 对外提供。
每项操作都具有四条不可妥协的性质:
- 配置提供每一个词汇角色、标识 IRI、处理策略与资源上限;库不捏造其中任何一项;
- 对同一数据集与配置,输出字节是确定性的;
- 损失总是被计算为一份封闭的、带位置的台账,即使宿主选择不显示它;
- 格式错误、有歧义、非规范或越界的输入都是硬错误。
Profile
| Profile | 原生工件 | 方向 | RDF 保真度 |
|---|---|---|---|
lpg-csv | 通用的节点/边 CSV | RDF ↔ 载体 | 精确的 RDF 边带(sideband);属性图降级记入台账 |
neo4j-csv | Neo4j Admin Import CSV | RDF ↔ 载体 | 同一规范 LPG 权威与台账 |
open-cypher | 确定性的 CREATE 程序 | RDF ↔ 载体 | 严格的读取器恰好接受所输出的语法 |
graphml | GraphML 1.0 XML | RDF ↔ 载体 | 精确的 RDF 边带;严格的命名空间/键验证 |
csvw-exact | CSVW 元数据加 RDF 1.2 表 | RDF ↔ 载体 | 无损 |
csvw-terms | CSVW 元数据加调用方声明的实体表 | RDF → 视图 | 带位置的封闭损失台账 |
okf-terms | OKF v0.1 概念文档与索引 | RDF → 视图 | 带位置的封闭损失台账 |
obo-graphs | OBO Graphs 0.3.2 JSON | RDF → 视图 | 带位置的封闭损失台账 |
skos | SKOS Turtle | RDF → 视图 | 带位置的封闭损失台账 |
croissant-1.1 | croissant.json | RDF ↔ 载体 | 共享模型;profile 损失带位置 |
ro-crate-1.3 | ro-crate-metadata.json | RDF ↔ 载体 | 共享模型;profile 损失带位置 |
datacite-4.6 | datacite.xml | RDF ↔ 载体 | 共享模型;profile 损失带位置 |
dcat-3 | dcat.jsonld | RDF ↔ 载体 | 共享模型;profile 损失带位置 |
dcat-rdf | dcat.<native extension> | RDF → 视图 | 映射生成或由调用方 CONSTRUCT 生成;不含空节点的 RDF |
void | void.<native extension> | RDF → 视图 | 所选图的统计信息、分区与链接集 |
frictionless-data-package-1 | datapackage.json | RDF ↔ 载体 | 共享模型;profile 损失带位置 |
ProjectionProfile 与 LiftProfile 的类型区分很重要:经整理的 CSVW/OKF 术语、OBO Graphs、SKOS、原生 DCAT RDF 与 VoID 甚至无法被指名为 lift profile(提升 profile)。它们是有用的视图,而不是冒充的交换格式。
单一的规范 LPG 模型
四种带标签属性图语法是同一个带类型 LPG 模型之上的适配器,而不是各自独立的 RDF 映射。节点、边、标签、带类型的属性原子、图上下文、具体化节点、注解与精确的 RDF 陈述只排序、验证一次。这使四种载体拥有相同的标识与反向映射。
属性图并不定义 RDF 语义。因此,PurRDF 把每一次语义降级都记入 RDF-to-LPG 台账,尽管规范包同时也保留了用于重建的精确 RDF 边带。载体的使用方可以使用原生 LPG 视图;对 RDF 提升而言,边带仍是权威。
读取器接受 PurRDF 输出的完整形式,并拒绝任何漂移:错误的表头、重复的行或键、悬空的端点、token 映射不一致、未知的 Cypher 语句、不安全的 XML、意外的包成员以及非规范编码都会失败。
LPG 范围、上限、进度与内存
每个 LPG 配置都包含一个必需的 scope。{"mode":"all"} 是请求所有图与谓词的唯一方式;省略绝不意味着「全部」。选择性范围分别独立控制默认图、精确的命名图项、谓词允许/拒绝集合、节点的 RDF 类型以及原生边谓词。命名的空节点图保留其范围序号,每个选择器 IRI 都必须是绝对 IRI。
选择是一个封闭的 RDF 1.2 操作。即使该谓词在输出中被省略,节点类型也依据经图选择后的 rdf_type 陈述建立索引。保留的边会保留其端点。具体化节点与注解仅在其源陈述保留下来时才被保留,且注解谓词遵循同一个谓词选择器。这些规则防止所选属性图包含悬空的边带。
LpgExecutionLimits 分别独立限制扫描的输入记录、模型记录、节点与边的数量。ProjectionLimits 限制工件数量、单个工件字节数、工件正文总字节数、规范 USTAR 字节数以及递归 RDF 项的深度。每个上限都在相应的模型变更或接收器(sink)写入之前被消耗;第一次超出即为带类型的硬错误。引擎不做分页。拆分一个按规范排序、可精确逆转的载体,会使页面标识与跨页端点依赖顺序;调用方应改为选择更窄的范围或更大的显式上限。
直接接收器(sink)路径会保留所选的规范 LPG 模型,因为稳定的、与后端无关的排序、类型选择、端点闭合以及精确的 RDF 边带都需要这份有界的排序/索引。随后,它按词法路径顺序输出每个工件,每块不超过 16 KiB,既不保留完整的工件正文,也不保留 USTAR 缓冲区。归档便捷路径则额外保留物化后的工件与最终归档。因此,接收器路径的内存以所选模型加编码器临时空间与一个分块为界;它并不是一个常量内存的 RDF-to-LPG 映射器。
进度观察者接收单调的 scanning、building、writing、complete 或 aborted 快照,其中含输入/模型/节点/边、已完成工件、正文字节与当前路径计数器。接收器(sink)或观察者的失败会中止当前事务。接收器必须暂存部分状态,仅在 commit_package 时发布,并在 abort_package 时丢弃。
CSVW
较底层的 CSVW API 对带注解的表组、模式、方言、列、行、继承属性、数据类型与格式、语言与文本方向、空值/默认值/分隔符处理、虚拟列或被抑制的列、主键与外键、行标题、注解以及 URI 模板进行建模。它在一个完整的内存包上支持标准的 CSVW CSV-to-RDF 处理模式;文件系统与网络发现仍由调用方负责。
csvw-exact 归档 profile 使用这套机制无损地承载 RDF 1.2。其规范表保留项、四元组、命名图归属、递归三元组项、具体化节点绑定、注解、数据类型、语言、方向以及空节点作用域。一次有效的精确往返(转换)的台账为空。
独立的 csvw-terms profile 是一个刻意整理的宽表视图,面向类、属性、个体、业务实体或发布清单这类紧凑目录。这些名称不带任何内置含义:每张表、每个选择器、谓词、数据类型与标识规则都由调用方提供。该 profile 从不导入本体模型,也不假定 RDF、RDFS、OWL 或任何应用词汇表。
CsvwTermsConfig 只包含必需的策略:
csvw是完整的规范性 CSVW 上下文、词汇表、处理模式、记录上限与包上限;metadata_path是安全的、相对于包的元数据成员;graph_selection要么是显式的all,要么是一个精确的默认图标志加一组命名图 IRI;- 每条有序的表声明都提供稳定的名称、绝对表 URL、工件路径、行选择器、可见的主语 IRI 列,以及一个或多个有序的谓词列;
- 选择器可以通过一个显式指名的类型谓词约束任意/全部/无 RDF 类型,也可以约束主语 IRI 前缀;类型谓词恰好在类型集合非空时出现,而空的前缀集合表示不约束主语命名空间;
- 谓词列接受精确的 IRI 宾语,或带有精确数据类型、语言与 RDF 1.2 方向刻面的字面量,另加是否必需以及显式的单值或多值基数;
execution_limits限制输出总行数、所表示的值的数量以及单个单元格中的值的数量,与包上限和输入记录上限相互独立。
表之间的重叠是有意为之。一个主语匹配多个选择器时,可以出现在多个视图中。重复的表标识、路径、列名或被映射的谓词都会被拒绝。One 遇到第二个匹配值即失败。Many 按规范顺序对 RDF 项排序,并用调用方的分隔符连接;若实际值中含有该分隔符,则失败,而不是生成一个有歧义的单元格。RDF 的直接值陈述不带源序列,因此该 profile 不捏造 CSVW 的有序列表语义。
行按主语 IRI 排序,值按规范的 RDF 项顺序排序,列与表按其声明顺序排序,归档成员按词法路径排序。因此,无论源数据的驻留顺序或陈述的插入顺序如何,同一数据集与配置都会产生相同的 CSV、元数据与 USTAR 字节。
每一行源数据都有着落。未被选择的图或主语、空节点或三元组项主语、未映射的谓词、刻面不匹配的宾语、所选的命名图归属、空的命名图、具体化节点绑定与注解,都会产生稳定的、带源位置的台账条目。生成的表本身可以用规范性的 read_csvw API 读取,但无法重建被省略的源 RDF。RDF 1.2 方向在带注解的 CSVW 值与 textDirection 元数据中仍保持精确;W3C 的 CSVW-to-RDF 算法本身以 RDF 1.1 为目标,因此返回不带方向的语言字面量。所以 csvw-terms 没有对应的 LiftProfile 变体,也不含隐藏的精确边带;凡需要归档保真度或 RDF 往返(转换)时,请使用 csvw-exact。
Research Object 载体
Croissant 1.1、RO-Crate 1.3、DataCite Metadata Schema 4.6、DCAT 3 与 Frictionless Data Package v1 都是同一个带类型的 ResearchObjectModel 之上的适配器。该模型涵盖数据集的标识与描述、标识符与日期、行为主体、许可证、资源与校验和、活动、记录集以及字段。它是 N 对 N 的语义枢纽:一份文档可以被提升为采用调用方词汇表的 RDF,再投影为任何其他 profile,而无需为每对格式单独实现。
这三个 JSON-LD profile 完全离线。Croissant、RO-Crate 与 DCAT 的配置既提供精确的、被接受/被输出的 @context JSON,也提供完整的术语到绝对 IRI 的定义映射。PurRDF 从不解引用上下文 URL、从不跟随 @import,也从不提供词汇表。展开后的图通过其他地方同样使用的原生 RDF 1.2 JSON-LD 引擎进行验证。
RO-Crate 还要求显式的 packaging 值。metadata-only 是单一描述符形式。attached 接受一个有界的 RoCrateAssets 载荷载体,生成 ro-crate-metadata.json、一个自包含的确定性 ro-crate-preview.html 以及被引用的载荷成员。引擎本身不访问文件系统:Rust 接收 RoCrateAssets,CLI 通过 --assets 接收一个仅含载荷的规范 USTAR,语言绑定接收同样的归档字节。本地 File 标识与载荷路径必须一一对应;缺失/多余的资产、保留路径、重复归属、声明大小不符,或非标准的 attached crate 根,都是完整性错误。读取器验证同一契约以及精确的预览渲染。预览文件不会被加入 hasPart;只有载荷 File 实体才是根数据实体。
DataCite 配置提供命名空间、模式位置、XML-Schema-instance IRI、受控值以及常用 RDF 角色。其读取器能识别命名空间,并拒绝 DTD/实体输入。存在单独的标识符时即使用它;否则以必需的调用方/文档数据集标识作为主标识符,因此不会合成任何 DOI。Frictionless 配置提供精确的包 profile 与包名。没有单独定位符的资源使用其受调用方约束的相对实体标识作为安全的 Data Package 路径;不会生成新的 IRI。
每个原生读取器都接受 PurRDF 输出的完整 profile 形式,并拒绝重复成员、悬空引用、不安全的相对路径、错误的上下文/profile 标识、有歧义的基数以及超出资源上限的输入。共享模型之外的格式特有构造,由稳定的、带位置的台账条目表示。已提交的对抗性测试夹具为每个 profile 都覆盖了非空的反向台账;一个 5×5 的蜕变矩阵证明共享的语义交集经过每一对源/目标都保持稳定。
原生 RDF 数据集描述
dcat-3 仍是上文所述的双向 JSON-LD Research Object 载体。独立的 dcat-rdf profile 以任一已注册的原生 RDF 语法输出一个不含空节点的默认图。其带标签的 source 是必需的,有两种显式模式:
mapped复用调用方配置的 Research Object 解释,然后以调用方完整的 DCAT 上下文/角色映射,外加显式的rdf:type与 XSD 字符串 IRI,输出直接的 RDF IR。共享模型中的语义降级台账被保留。construct把调用方提供的一个 SPARQL CONSTRUCT 视为完整的视图。查询字节、输入记录、输出记录、项深度、工件、正文与归档字节全部有界。查询在配置时即被解析,在包括 RDF 1.2 陈述层在内的完整数据集上运行,且必须产生一个图。
两种模式使用同一个确定性的原生序列化器。所选语法决定唯一的 dcat.<extension> 成员;配置从不推断词汇表、查询、语法或基准 IRI。由于结果是描述视图而非精确载体,dcat-rdf 没有 lift profile。
void profile 直接以采用调用方词汇表的 RDF 生成一份确定性的、不含空节点的数据集描述。其配置指名被描述的数据集、用于生成稳定资源 IRI 的基准、源头部的主语与谓词、三个互不相同的头部/对齐/元数据图选择器、一个非空的精确数据图集合、全部 22 个目标角色、本地与外部数据集前缀注册表、可选的元数据链接映射与静态数据集陈述,以及每一项包/执行上限。
统计信息只依据所选的数据图计算。triples 统计所选陈述数,entities 与 distinctSubjects 统计不同主语数,distinctObjects 统计不同宾语数,classes 统计所配置类型谓词的 IRI 宾语数,properties 统计谓词数。类分区包含主语具有该类的每条所选陈述;属性分区包含谓词恰为该谓词的陈述。分区与链接集 IRI 使用位于调用方基准之下的完整确定性标识符。
对齐行必须具有 IRI 端点。最长前缀匹配对每个端点分类,等长歧义或无匹配都是错误,且每条对齐至少要有一个本地端点。链接集保留主语/宾语方向,并按主语数据集、宾语数据集与谓词分组。生成器从不猜测归属、从不交换方向、从不获取元数据,也从不提供 VoID/RDF/XSD 命名空间。
完整的、可移植的 example.org 配置与一个可执行的 TriG 源位于 crates/rdf/tests/fixtures/dataset-description/ 下。它们原样运行于每个宿主,例如:
purrdf project --profile dcat-rdf \
  --config crates/rdf/tests/fixtures/dataset-description/dcat-rdf.json \
  --from trig crates/rdf/tests/fixtures/dataset-description/void-source.trig dcat.tar

purrdf project --profile void \
  --config crates/rdf/tests/fixtures/dataset-description/void.json \
  --from trig crates/rdf/tests/fixtures/dataset-description/void-source.trig void.tar
OBO Graphs 与 SKOS 视图
OBO Graphs 写出器输出 0.3.2 版的节点、边与元数据,外加可直接表示的等价节点集、逻辑定义、限制、定义域/值域公理以及属性链。调用方提供图标识以及每一个 RDF/RDFS/OWL/OBO 角色。输出依据固定版本的官方 0.3.2 JSON Schema 进行检查。
SKOS 写出器把调用方选定的 RDF 图映射到一个由调用方标识的概念体系中。它支持概念、标签、记号、文档、层级、映射关系、成员关系与顶层概念,同时执行相关的 SKOS 完整性条件。目标 SKOS 角色 IRI 与源角色一样由调用方提供;PurRDF 是载体,连标准词汇表的默认值都不生成。
两种视图都以稳定的源位置记录每一个被省略或被放宽的源构造、命名图归属以及 RDF 1.2 陈述层行。
配置
生产用归档 API 接受 {"profile":"…","config":{…}} 形式的严格带标签 JSON。未知字段以及 profile/config 不匹配都会失败。不存在默认配置。一个最小的通用 LPG 示例如下:
{
  "profile": "lpg-csv",
  "config": {
    "rdf_type": "https://example.org/type",
    "scope": {"mode": "all"},
    "limits": {
      "max_artifacts": 16,
      "max_artifact_bytes": 1000000,
      "max_total_bytes": 4000000,
      "max_archive_bytes": 5000000,
      "max_term_depth": 16
    },
    "execution_limits": {
      "max_input_records": 1000,
      "max_model_records": 1000,
      "max_nodes": 1000,
      "max_edges": 1000
    }
  }
}
若要只保留一个命名图,同时接纳所有谓词与类型,可把 scope 对象替换为:
{
  "mode": "select",
  "include_default_graph": false,
  "named_graphs": {
    "mode": "only",
    "include": [{"kind": "iri", "value": "https://example.org/business"}],
    "exclude": []
  },
  "predicates": {"mode": "all", "deny": []},
  "node_types": {"mode": "all", "deny": []},
  "edge_types": {"mode": "all", "deny": []}
}
包上限与规范模型上限在写入与读取时按需适用;输入记录上限约束 RDF 投影扫描。它们合起来覆盖成员数量、单个成员字节数、正文总字节数、编码后的归档字节数、输入/模型记录数、节点数、边数以及递归 RDF 项深度。它们属于信任边界策略,必须由应用程序选定。
Research Object 配置额外包含一个必需的 common 对象,其中含完整的 roles、identity 以及有界的 policy 映射。各 profile 特有的词汇角色、上下文数据、模式标识、受控值以及原生 profile 标识同样是必需的。全部五个 profile 的完整可运行 example.org 配置位于 crates/rdf/tests/fixtures/research-objects/carrier/ 下;它们是示例,绝非库的默认值。
经整理的 CSVW 的完整严格带标签 JSON 结构由 crates/rdf/tests/fixtures/csvw-terms.json 覆盖测试。其图选择器是显式的:
{
  "kind": "include",
  "default_graph": true,
  "named_graphs": ["https://example.org/business"]
}
随后,每个表选择器指名其自身的调用方词汇与行集合:
{
  "type_predicate": "https://example.org/type",
  "any_types": ["https://example.org/Class"],
  "all_types": [],
  "none_types": ["https://example.org/Retired"],
  "iri_prefixes": ["https://example.org/vocab/"]
}
可运行的 csvw_terms Rust 示例用三条普通的表声明——类、属性与个体——构造完整配置,并写出规范归档:
cargo run -p purrdf-rdf --example csvw_terms -- /tmp/terms.tar
独立的 okf-terms profile 把由调用方分类的 RDF 资源投影为 OKF v0.1 概念文档与导航索引。配置就是整个投影代数:图范围、类别选择器、安全的路径标识、固定的标准字段角色、生产者扩展、正文/链接小节、索引正文、带内保真度声明以及资源上限。没有任何词汇或类别带有由库赋予的含义。概念 frontmatter 使用 OKF 标准键顺序,随后是按词法排序的扩展键;保留的 index.md 文件包含导航用 Markdown,不含概念 frontmatter。
完整的严格可移植配置是 crates/rdf/tests/fixtures/okf-terms.json。Rust、CLI、Python、WebAssembly/TypeScript 与 C 都原样接受它:
purrdf project --profile okf-terms --config okf-terms.json \
  --from trig ontology.trig knowledge.tar
该 profile 被有意排除在 LiftProfile 之外。从 bundle 到 RDF 的导入仍由现有的、由调用方配置 profile 的 OKF 编解码器负责;经整理的生成器会记录它未承载的每一行源数据,而不是声称存在逆映射。
Rust 归档 API
#![allow(unused)]
fn main() {
use purrdf::{
    LiftProfile, LpgConfig, LpgExecutionLimits, LpgScope, ProjectionConfig,
    ProjectionLimits, ProjectionProfile, lift_archive, parse_dataset,
    project_archive, datasets_isomorphic,
};

let dataset = parse_dataset(
    b"<https://example.org/alice> <https://example.org/knows> <https://example.org/bob> .",
    "text/turtle",
    None,
)?;
let limits = ProjectionLimits::new(16, 1_000_000, 4_000_000, 5_000_000, 16)?;
let config = ProjectionConfig::LpgCsv(LpgConfig::new(
    "https://example.org/type",
    LpgScope::all(),
    limits,
    LpgExecutionLimits::new(1_000, 1_000, 1_000, 1_000)?,
)?);

let package = project_archive(dataset.as_ref(), ProjectionProfile::LpgCsv, &config)?;
let lifted = lift_archive(&package.archive, LiftProfile::LpgCsv, &config)?;
assert_eq!(lifted.dataset.quad_count(), 1);
assert!(datasets_isomorphic(&dataset, &lifted.dataset));
Ok::<(), Box<dyn std::error::Error>>(())
}
ProjectionArchive 包含 profile、USTAR 字节与损失台账。ProjectionLift 包含重建出的不可变数据集及其提升台账。project_lpg_artifacts_to_sink 通过同一套配置与映射引擎,把四个 LPG profile 分派到调用方持有的 ProjectionArtifactSink 中;LpgProgressObserver 提供结构化的进度。更底层的 API 还公开带类型的 LPG、CSVW、OBO、SKOS、DCAT RDF、VoID 以及内存中的 Research Object/工件模型。
其他生产接口
各接口的名称遵循同一个 profile/config/archive 契约:
| 宿主 | 物化投影 | Attached RO-Crate | 直接 LPG 工件 | 提升(lift) |
|---|---|---|---|---|
| Rust | project_archive | project_archive_with_assets | project_lpg_artifacts_to_sink | lift_archive |
| CLI | purrdf project | purrdf project --assets PAYLOADS.tar | — | purrdf lift |
| Python | purrdf.project(...) | purrdf.project(..., assets=archive) | purrdf.project_artifacts(...) | purrdf.lift(...) |
| JavaScript | dataset.project(...) | dataset.projectWithAssets(...) | — | liftProjection(...) |
| C | purrdf_project(...) | purrdf_project_with_assets(...) | — | purrdf_lift(...) |
可运行的示例位于:
crates/rdf/examples/projection_archive.rscrates/rdf/examples/csvw_terms.rscrates/rdf/examples/okf_terms.rscrates/rdf/examples/research_object_roundtrip.rscrates/rdf/examples/attached_ro_crate.rscrates/cli/examples/projection-roundtrip.shcrates/cli/examples/dataset-descriptions.shbindings/python/examples/projection_roundtrip.pybindings/python/examples/projection_stream.pycrates/rdf-wasm/js/examples/projection-roundtrip.mjscrates/rdf-capi/examples/projection_roundtrip.c
确定性与验证
归档成员使用按词法排序的安全 POSIX 相对路径。USTAR 头、元数据、校验和、填充与结尾块都是固定的。读取器验证归档,并要求其规范重编码与输入字节一致,因此不会静默地把攻击者控制的替代形式规范化。
固定版本的 W3C CSVW 清单覆盖 270 个 RDF 用例与 282 个验证用例。一个锁定版本的独立 csvw 实现验证生产输出,并拒绝刻意构造的元数据/数据损坏。OBO 写出器依据固定版本的官方模式独立验证,并配有损坏探针。运行整个投影验证切片:
make projection-oracles
cargo bench -p purrdf-rdf --bench projections -- --quick
该基准测试仅供报告。它测量 RDF-to-LPG 映射、在 20 个图的载体上按范围映射与显式 all 映射的对比、每种 LPG 语法的物化包输出与直接接收器(sink)输出的对比、每条 LPG 读取路径、精确 CSVW 写入/读取、在同一个 12,000 个四元组的载体上精确 CSVW 与经整理 CSVW 的对比、单图与全图的经整理范围对比、OBO Graphs 与 SKOS 投影、映射式与 CONSTRUCT 式 DCAT RDF、VoID 生成、共享的 Research Object 模型,以及全部五条 Research Object 写入/读取路径。它还报告在确定性测试夹具上观察到的内存分配与工件正文大小。
编解码器与确定性
PurRDF 为九种格式提供第一方解析器与序列化器——不封装任何第三方编解码器:
| 格式 | 媒体类型 | 支持 star |
|---|---|---|
| Turtle | text/turtle | 是 |
| TriG | application/trig | 是 |
| N-Triples | application/n-triples | 是 |
| N-Quads | application/n-quads | 是 |
| RDF/XML | application/rdf+xml | 否 |
| TriX | application/trix | 否 |
| HexTuples | application/x-hextuples | 否 |
| JSON-LD (star) | application/ld+json | 是 |
| YAML-LD | application/ld+yaml | 是 |
它们位于 purrdf-rdf 中,比内核高一层,可经由总括 crate 访问:
#![allow(unused)]
fn main() {
use purrdf::{parse_dataset, serialize_dataset, SerializeGraph};

let turtle = br#"
    @prefix ex: <https://example.org/> .
    ex:cat ex:says "meow" .
"#;

// 解析为冻结的、按值驻留的 RDF 1.2 数据集 IR。
let ds = parse_dataset(turtle, "text/turtle", None).expect("valid Turtle");
assert_eq!(ds.quad_count(), 1);

// 通过任一原生编解码器序列化输出——逐字节确定性的输出。
let nq = serialize_dataset(&ds, "application/n-quads", SerializeGraph::Dataset)
    .expect("serializes");
assert_eq!(nq.as_slice(), b"<https://example.org/cat> <https://example.org/says> \"meow\" .\n");
}
Open Knowledge Format bundle
原生 OKF 编解码器把按调用方 profile 配置的 RDF 1.2 数据集映射为面向智能体的、带 YAML frontmatter 的 Markdown 文件,并经由 RDF 事件扩展点把它们提升回来。OKF 是一个内存中的 bundle API,而不是又一种媒体类型:文件如何存储由调用方选择,因此同一份代码保持确定性与 wasm-clean。
OkfConfig::new 要求提供词汇命名空间、文档基准 IRI 以及可识别的 frontmatter 键。不存在内置的本体或命名空间。使用 lift_okf_bundle 驱动一个 RdfEventSink,或使用 write_okf_bundle(由 OkfWriter 这一 RdfDatasetVisitor 支撑)投影一个冻结的数据集。两个方向都总是返回损失台账。无损的 profile 得到空台账;写入时,命名图、非 profile/OWL 行以及无关的具体化节点或注解行都会被明确地逐一指出。
字节确定性
每个序列化器都是逐字节确定性的:同一数据集在每个平台、每种语言绑定中总是产生相同的字节。这是工作区的硬性不变量,而非尽力而为——任何输出路径都不允许依赖迭代顺序、时间或随机数生成器(哈希器使用固定密钥的 FixedHasher 正是出于这个原因),且黄金文件测试固定了输出的字节。
确定性使工具包的其余部分得以组合:GTS 与切片目录中的内容寻址、评审中可做差异比较的序列化结果,以及可逐字节比较的跨语言一致性向量。
诊断,而非部分解析
格式错误的输入是一个带类型的 RdfDiagnostic,编解码器能提供源位置时即附带源位置——绝不会静默地部分解析。解析时可以选择记录一张源位置区间表,以获得更丰富的诊断。诊断在核心中保持结构化(不含 SARIF);可使用 purrdf-validate 把它们渲染为逐字节确定性的 SARIF 2.1.0,供编辑器与 CI 使用(参见 SHACL)。
有损投影会显式告知
RDF 1.2 陈述级数据(三元组项、具体化节点绑定、注解)在每一次支持 star 的往返(转换)中都得以保留。序列化到不支持 star 的投影时,这一层会被_丢弃并显式告知_:实际丢弃的数量交给机器可读的损失台账(generated/transcode-loss-matrix.json,代码 rdf12-star-unrepresentable),而不是凭空消失。同样的纪律也适用于 SPARQL 结果边界(结果格式)与 RDF↔GTS 边界。
简洁 pack 编解码器
除上述文本编解码器之外,purrdf-core 还提供一个用于不同用途的二进制编解码器:一种只读的、可直接查询压缩形式的整个数据集编码,面向大规模参考 bundle,而不是带媒体类型的交换格式。PackBuilder::build_bytes(&dataset) 把一个自包含、逐字节确定性的 pack——值字典、按图分区的简洁位图三元组,以及 RDF 1.2 侧表(具体化节点绑定、陈述注解)——写入一个 Vec<u8>。PackView::from_bytes(&[u8]) 在借用的切片上以零拷贝方式打开它,并直接针对打包后的字节回答模式查询,事先不需要任何解压或物化步骤。
当一个数据集已不再变化,需要分发、归档,或需要在每次加载都重新解析文本会过慢的规模上提供服务时,就该使用 pack:RDF 1.2(命名图、引用三元组、具体化节点、注解)得到完整支持,且 verify_pack 会依据 pack 自身解码出的内容独立地重新计算数据集的 RDFC-1.0 摘要——这是一个经认证的只读投影,而不只是一个压缩文件。库本身从不对 pack 做内存映射(每个已发布的 crate 都保持 wasm32-unknown-unknown 兼容);想要一个持久的、大于堆的存储层的原生使用方,可以自行 mmap 该文件,再把得到的借用切片交给 PackView::from_bytes。完整契约见后端契约中的「Pack backend」一节。
确定性的嵌入伴随文件
.purremb 是面向某个确切 .purrpck 的嵌入(向量嵌入)投影的原生 mmap 伴随文件。它不修改 pack,也不改变 RDF 规范标识。其排序后的节目录把有限的稠密 f32 或 f64 矩阵绑定到源 pack 的确切 SHA-256、一个经独立校验的 RDFC 摘要、完整的模型与处理契约、稳定的目标集,以及逐节与整个工件的完整性证据。EmbeddingBuilder 接受无序的行;EmbeddingStreamWriter 接受规范顺序的行,矩阵工作内存有界;两者产生相同的规范字节。
两类主体是一等公民。大型文本集合使用语料库–文档–分块的层级:UTF-8 文本保留在外部,而目标记录保留内容摘要、逻辑标识、字节与 Unicode 标量坐标、分块契约以及限定于嵌入族的 token 区间。RDF 数据使用同一个 RDF 1.2 模型来表示数据集、默认图与命名图、陈述、具体化节点绑定、注解、带方向的字面量、空节点以及递归三元组项。源局部的 pack 序号是经过校验的查找提示,绝不是标识。
Matryoshka 嵌入族只存储其最宽的稠密矩阵。每个声明的前导前缀都是一个独立的 VectorSpaceId 与 ProjectionId,因此粗粒度前缀不会被静默地与完整空间比较或替代完整空间。原始前缀行是零拷贝的跨步视图;确定性的 L2 前缀按需计算。近似索引仍是不透明的、可重建的派生工件,绑定到一个确切的前缀投影。它们绝不取代权威矩阵。
构建遵循唯一一条证据路径。首先,通过构建或独立校验确切的源 pack 获得一个 CertifiedPurrpckSource;任意的摘要声明都无法构造该类型。对于语料库,推导出 CorpusTarget、DocumentTarget::from_content 与 TextChunkTarget::from_document 记录,添加所需的层级关系,并为嵌入族矩阵中的每个文档或分块添加一个 TokenSpan。对于 RDF,从那个经过校验的 RDF 1.2 数据集推导出数据集、图、陈述、具体化节点、注解与项的目标。RDF-star 三元组项使用 RdfTermTarget::Triple;它们不进入单独的标识体系。
EmbeddingFamilyContract 定义完整的生成流水线。Matryoshka 契约列出其允许的前导维度,而其 MatrixInput 只携带最宽维度上的行,并为每个声明的空间各携带一个 ProjectionSpec。使用方通过 effective_matrix 解析一个确切的 (TargetSetId, VectorSpaceId),并且在比较来自相互独立输入的行之前必须调用 require_compatible_vector_spaces。
大型集合在工件边界处分片:每个 .purremb 指名其自身确切的源 pack 与本地目标集,而相同的嵌入族契约保留相同的 FamilyId 与 VectorSpaceId。语料库清单与 ExternalBinding::from_bytes 绑定外部文本或其他确切工件;ExternalBinding::from_purrpck 加入经独立认证的 RDF 证据。绑定携带调用方提供的角色与媒体类型。PurRDF 不为它们发明策略或本体词汇。
EmbeddingView::from_bytes 借用任何稳定的字节切片,无论是堆上持有的、由调用方内存映射的,还是 WebAssembly 线性内存。结构性打开、完整的工件校验、确切的源校验以及经认证的源校验,都是显式的证据状态,而不是访问关卡。对文件做 mmap 的调用方,在视图或驻留的校验证书存在期间,必须保持底层字节不可变。
嵌入与 ANN 结构是敏感的派生内容:模型反演、成员推断、相似度探测、摘要字典攻击以及索引结构都可能泄露源数据的性质。容器哈希能检测损坏与过时的附着;它们不认证作者、不加密内容,也不授予访问权限。参见逐字节精确的 PURREMB v1 规范。
列式 Parquet 编解码器
purrdf::columnar 提供双向的 SQL/DataFrame 交换路径。它把任意 DatasetView 加上一个内容寻址的 blob 存储映射为五个标准 Parquet 文件(terms、quads、reifiers、annotations 与 blobs),并在不依赖 Arrow 或通用 Parquet 运行时的情况下把这一确切 profile 读回。该映射保留 RDF 1.2 三元组项、具体化节点、注解、图作用域、带方向的字面量、空节点作用域以及显式为空的命名图。
这些文件逐字节确定,可由 DuckDB 等引擎读取。每个字段以及刻意收窄的 Parquet profile 见规范性列式模式。
一致性
编解码器由 W3C rdf-tests 语法语料把关,该语料随库固化并冻结在仓库中——涵盖 N-Quads、N-Triples、RDF/XML、TriG 与 Turtle 的 264/264 个往返(转换)用例。实时记分板见 docs/CONFORMANCE.md。
相关内容
- 规范化与差异比较——当需要的是_规范的_序列化而不仅仅是确定性的序列化时。
- 驻留数据集 IR——文本编解码器解析成的目标,以及 pack 编解码器与
RdfDataset并列实现的DatasetView读取扩展点。
基准 IRI 与相对引用
RDF 文档可以用_相对_形式书写 IRI——<other.ttl>、<#me>、<>——而读取方必须先把它转换为绝对 IRI,它才能成为一个项。这种转换需要一个基准 IRI(base IRI)。PurRDF 在每一种语法、每一个接口上,都通过同一层解析每一个相对引用:purrdf-iri。
这是硬失败,而它过去是静默的。 作用域内没有基准的相对 IRI 现在是一个错误。以前以这种方式「能用」的文档其实并不能用:它们把一个相对字符串当作 IRI 驻留,并输出任何符合规范的解析器都不接受的 N-Triples。如果某个文档开始以
iri-relative-no-base失败,说明它早就在产生无效的 RDF——应当为它提供基准(见下文),而不是绕开这个错误。
基准从何而来
优先级链就是 RFC 3986 §5.1 所规定的,按其顺序排列。第一个得出基准的步骤胜出:
| 来源 | RFC 3986 | 示例 | |
|---|---|---|---|
| 1 | 文档内的基准指令 | §5.1.1 | Turtle/TriG 的 @base 或 BASE、SPARQL 的 BASE、RDF/XML 的 xml:base、JSON-LD/YAML-LD 的 @context.@base |
| 2 | 调用方提供的基准 | §5.1.2 | parse_dataset 的 base 参数、CLI 的 --base |
| 3 | 文档的获取 IRI(retrieval IRI) | §5.1.3 | CLI 所读取文件的 file:// IRI |
| 4 | (无)——硬失败 | §5.1.4 | iri-relative-no-base |
第 1 步可以嵌套:文档内的 @base 会相对于当前生效的基准重新绑定,因此在 http://example.org/dir/ 下的 @base <sub/> 得到 http://example.org/dir/sub/。
任何内容都不会被凭空捏造。没有默认基准,没有编造的 urn: 占位符,也不会退回到当前工作目录。第 4 步是一个真实的、有规范规定的结果,而不是一个缺口。
哪些接口拥有获取 IRI
第 3 步需要获取 IRI,而只有自己打开了文件的接口才拥有它。这样的接口有三个。推导逻辑只存在于其中一个之中,另外两个消费它的结果,而不是各自重新推导。
| 接口 | 有获取 IRI? | 结果 |
|---|---|---|
purrdf-slice(切片树、目录、依赖修复) | 是——推导它;这是工作区中 §5.1.3 的唯一实现 | 磁盘上切片文档中的相对 IRI 无需任何标志即可解析 |
purrdf-shapes 形状合并加载器 | 是——消费 purrdf-slice 的推导结果 | 每个形状文件都在其自身的 file:// IRI 下解析 |
purrdf CLI,按输入文件 | 是——消费 purrdf-slice 的推导结果 | 相对 IRI 无需任何标志即可解析 |
purrdf CLI,stdin(-) | 否 | 相对 IRI 报告 iri-relative-no-base;需传入 --base |
Rust 字节 API(parse_dataset、purrdf-rdf、purrdf-iri) | 否 | 传入基准,或文档自身必须携带基准 |
| WebAssembly | 否 | 同上 |
| C ABI | 否 | 同上 |
| Python | 否 | 同上 |
每一个接收字节而非路径的接口都属于第二组。字节没有获取 IRI,因此 §5.1.3 在那里不起作用,而 §5.1.4——硬失败——就是规范规定的答案。这是有意为之,而不是疏漏:从本地文件系统捏造出的基准会因机器而异,并把本地路径泄漏到发布的 RDF 中,从而破坏整个工具包赖以成立的字节确定性。这也是 purrdf-iri 与 purrdf-rdf 从不接触文件系统的原因——正是这一点让它们保持 wasm32-clean(可干净构建到 wasm32)。
purrdf-slice 从规范化后的路径推导获取 IRI,把 Windows 路径(包括 UNC 主机与扩展长度前缀 \\?\)转换为 RFC 8089 形式,并对每个组成部分进行百分号编码。它的使用方只在没有给出更高优先级的基准时才应用它,而没有可用 file:// IRI 的路径是一个点名 --base 的硬错误,绝不会静默退回到「没有基准」。
两类语法族
基准究竟有没有用,取决于语法,而不是基准本身:
| 族 | 语法 | 相对引用 |
|---|---|---|
| 允许相对引用 | Turtle、TriG、RDF/XML、JSON-LD、YAML-LD、SPARQL | 相对于当前生效的基准解析 |
| 按语法只允许绝对形式 | N-Triples、N-Quads、TriX、HexTuples | 拒绝——从不应用任何基准 |
第二族的语法没有基准指令,也没有相对 IRI 产生式。在那里出现相对引用会使文档对其自身语法而言无效,因此 PurRDF 报告一个_不同的_代码,而且提供基准也无法挽救它:应改为把源文件转换为 Turtle,或转换为使用绝对 IRI 的 N-Triples。
绝对引用从不被改动。在两个族中,文档以绝对形式书写的 IRI 都按词法原样采用——<http://a/bb/ccc/../d;p?q> 原封不动地保留,无论作用域内是否有基准。若仍然让它经过解析,就会应用 RFC 3986 §5.2.4 的点段移除,而那是 §6.2.2.3 的_基于语法的规范化_,为 RDF Concepts §3.2 所禁止。相同的文档字节必须表示同一个图,并具有同一个规范摘要。
文档之外:IR 边界
上面所说的一切都关于_读取文档_,但文档并不是项进入存储的唯一途径。也可以直接构建数据集——从 Python 四元组对象、从 GTS 容器、重新打开 .pack 文件、通过 SPARQL INSERT DATA,或通过投影——而这些途径都不经过能替调用方解析基准的解析器。
因此,绝对性规则并不位于编解码器之中。它位于上述每条路径都必然到达的驻留项表,所以相对 IRI 不只是在入口处被拒绝:它根本无法表示。无法构造出携带相对 IRI 的冻结数据集,而这种拒绝报告的正是解析器会报告的同一个 iri-relative-no-base 代码。
在那个边界上没有作用域内的基准,也不可能有:冻结的数据集是一组_已解析_的标识,旁边没有文档,也没有可供日后据以解析的 @base。因此在那里出现的相对引用并不是一个等待解析的项——它是一个标识无从知晓的项。应当在它成为项_之前_,按应用程序所指的基准去解析它。
何时会看到这个错误
在执行引入该相对 IRI 的修改操作时。Store.add、MutableDataset.add、RDF/JS 的 dataset.add 以及 purrdf_graph_insert 都会在调用时拒绝相对 IRI,并点名出错的项:
>>> store.add(Quad(NamedNode("rel"), p, o))
ValueError: iri-relative-no-base: relative IRI reference "rel" cannot be resolved:
no base IRI is in scope; add a base to the document (`@base`/`BASE` in
Turtle-family syntaxes, `xml:base` in RDF/XML) or pass a base IRI to the API
被拒绝的四元组不会写入——存储保持不变,且仍然可用。
在工作集变为数据集的每一个节点,这项检查都会重复进行:冻结构建器或存储中待提交的编辑时,对结果进行序列化、规范化或计算摘要时,以及重新打开 .pack 文件时(其字节可能由另一个引擎或较旧的版本写出,或已在磁盘上损坏)。这种重复是有意为之。冻结时的检查是_不变量_——正是它使得相对 IRI 无论从哪个入口进入都无法在 IR 中表示,包括那些根本不经过修改调用的入口。插入时的检查是_诊断_:它的存在是为了让错误能够指出导致它的那一行。二者谁也不能取代谁。
一个可以依赖的例外
空节点标签与字面量的词法形式是任意字符串,不受上述任何规则影响。只有 IRI 才是 IRI。
诊断代码
这些代码稳定且机器可读。每个编解码器、CLI、C ABI、Python 与 wasm 对同一情况都报告同一代码。
| 代码 | 情况 | 处理方法 |
|---|---|---|
iri-relative-no-base | 在允许相对引用的语法中出现相对引用,而作用域内没有基准 | 为文档添加 @base/BASE/xml:base/@context.@base,或向 API 传入基准(CLI 上用 --base) |
iri-not-absolute-by-grammar | N-Triples、N-Quads、TriX 或 HexTuples 中的相对引用——包括空引用 <>;或者其 xmlns: 命名空间本身是相对形式的 RDF/XML 元素或属性 QName | 以绝对形式书写 IRI;基准无济于事——该位置不允许相对引用 |
iri-non-absolute-base | 基准_本身_没有 scheme(RFC 3986 §5.1 要求基准是绝对的) | 提供一个带 scheme 的基准,例如 http://example.org/dir/。文件系统路径是相对引用,而不是基准 IRI——CLI 会在参数边界拒绝它,并提示调用方本意所指的 file:// IRI |
RDF/XML 同时出现在两个语法族中是有原因的,上面这一行是其中较窄的那一半。它的 rdf:about / rdf:resource / rdf:ID 值_确实_是引用,并且会相对于 xml:base 解析,这就是为什么前面的表格把它列为允许相对引用。但元素或属性的_名称_是由一个 xmlns: 声明加上一个本地名组合而成的;它不是引用,因此没有任何东西会解析它,而相对的 xmlns:ex="rel/" 会组合出一个任何基准都无法挽救的相对 IRI:
$ purrdf convert data.rdf --from rdfxml --to ntriples
purrdf: error iri-not-absolute-by-grammar: invalid IRI from an XML qualified name:
relative IRI reference "rel/p" is not permitted by this syntax (the caller-supplied
base, <file:///tmp/data.rdf>, is in scope but is never applied here); write the IRI
in absolute form; this syntax admits no relative IRI reference, so supplying a base
will not help
请注意,该消息点名了_确实_在作用域内的基准,并说明它在此处被有意不予应用,因此传入了基准的调用方不会被误导去寻找一个被丢弃的参数。
为每个代码输出的消息本身已经带有补救办法,因此只打印该错误的使用方仍然能告诉其用户该怎么做。
写出基准
IRI 解析(resolution)在序列化一侧有其镜像。能够表达文档基准的语法,在提供了基准时会输出它,并相对于它对其中的 IRI 进行相对化:
| 语法 | 读取基准 | 写出基准 |
|---|---|---|
| Turtle、TriG | @base / BASE | @base |
| RDF/XML | xml:base | xml:base |
| JSON-LD、YAML-LD | @context.@base | @context.@base |
| N-Triples、N-Quads、TriX、HexTuples | 否 | 否——仅绝对 IRI |
最后一行中的格式到达其写出器时没有基准,输出绝对 IRI。这不是静默丢弃:该格式根本没有表达基准的接口,因此没有可写的内容,而输出对其语法而言仍然有效。在 CLI 上还多一步——如果给出了 --base,而本次运行的两侧_都_无法使用它,该命令会被直接拒绝,而不是接受一个不起作用的标志。见下文。
命令行上的 --base
purrdf convert、query、update 以及其他产生 RDF 的子命令接受 --base <IRI>,它作用于两侧:
-
解析——它是调用方提供的基准(§5.1.2),因此优先于输入的获取 IRI,但不优先于文档内指令。只有当源语法允许相对引用时,解析一侧才能使用该基准。
-
序列化——如果目标语法能够写出基准,它会作为输出文档的基准被输出,其中的 IRI 相对于它进行相对化。只有当目标语法会输出基准指令时,序列化一侧才能使用该基准。
-
两侧都无法使用——用法错误,退出码 2。 只要_任何一侧_使用了基准,它就被采纳,因此
--from turtle --to ntriples --base …没有问题(解析一侧使用它),--from ntriples --to turtle --base …也没有问题(序列化一侧使用它)。但--from ntriples --to ntriples --base …无处安放它。CLI 不会在静默忽略该标志之后以 0 退出,而是点名两侧并拒绝:$ purrdf convert data.nt --from ntriples --to ntriples --base http://example.org/dir/ purrdf: --base has no effect on this run: on the source `data.nt`, ntriples's grammar admits no relative IRI reference, so nothing in the document resolves against a base; and on the --to target, ntriples can express no base directive, so nothing is written under one or relativized against it. Drop --base, or name a syntax that carries one (turtle, trig, rdfxml, jsonld, yamlld) $ echo $? 2这一裁决取自格式注册表的
admits_relative_iri与emits_base两列,因此新注册的语法由它自己的那一行来分类,而不是靠一份手工清单。它适用于convert、validate、reason、entails、consistency与project。query、update、shex的形状映射以及describe --iri被有意豁免:它们各自都有一个来自命令行文本、没有自身文档的 IRI 接口,因此无论格式行怎么说,--base在那里都绝不会不起作用。
# 文件输入无需任何标志:它自身的 file:// 获取 IRI 就是基准。
purrdf convert data.ttl --to ntriples

# stdin 没有获取 IRI,因此其中的相对 IRI 需要显式提供基准。
cat data.ttl | purrdf convert - --from turtle --to ntriples \
  --base http://example.org/dir/
如果 data.ttl 声明了自己的基准,则保留该解析基准,同时写出一个新的输出基准:
purrdf convert data.ttl --to turtle --base http://example.org/v2/
--base 在输入之处即被验证。不是绝对 IRI 的值属于用法错误,而形如路径的值会得到一个推导出的建议——对 ./vocab/,会给出它实际所指的 file:// IRI,该 IRI 是解析得出的,而不是拼接而成的。
传给 purrdf shex 的形状映射是没有自身文档的命令行文本,因此 --base 是它唯一可能拥有的基准。与之相对,--schema 文件是一份独立的文档,相对于它自身的获取 IRI 或它自己的 BASE 指令进行解析。
一致性
RFC 3986 §5.4 的规范性解析表在 crates/iri/tests/ 中直接针对 IRI 解析器(resolver)进行断言。在端到端层面,W3C rdf-tests 的 IRI-resolution-01/02/07/08 用例——即在真实文档中经由 @base 驱动的同一张表,外加带尾部斜杠的基准、文件路径、空段以及含冒号的段——随库固化于 crates/rdf/tests/corpus/w3c/{turtle,trig}/iri/ 之下,并在每次运行时评分。
JSON-LD 上下文与压缩
PurRDF 有三种显式的 JSON-LD/YAML-LD 序列化模式:
expanded保留逐字节冻结的空@context表示;context把调用方的前缀映射或本地 JSON-LD 1.1 上下文编译一次,并应用规范性的压缩;derived仅依据数据集中的绝对 IRI,以确定性方式分配中性的ns0、ns1、… 别名。它从不发明词汇表,也从不推断@vocab。
RDF 数据集不保留来自 Turtle、JSON-LD 或其他源语法的前缀声明。当这些声明属于应用策略时,请显式提供它们。所有可配置的接口都消费同一个封闭的 version-1 JSON 文档,并在输出之前拒绝重复成员、未知字段、无效上下文、只能经网络获取的上下文引用、环以及超出资源上限的情况。
{
  "version": 1,
  "mode": "context",
  "prefixes": {
    "ex": "https://example.org/",
    "schema": "https://schema.org/"
  },
  "yaml_schema_url": "https://example.org/purrdf.schema.json"
}
Rust
#![allow(unused)]
fn main() {
use purrdf::{
    JsonLdSerializeOptions, SerializeGraph, parse_dataset, serialize_dataset,
    serialize_dataset_to_jsonld_with_options,
};

let dataset = parse_dataset(
    b"<https://example.org/alice> <https://schema.org/name> \"Alice\" .",
    "application/n-triples",
    None,
)?;
let options = JsonLdSerializeOptions::prefixes([
    ("ex", "https://example.org/"),
    ("schema", "https://schema.org/"),
])?;
let jsonld = serialize_dataset_to_jsonld_with_options(&dataset, &options)?;
assert!(jsonld.contains("\"schema:name\""));
let reopened = parse_dataset(jsonld.as_bytes(), "application/ld+json", None)?;
assert_eq!(
    serialize_dataset(&reopened, "application/n-quads", SerializeGraph::Dataset)?,
    serialize_dataset(&dataset, "application/n-quads", SerializeGraph::Dataset)?,
);
Ok::<(), purrdf::RdfDiagnostic>(())
}
当同一个应用上下文用于许多数据集时,请保留一个 CompiledJsonLdContext(或 JsonLdSerializeOptions::compiled)。JsonLdContextRegistry 只从调用方提供的不可变本地文档中解析上下文 IRI 与 @import;PurRDF 从不经由网络加载上下文。
CLI
把带版本的文档写入文件,然后把它传给任何产生 RDF 的 CLI 路径:
purrdf --jsonld-options context.json convert --from turtle --to jsonld input.ttl output.jsonld
对于非 JSON-LD/YAML-LD 输出、规范化输出、非图形式的 SPARQL 结果以及载体投影,该选项会被拒绝,而不是被忽略。
Python
import json
import purrdf

options = json.dumps({
    "version": 1,
    "mode": "context",
    "prefixes": {"ex": "https://example.org/"},
})
context = purrdf.CompiledJsonLdContext(options)
text = purrdf.serialize_jsonld(
    nquads,
    format=purrdf.RdfFormat.N_QUADS,
    output_format="jsonld",
    context=context,
)
Store.dump、MutableDataset.dump、不可变的 RdfDataset 以及 RDFLib 兼容层的 Graph.serialize 接口都接受同一配置。在兼容层图上显式绑定的前缀,会成为其调用方上下文。
JavaScript 与 WebAssembly
const options = JSON.stringify({
  version: 1,
  mode: "context",
  prefixes: { ex: "https://example.org/" },
});
const context = new CompiledJsonLdContext(options);
const text = dataset.serializeWithContext("jsonld", context);
一次性请求请使用 serializeConfigured。QueryEngine 为 CONSTRUCT 与 DESCRIBE 图结果提供对应的可配置方法,playground 的 worker 在其序列化路径上也接受同一份选项文档。
C
用 purrdf_jsonld_context_compile 编译选项,用 purrdf_serialize_jsonld_configured 复用返回的 PurrdfJsonLdContext,然后用 purrdf_jsonld_context_free 释放它。序列化器只接受恰好一个选项字节切片或一个已编译句柄。缓冲区与错误仍遵循 libpurrdf 通常的所有权规则。
YAML-LD 使用同一个上下文透镜(context lens)。其可选的模式 URL 只改变确定性的 YAML 语言服务器头部;它不改变 RDF 语义。
规范化与差异比较
逐字节确定的序列化(编解码器与确定性)意味着_同一个数据集_总是输出相同的字节。规范化是更强的性质:两个_不同的、彼此同构的内存数据集_——即在空节点重新标记意义下相同的图——会规范化为相同的字节。
RDFC-1.0
PurRDF 在内核中原生实现了 W3C RDF 数据集规范化(RDFC-1.0),并依据 W3C rdf-canon 测试夹具套件进行测试(65 个向量——64 个求值用例加 1 个负例——全部通过;参见 docs/CONFORMANCE.md)。
入口点是 canonicalize(另有 canonicalize_with 变体用于选择哈希),它产出规范的空节点标签,并在上一层的 purrdf-rdf 中,基于冻结的 IR 产出规范的扁平 N-Quads:
#![allow(unused)]
fn main() {
use purrdf::{canonicalize, parse_dataset};

let ds = parse_dataset(b"_:source <https://example.org/name> \"Alice\" .", "application/n-triples", None)?;
let renamed = parse_dataset(b"_:renamed <https://example.org/name> \"Alice\" .", "application/n-triples", None)?;
let canon = canonicalize(&ds);
// 规范标签在不同运行、不同宿主与不同语言绑定之间保持稳定。
assert_eq!(canon.nquads, canonicalize(&renamed).nquads);
Ok::<(), Box<dyn std::error::Error>>(())
}
当需要为图确定内容身份时,使用规范化:哈希、签名、去重,或比较由不同写出器产生的数据集。
带源归属的原生重新标记
当下一阶段消费的是原生数据集时,使用 canonical_relabel。它保留 RDF 1.2 项、具体化节点、注解、图声明与源位置,而无须呈现并重新解析一份规范文档。
当编译器或分析器必须把源节点与该结果关联起来时,使用 canonical_relabel_with_mapping。它在同一次重建中、经过一次规范标签搜索之后,记录实际的项映射:
#![allow(unused)]
fn main() {
use purrdf::{canonical_relabel_with_mapping, datasets_isomorphic, parse_dataset, TermRef};

let source = parse_dataset(b"<https://example.org/alice> <https://example.org/knows> _:friend .", "application/n-triples", None)?;
let source_node = source.term_id_by_iri("https://example.org/alice").ok_or("source IRI not interned")?;
let result = canonical_relabel_with_mapping(&source)?;
let output_node = result.map_term(source_node).ok_or("source node not retained")?;
let canonical_value = result.dataset().resolve(output_node);
assert!(matches!(canonical_value, TermRef::Iri("https://example.org/alice")));
// 在此把源回执与所有者元数据关联到 canonical_value。
let canonical_dataset = result.into_dataset();
assert!(datasets_isomorphic(source.as_ref(), &canonical_dataset));
Ok::<(), Box<dyn std::error::Error>>(())
}
source_node 必须属于确切的那个输入数据集;output_node 属于本结果。来自另一数据集、索引相同的 ID 无法被检测出来。该映射包括嵌套的三元组组成部分、字面量数据类型、复合嵌入的空节点与已驻留的 IRI、具体化节点与注解项,以及空的命名图。被重写省略的未使用字典条目返回 None。
该映射为每个源项使用四个字节,查找为常数时间。现有的 canonical_relabel API 不会分配它。该映射不是持久的身份或证明凭证:应把已解析的 RDF 身份与经过认证的输入和输出回执一起持久化,绝不要持久化原始的 TermId 值。源角色与立场(standpoint)归属仍然是调用方的元数据,而不是规范标签的推论。
在 RDF 1.2 构造之上:两种形式,以不同的名字区分
RDFC-1.0 没有具体化节点、注解或三元组项的概念。纯 RDF 1.1 的数据集在 PurRDF 中处处以相同方式规范化;携带这些构造的数据集则以两种形式之一规范化,而所持有的是哪一种,本身就是身份的一部分:
- 扁平形式——
purrdf-rdf中的canonical_flat_nquads先把陈述层重写为普通的rdf:reifies/ 注解三元组,再在符合规范的 RDFC-1.0 下对_该_三元组集合进行规范化。CLI 的convert --canonical、wasm 的Dataset.canonicalize()以及 W3C 一致性关卡运行的都是这一形式。 purrdf-rdfc12v2 profile——purrdf-core中的canonicalize保留陈述层,并改为将其降级到保留的urn:purrdf:rdfc:命名空间中(任何已经携带该命名空间的输入都会被拒绝,除非它以该 profile 自身所输出的两种形态之一写成——这些形态会折叠回陈述层,这正是规范化在其自身输出上具有幂等性的原因)。它仅在 RDF 1.1 子集上与 RDFC-1.0 逐字节一致,对其输出所取的摘要不得标记为 RDFC-1.0;CANON_PROFILE_ID/CANON_PROFILE_VERSION在运行时指明该 profile。规范性文本是docs/RDF12-CANON-PROFILE.md。
同构
datasets_isomorphic(a, b) 判定两个冻结的数据集是否在 RDF 结构上同构:即在同一个空节点双射下具有相同的四元组、具体化节点绑定与注解。规范化给出等价的裁决——两个数据集同构,当且仅当它们的规范化结果相等——但直接检查是测试与测试框架中更方便的形式。例如,PurRDF 自己的一致性测试框架使用 RDFC-1.0 同构来比较 SHACL Rules 的输出图与预期的推理图。
Diff
dataset_diff(a, b) 在两个冻结的数据集之间产生结构化 diff,其中包括一个 isomorphic 裁决。对于面向人工审阅的流程,purrdf-rdf 还提供按主语的对称 CBD(Symmetric-CBD)提取(“describe”)以及一个便于审阅的 Turtle 归一化器,从而使图的变更读起来就像代码变更。
选择合适的工具
| 需求 | 使用 |
|---|---|
| 同一数据集 → 相同字节 | 任何原生序列化器(始终成立) |
| 同一_图_(在空节点意义下)→ 相同字节,RDF 1.1 子集 | RDFC-1.0(canonicalize 或 canonical_flat_nquads,此处二者相同) |
| 带具体化节点/注解的同一_图_ → 相同字节 | canonical_flat_nquads(在扁平化层上运行 RDFC-1.0)或 canonicalize(purrdf-rdfc12 profile)——二者不可互换 |
| 「这两个数据集是同一张图吗?」 | datasets_isomorphic |
| 「这两个数据集之间有什么变化?」 | dataset_diff + describe/normalize |
| 图的内容寻址传输 | GTS(BLAKE3 内容 id) |
API 细节见 docs.rs/purrdf-core(canonicalize、datasets_isomorphic 与 dataset_diff 条目)与 docs.rs/purrdf-rdf(describe 与归一化)。
SPARQL:查询
PurRDF 的 SPARQL 栈为原生实现,分为三层,并以 W3C SPARQL 1.1 与 1.2 一致性测试套件把关:
purrdf-sparql-algebra—— 把查询与更新文本解析为由 PurRDF 自有、原生支持 RDF 1.2 的查询代数(Query/GraphPattern、Update/GraphUpdateOperation)。仅负责解析与代数。purrdf-sparql-eval—— 基于冻结 IR 的DatasetView的多重集求值器,完全在驻留的TermId空间中运行。purrdf-sparql-results—— 结果边界(下一章)。
三者都在 purrdf::sparql 下重新导出。
第一个查询
#![allow(unused)]
fn main() {
use purrdf::{RdfDatasetBuilder, RdfLiteral, SparqlEngine, SparqlRequest, SparqlResult};
use purrdf::sparql::NativeSparqlEngine;

// 驻留 TermId 空间中的一个微型数据集。
let mut b = RdfDatasetBuilder::new();
let cat = b.intern_iri("https://example.org/cat").expect("subject");
let says = b.intern_iri("https://example.org/says").expect("predicate");
let meow = b.intern_literal(RdfLiteral::simple("meow")).expect("object");
b.push_quad(cat, says, meow, None).expect("quad");
let ds = b.freeze().expect("freeze");

// 通过 SparqlEngine 扩展点求值;解析后的计划会被记忆化缓存。
let engine = NativeSparqlEngine::new();
let result = engine.query(&ds, SparqlRequest {
    query: "SELECT ?what WHERE { <https://example.org/cat> <https://example.org/says> ?what }",
    base_iri: None,
    substitutions: &[],
}).expect("evaluates");

if let SparqlResult::Solutions { rows, .. } = result {
    assert_eq!(rows.len(), 1);
}
}
SparqlEngine trait 本身位于 purrdf-core 中,因此宿主可以在同一个扩展点背后替换引擎;NativeSparqlEngine 是随附的实现。
前端覆盖的范围
- 查询 —— 全部四种查询形式(SELECT/ASK/CONSTRUCT/DESCRIBE)、基本图模式、
OPTIONAL、UNION、MINUS、GRAPH、FILTER/BIND/VALUES、属性路径、GROUP BY/聚合、EXISTS/NOT EXISTS、解修饰符、RDF 1.2 引用三元组项(<<( s p o )>>)、LATERAL(SEP-0006 扩展,见下文),以及 SEP-0009 复合数据类型及其FOLD聚合与UNFOLD图模式(见下文)。 - 更新 ——
INSERT DATA/DELETE DATA、DELETE/INSERT … WHERE系列(WITH/USING、DELETE WHERE)、LOAD,以及CLEAR/DROP/CREATE/ADD/MOVE/COPY。 - 语法之外 —— 其余一切都经由本页后文描述的、由调用方提供键的扩展点进入,绝不以新语法的形式出现:路径见证、全文检索、GeoSPARQL 与嵌入最近邻,各自都是注册在调用方所提供 IRI 下的一个属性函数(对
geof:系列而言,则是标量函数)。
超出这一接口的任何内容——以及每一个格式错误的查询——都是带类型的 ParseError,绝不会是静默降级的解析结果。
命名图的生命周期
默认策略 GraphExistenceMode::RememberEmpty 会从命名图创建起一直记住它,直到它被删除,无论它是否包含行。CREATE 注册一个空槽位,并拒绝重复创建,除非使用 SILENT;CLEAR 以及移除图的最后一行都会保留槽位,DROP 则移除槽位。缺失的 CLEAR 或 DROP 目标图,或缺失的 ADD、COPY 或 MOVE 源图,会在任何更改发生之前被拒绝,除非使用 SILENT。常量和变量形式的 GRAPH 查询都能看到声明的空图。默认图始终存在。
GraphExistenceMode::Implicit 是退出选项,保留 3.x 基于行的生命周期:CREATE 不注册槽位,CLEAR 和 DROP 都会移除命名图。通过 MutableDataset::new_with_graph_existence 或 QueryOptions::with_graph_existence 选择它。
Python 通过 Store(remember_empty_graphs=False) 或 MutableDataset(remember_empty_graphs=False) 选择同一策略;该关键字参数默认为 True。两者共享的 add_graph 和 named_graphs 方法使用原生命名节点或空白节点图名称。UPDATE、受治理的 UPDATE、Store.checkpoint 和 MutableDataset.compact 都保留该选择。WebAssembly 通过 new Dataset(false) 或 Dataset.parse(input, format, base, false) 选择它;C ABI 通过 purrdf_graph_from_dataset、purrdf_update_governed、purrdf_update_governed_xpath_regex 或 purrdf_update_governed_with_geo 的 graph_existence 参数传入 PURRDF_GRAPH_EXISTENCE_IMPLICIT 选择;命令行则通过 purrdf update --graph-existence implicit 选择。通过 TriG、JSON-LD 和 TriX 加载及导出声明的空图,在两种模式下都能工作;模式是变更策略,而非序列化数据。停止的 UPDATE 不发布任何内容,包括此前操作建立的声明。
求值器的工作方式
- 多重集(bag)语义 —— 按照 SPARQL 代数,解是一个多重集,在
DISTINCT/REDUCED之前一直保持。 - 驻留求值 —— 常量只解析一次,得到数据集中的
TermId;解的比较是整数比较;计算出的 FILTER/BIND 值若已存在于数据集中,会在生成时提升为驻留 id。 - 引擎内属性路径 —— 完整的路径代数(
* + ? / | ^ !())在同一个带索引的接口上求值,且 wasm 安全。 - 基于代价的 BGP 规划 —— 连接顺序由代价模型选定;
NativeSparqlEngine::explain_query以三元组模式字符串的有序列表形式公开所选顺序,从而无需运行查询即可审查规划器的决策。 EXISTS/NOT EXISTS,有据可依 —— 采用单一的、基于替换的定义(SEP-0007),其应答要么来自记忆化的存在性探测,要么来自逐行定义本身,二者按调用位置由预备阶段的可采纳性证明选定——见下文。- SERVICE 扩展点——
SERVICE联邦查询通过一个宿主可注入的ServiceResolver求值:引擎本身不执行任何 I/O,因此联邦查询可以移植到 wasm,并由宿主决定如何(以及是否)到达远程端点——细到逐服务的请求头、凭据与能力(见下文)。止步于何处:PurRDF 不附带 HTTP 客户端(交换是一个由 Rust 宿主实现的HttpTransporttrait)。CLI、Python 与 C 接口不安装解析器,wasm 包的同步方法同样不安装,因此那里的SERVICE或LOAD会按名称失败,除非写了SILENT。wasm 包的异步方法接受宿主提供的解析器——作业经由 JSPI 挂起、等待其应答的 JavaScript 处理函数(见入门:JavaScript)。联邦查询是宿主的组合。全部七个 W3Cservice联邦查询用例都经由这个扩展点通过。被转发的主体经由确定性的序列化器重新输出——这就是联邦查询的线上格式——其解析 → 序列化 → 再解析的保真度在 823 项语料上做了扫描(每一个随库固化的 W3C 与第一方查询和更新文本,外加本书自己的示例),例外台账为空。 - 受治理的孪生入口与 explain 回执 —— 每个查询/更新入口都有一个受治理的对应入口,在调用方设定的上限(燃料(fuel)、答案行数、中间单元格数、暂存字节数、远程请求数、截止时间)下运行,触发时给出经认证的行,而不是错误答案;
explain_query返回一个QueryExplanation,其台账按代数节点与计费点分解所消耗的燃料,并附上代价规划器对每个基本图模式的估计。规范性计费表与冻结的 54 例 governor(执行调控器)语料记录在docs/SPARQL-GOVERNOR-PROFILE.md中。 - 硬失败 —— 超出范围的代数节点或未实现的内置函数都是带类型的
EvalError::Unsupported,绝不会是部分或错误的答案。
数值限制
PurRDF 对任意大小的 xsd:integer 与 xsd:decimal 都做精确计算。XSD 1.1 允许处理器限制这两个值空间,前提是至少支持 16 位十进制数字,并把限制写进文档。PurRDF 不限制它们:
| 数据类型 | 取值 |
|---|---|
xsd:integer、xsd:nonNegativeInteger、xsd:positiveInteger、xsd:nonPositiveInteger、xsd:negativeInteger | 该类型符号范围内的每个整数,长度不限 |
xsd:long、xsd:int、xsd:short、xsd:byte 以及各无符号类型 | 该类型自身的范围 |
xsd:decimal | 每个十进制小数,长度不限,小数点后最多 4,294,967,295 位 |
放得进有符号 128 位整数、或放得进小数点后最多 18 位的有符号 128 位尾数的值,用机器算术计算;其余的值用任意精度表示计算,结果相同。+、- 与 * 都是精确的:"170141183460469231731687303715884105727"^^xsd:integer + 1 是 170141183460469231731687303715884105728,0.1 * 0.1 * 0.1 是 0.001。
除法与数值类型转换遵循以下精度规则:
- 除法。 F&O 把十进制商的精度留给实现决定。默认情况下,PurRDF 保留有限小数商的全部位数,即使超过 18 位:
1 / 1048576是0.00000095367431640625。无限循环小数商则保留 18 位,按最近偶数舍入:2 / 3是0.666666666666666667。调用方可以选择别的精度:Rust 中用QueryOptions::with_division,命令行中用--division,C、WebAssembly 与 Python 绑定中用各自的除法设置。设置写作exact、N(N 位,向零截断)、N:ROUNDING(例如5:half-even)或exact-or-N[:ROUNDING]。使用exact时,所有有限小数商均保持精确;无限循环小数商(例如1 / 3)会产生表达式错误(err:FOAR0002),结果保持未绑定。AVG在同一设置下做除法。 - 转换为
xsd:float或xsd:double。 无论大小,都从精确值出发只舍入一次,取最接近的值,平局取偶。 - 从
xsd:float或xsd:double转换为xsd:decimal。 每个二进制值都是有限小数,所以转换结果就是它的精确值:xsd:decimal("0.1"^^xsd:double)是0.1000000000000000055511151231257827021181583404541015625。
其余情况都是错误,表达式无绑定:1 / 0 是 err:FOAR0001;超出派生类型的值(xsd:byte(300))或格式错误的词法形式是 err:FORG0001;把 NaN 或无穷大转换为 xsd:decimal 或整数类型是 err:FOCA0002;非数值操作数是 err:XPTY0004。受调控的查询会在其证据(GovernorEvidence::expression_errors;受调控的 purrdf query 会把这些计数写到 stderr)中按代码计数它吸收的每个错误,purrdf_xsd 报告的每条错误消息都以其代码结尾,例如 (err:FORG0001)。派生整数类型的取负与绝对值是 xsd:integer,所以 -("5"^^xsd:unsignedByte) 是类型为 xsd:integer 的 -5。小数点后超过 4,294,967,295 位的十进制数是 err:FOAR0002;这样的值任何内存都放不下。
任意大小的比较
任意长度的数值都精确比较:比较运算符、=、!=、IN、ORDER BY、MIN、MAX,以及 cdt:List 的元素。数值与 xsd:float 或 xsd:double 比较时,遵循 SPARQL 向该类型的提升;ORDER BY 例外,它比较精确值,以保证排序可传递。
PREFIX xsd: <http://www.w3.org/2001/XMLSchema#>
SELECT ?big WHERE {
  VALUES ?big { "100000000000000000000000000000000000000001"^^xsd:integer }
  FILTER(?big > "100000000000000000000000000000000000000000"^^xsd:integer)
}
这个查询会绑定 ?big。SHACL 范围约束、ShEx 数值 facet、CSVW 数据类型 facet,以及 OWL 2 的值同一性,都以同样精确的方式比较数值。ShEx 按 facet 边界的原始写法精确比较,所以 MININCLUSIVE 100000000000000000001 和 MAXEXCLUSIVE 0.30000000000000001 的每一位都会保留。OWL 2 RL 的值同一性在精确数值与 double 之间也精确比较,所以 100000000000000000000000000000000000000000 与 100000000000000000000000000000000000000001 都不同于 double 1.0E41。
SUM 与 AVG
SUM 精确累加其值,无论总和多大都返回精确总和。AVG 在每个分组上都是 SUM 在除法设置下除以 COUNT,所以两者总是一致。整数 170141183460469231731687303715884105727 与 170141183460469231731687303715884105726 的平均值是 "170141183460469231731687303715884105726.5"^^xsd:decimal。每个结果都是其数据类型的值,并能原样读回。
资源调控
长数值的计算比短数值更费资源,而一个很短的查询就能造出长数值:把 0.1 平方二十次,得到的十进制数超过一百万位。对超出机器字表示的值所做的每次运算,都会在运行前计入 governor(执行调控器):其工作量计入 fuel 上限,其工作内存计入 scratch 字节上限。结果的渲染也会计入,所以百万位的平方在写出时就要付费。所有数值都放得进机器字表示的查询不会多付任何代价。参见 docs/SPARQL-GOVERNOR-PROFILE.md。
预绑定变量
预备执行的参数和请求的替换会在求值前绑定变量。预绑定变量在整个求值过程中、在每一层深度上都是同一个值:OPTIONAL 或 MINUS 的右分支、子 SELECT 以及 EXISTS 体都能看到它,并且它会作为常量越过 GROUP BY,因此 SELECT $this (COUNT(*) AS ?c) 返回所绑定的节点。由此得出两条规则。
- 赋值与所绑定的值连接。 若
?p已在作用域内,BIND(… AS ?p)就不是合法的 SPARQL 查询(§18.2.1),无论是否预绑定都会解析失败。其他每个赋值都在赋值之处与所绑定的值连接(§18.5),在每一层深度上都是同一条规则,未投影?p的子SELECT和EXISTS主体也不例外:没有任何作用域拥有自己的?p。当?p绑定为:a时,赋值:z使该赋值所在的模式没有任何行,因此?x :p ?o BIND(:z AS ?p)和{ SELECT ?o WHERE { ?x :p ?o BIND(:z AS ?p) } }无论单独出现还是与其他模式并列都不返回任何结果,而OPTIONAL { BIND(:z AS ?p) }让每个左侧行保持未扩展。赋值:a本身则保留这些行;表达式出错的赋值使?p保持所绑定的值。 MINUS的两侧都能看到所绑定的值,无论该侧是否提及?p,因此右侧每一行都与左侧每一行共享?p并将其减去:只要:q有一个三元组,?x :p ?o MINUS { ?s :q ?w }就不返回任何行,与?x :p ?o MINUS { ?p :q ?w }相同;右侧没有行时则不减去任何行。
rdflib 7.6 的 initBindings 不是这一行为的参照:查询在何处为预绑定名称赋值,它就在何处重新绑定该名称,因此那里的赋值会覆盖所绑定的值,而不是与之连接。原生查询 API 在每一层深度上都遵循上述单一的连接规则。
VALUES ?p { … } 在其书写之处与所绑定的值做连接,且在任何深度都遵循同一规则:它只保留与所绑定值一致的行,因此在 $this 绑定为 ex:a 时,VALUES $this { ex:b } 没有任何行。在查询的 WHERE 组中,这意味着不返回任何行;在 OPTIONAL 分支中,它使左侧每一行保持未扩展;在 MINUS 操作数中,它不减去任何行;在未投影该名称的子 SELECT 中,它使该子 SELECT 没有任何行,无论单独出现还是与其他任何模式并列。子 SELECT 产生的每一行在去重或分组之前都带有所绑定的值,因此其中的 SELECT DISTINCT 和 GROUP BY ?p 无论与其他模式并列还是单独出现,答案都相同。
SHACL 更为严格。SHACL 1.2 SPARQL Extensions 附录 A 禁止在以预绑定变量执行的查询中使用 MINUS、提及预绑定名称的 VALUES 以及针对预绑定名称的 AS,SHACL 通道会在加载形状图时拒绝它们。VALUES 规则因通道而异:
- 节点表达式和
sh:expression,与sh:SPARQLFunction函数体和sh:SPARQLTargetType查询一样,只拒绝提及预绑定名称的VALUES,与附录 A 的措辞一致:VALUES ?v { true }可以加载。 sh:sparql约束,与基于 SPARQL 的组件验证器、sh:SPARQLTarget的sh:ask以及 SPARQL 规则一样,拒绝所有VALUES。随库固化的 W3C SHACL 用例unsupported-sparql-002要求拒绝VALUES ?any { true },而其中的?any并非预绑定变量。
参见 SHACL 验证。
rdflib 兼容层在 Rust 中编译上下文映射,并通过共享的原生求值器执行。purrdf.compat.rdflib.Graph.query(..., initBindings=...) 将初始绑定与返回映射分开,允许 RDFLib 的变量重新赋值,包括嵌套组、OPTIONAL、MINUS、EXISTS 和分组。公开结果保留原始变量名,并不迭代空的投影映射。Store.query、Store.prepare 和 SHACL 保留其原生预绑定和赋值规则。
数值转换
xsd:double(?x) 这类 XSD 构造函数遵循 XPath and XQuery Functions and Operators 3.1 §19 的转换规则。SPARQL 1.1 §17.5 的转换表引用的是更早的 XQuery 1.0 and XPath 2.0 Functions and Operators;PurRDF 采用 3.1 的文本。参数是数值或布尔字面量时,转换的是它的值,而不是把字面量的数字按新类型重新读取一遍。写作 0.1 的 float 的值是 0.100000001490116119384765625,所以 xsd:double("0.1"^^xsd:float) 是 1.0000000149011612E-1。字符串参数按文本解析:xsd:double("0.1") 是 1.0E-1。
| 源类型 | 目标类型 | 结果 |
|---|---|---|
| float | double | 同一个值,精确无误 |
| double | float | 最接近的 float,平局取偶(见下文) |
| integer、decimal | float、double | 最接近的值,只舍入一次 |
| float、double | decimal | 精确值;NaN 与 INF 为错误 |
| float、double、decimal | 整数类型 | 舍去小数部分,与大小无关;NaN、INF 以及超出目标类型范围的值为错误 |
| boolean | 数值 | 1 或 0 |
| 数值 | boolean | 零和 NaN 为 false,其余为 true |
把 float 或 double 转换为 xsd:string 时,绝对值从 0.000001(含)到 1000000(不含)的数用普通记数法("0.1"、"123456.5"、"100")。其余的值用科学记数法,小数点后至少一位数字("1.0E7"、"1.0E-7")。特殊值写作 "NaN"、"INF"、"-INF" 和 "-0"。数字位数取按源类型自身精度读回同一个值所需的最少位数,因此 xsd:string("0.1"^^xsd:float) 是 "0.1"。STR 不做转换:它原样返回字面量的词法形式。
double 转 float:舍入到最近
PurRDF 在这里有意不遵循 F&O 3.1 §19.1.2.1 的文字。该文字通过截断二进制尾数把 double 收窄为 float。PurRDF 则像 IEEE 754 一样舍入到最近的 float,平局取偶数值。理由如下:
- 精度。 结果与 double 的差距不超过末位的半个单位,且误差无偏。截断的误差可接近一个完整单位,而且总是偏向零。
- 处处同一种舍入。 XSD 1.1 用这种舍入(
floatingPointRound)把词法形式映射为 float,PurRDF 对字符串、decimal 和 integer 也已经采用它。若用截断,一个 double 得到的 float 会与写成字符串的同一个数得到的 float 不同。 - 与常见引擎一致。 常见的 SPARQL 和 XPath 引擎都采用舍入。
- 该文字对极小值有缺陷。 按其规则,凡低于最小正规指数的结果都变为零,即使有更接近的 float 次正规数。在这里
xsd:float("1e-40"^^xsd:double)是1.0E-40,而不是零。
下面两个值显示了两种规则的区别:
| 表达式 | PurRDF(舍入到最近) | F&O 3.1 文字(截断) |
|---|---|---|
xsd:float("1.0000000894069671630859375"^^xsd:double) | 1.0000001E0 | 1.0E0 |
xsd:float("3.4028235677973366e38"^^xsd:double) | INF | 3.4028235E38 |
第二个 double 恰好位于最大的 float 与下一个二的幂之间的正中,因此平局取偶得到 INF。
计算所得数值的拼写
规范只确定计算所得数值的值及其数据类型,并不确定承载该数值的字面量的词法形式。PurRDF 的拼写方式如下。
- 由运算符、函数或聚合计算得出的十进制数带有小数点和至少一位小数:
84 / 2为42.0,CEIL(3.2)为4.0,对4.2与37.8做SUM为42.0,对2与4做AVG为3.0。带小数部分的十进制数保持不变(2.5)。 - 类型转换与构造函数、
xsd:integer结果以及xsd:float/xsd:double结果保持 XSD 1.1 的规范文本:xsd:decimal(3)为3,对整数做CEIL(3)为3。 - 一元加号是恒等运算,按原样返回其操作数,因此保持操作数的拼写:存储的
"4.0"^^xsd:decimal仍为4.0,+(1.5 + 2.5)仍为4.0,因为被计算的操作数就是4.0。一元减号会计算出新的数,因此对十进制数4取负为-4.0。 STR原样返回字面量的词法形式,因此STR(1.5 + 2.5)为"4.0"。xsd:string(...)及其他转为字符串的类型转换使用该值的 XPathfn:string文本,因此xsd:string(1.5 + 2.5)为"4"。当存储或计算所得字面量的拼写很重要时,请使用STR。SECONDS按 SPARQL 文本的定义,原样返回参数词法形式中的秒字段:对"2023-12-25T10:30:00"^^xsd:dateTime为00,对"2023-12-25T10:30:05.500"^^xsd:dateTime为05.500,对"10:30:00.250"^^xsd:time为00.250。每个参数都是 RDF 项,因而都有词法形式:由表达式计算得出的 dateTime(例如 dateTime 加上时长)是词法形式为规范形式的字面量,SECONDS读取的就是该形式。SPARQL 1.1 的seconds-01测试对秒字段01、02、00、03期望"1"、"2"、"0"、"3",并按值判分;没有任何拼写能同时让它与 SHACL 节点表达式的seconds-example(期望"00")逐项一致。- 以上规则适用于
purrdf-xsd中的算术与 SPARQL 求值器。其他计算所得的十进制数有各自的拼写:文本检索与检索扩展(purrdf-text、purrdf-retrieval)的得分是带固定 12 位小数的xsd:decimal字面量。
比较数值结果时应按值而不是按拼写:"3"^^xsd:decimal 与 "3.0"^^xsd:decimal 是同一个数,却是不同的 RDF 项。
SPARQL 1.2 时间运算与调整
+、-、*、/ 以及一元 - 的适用范围超出数值类型体系,扩展到 xsd:dateTime/xsd:date/xsd:time(时刻)、xsd:duration 及其两个子类型 xsd:dayTimeDuration/xsd:yearMonthDuration,以及五种公历部分日期类型(xsd:gYearMonth、xsd:gYear、xsd:gMonth、xsd:gMonthDay、xsd:gDay)。SPARQL 1.2 Query 规范自身的正文未定义数值类型体系之外的任何运算;唯一有文档记载的表格来自 SEP-0002,本节的覆盖范围即依照该表。ADJUST(见下文)是 SEP-0002 其余的、非运算类的新增内容。
时间值中的秒保留全部小数位。例如,把 "PT0.000000000000000000009S"^^xsd:dayTimeDuration 加到 "2024-01-02T03:04:05.123456789012345678901Z"^^xsd:dateTime,结果是 "2024-01-02T03:04:05.12345678901234567891Z"^^xsd:dateTime;SECONDS 返回 05.12345678901234567891。结果不会截断到 18 位小数。即使时长中的整天数超出机器整数范围,time 按整天平移后仍会回到同一日内时刻。
运算符表
SEP-0002 的表格共有 24 行:其中 11 行是比较(两个 yearMonthDuration 之间或两个 dayTimeDuration 之间的 </>,两个 duration 之间的 =,以及两个 date 之间或两个 time 之间的 =/</>),已由普通的值比较覆盖。其余 13 行是运算:
| 操作数 | 结果 |
|---|---|
date - date | dayTimeDuration |
date + yearMonthDuration | date |
date - yearMonthDuration | date |
date + dayTimeDuration | date |
date - dayTimeDuration | date |
time - time | dayTimeDuration |
time + dayTimeDuration | time |
time - dayTimeDuration | time |
dateTime - dateTime | dayTimeDuration |
dateTime + yearMonthDuration | dateTime |
dateTime - yearMonthDuration | dateTime |
dateTime + dayTimeDuration | dateTime |
dateTime - dayTimeDuration | dateTime |
PREFIX xsd: <http://www.w3.org/2001/XMLSchema#>
SELECT ?diff WHERE {
  BIND("2002-01-02T10:00:00"^^xsd:dateTime - "2001-01-01T10:00:00"^^xsd:dateTime AS ?diff)
}
除这张表外,purrdf 还在上表每一行接受一般的 xsd:duration(SEP-0002 把 xsd:duration 列为运算符表所覆盖的操作数类型之一,且这一一般类型自身的值空间包含两个子类型),接受 duration ± duration、duration ×/÷ 精确数,以及对全部五种公历类型的公历值 ± duration——前提是结果无需捏造缺失的字段(见下文分歧):
PREFIX xsd: <http://www.w3.org/2001/XMLSchema#>
SELECT ?next WHERE {
  BIND("2012-10"^^xsd:gYearMonth + "P1Y1M"^^xsd:yearMonthDuration AS ?next)
}
结果数据类型
两个 duration 之间的 +/-,其结果的数据类型由操作数的声明标签决定,绝不由计算出的分量值决定:当且仅当每个 duration 操作数都声明为 dayTimeDuration 时,结果为 dayTimeDuration;当且仅当每个 duration 操作数都声明为 yearMonthDuration 时,结果为 yearMonthDuration;其余情况下为一般的 xsd:duration。以下两个用例使这条规则具体化,因为任意一个单独拿出来,也同样能被一条恰好在那一点上结论一致的、基于分量的规则满足:
零值结果保留其操作数声明的子类型,而不是塌缩为一个泛化的零:
PREFIX xsd: <http://www.w3.org/2001/XMLSchema#>
SELECT ?zero WHERE {
  BIND("P1Y"^^xsd:yearMonthDuration - "P1Y"^^xsd:yearMonthDuration AS ?zero)
}
?zero 为 "P0M"^^xsd:yearMonthDuration——一条只看分量、检查(为零的)结果而非(一致的)声明标签的规则,在这里也会得出同样的答案,这正是需要第二个用例的原因。反过来,一个和的_分量_即便看起来与纯粹的 yearMonthDuration 完全相同,只要两个操作数的声明标签不是同一种 duration 子类型,结果仍会拓宽为一般类型:
PREFIX xsd: <http://www.w3.org/2001/XMLSchema#>
SELECT ?mixed WHERE {
  BIND("P1M"^^xsd:yearMonthDuration + "PT0S"^^xsd:dayTimeDuration AS ?mixed)
}
?mixed 为 "P1M"^^xsd:duration,而不是 "P1M"^^xsd:yearMonthDuration——值为零的 dayTimeDuration 操作数对分量毫无贡献,却仍会拓宽结果的声明类型,因为这条规则读取的是标签,而不是值。
与其他实现的分歧
公历值 ± duration 可能要求一个操作数类型并不携带的字段——把含月份分量的 duration 加到 xsd:gDay 上,需要一个月份来施加该分量,而 xsd:gDay 没有月份。xsd:gMonthDay 会把移位后月份中不存在的日期向下钳制到该月的实际天数,这与 date/dateTime 已遵循的规则相同(XML Schema 附录 E)——但 xsd:gMonthDay 不携带年份,钳制无从依据,因此 purrdf 通过以下方式判断是否需要捏造年份:把_完整的_「先月后日」计算锚定在一个完整的 400 年公历周期中的每一年上(历法的闰年规则恰好以这一长度为周期,因此一个周期就涵盖了所有可能相关的锚点),并检查所有锚点的答案是否一致。当且仅当所有锚点一致时,purrdf 给出答案;当且仅当它们不一致时,返回带类型的错误——对任意大小的 duration 都是如此,而不仅限于有界的/普通的 duration:在任何锚点的运算开始之前,月份与日期的进位先按历法的精确周期(400 年,146,097 天)约简,因此天文数字般巨大的 yearMonthDuration 或 dayTimeDuration 分量,会以同样有界的工作量、按与较小分量相同的方式得出判定。计算是整体评判的,而非逐分量评判:duration 的月份部分可能落在某个中间日期上,其钳制本身依赖于年份,尽管在日期部分也执行之后,_最终_答案并不依赖年份——"--01-31"^^xsd:gMonthDay + "P1M1D"^^xsd:duration 在每个锚点下都是 "--03-01"(2 月 28 日或 2 月 29 日的次日总是 3 月 1 日),尽管 "--01-31"^^xsd:gMonthDay + "P1M"^^xsd:yearMonthDuration 单独来看确实有歧义。被拒绝类别中反复出现的例子是二月:其余每个月在每一年的天数都相同,因此落在这些月份的移位总是安全的;而落在二月、且被钳制的日期为 29 日或更晚的移位,其答案可能取决于一个 xsd:gMonthDay 并不携带的年份——这是被拒绝类别的一个例子,而不是规则本身。RDF4J 对这些情况的应答方式是:借助其底层的 JAXP 日历捏造缺失的字段(第 0 年、一月,或第 1 日),并返回建立在这一捏造之上的值——例如 "---31"^^xsd:gDay + "P1M"^^xsd:yearMonthDuration 的答案是 "---29",这是针对一个捏造出的闰年钳制的结果。在每一个答案不依赖于捏造字段的用例上,purrdf 都与 RDF4J 一致——包括 "2012-10"^^xsd:gYearMonth + P1Y1M = "2013-11",这是 RDF4J 自身测试套件所固定的唯一一个公历用例——而恰恰在答案会取决于 RDF4J 日历碰巧选取了哪个捏造值的地方,返回带类型的错误:
PREFIX xsd: <http://www.w3.org/2001/XMLSchema#>
SELECT ?bound WHERE {
  BIND("---31"^^xsd:gDay + "P1M"^^xsd:yearMonthDuration AS ?maybe)
  BIND(BOUND(?maybe) AS ?bound)
}
?bound 为 false:?maybe 的 BIND 引发的带类型错误被毒化(poison)为未绑定,这是引擎普通的类型错误处理规则。这种毒化也正是这一分歧的界限:在 SPARQL 接口上,带类型的错误,与一个转而_丢弃_自身捏造答案(而非返回它)的参考实现,都会让同一个变量保持未绑定——两者完全相同。「拒绝捏造」与「捏造并返回一个值」之间的可见分歧是真实存在的,但它存在于值空间 API 的边界(一个 Err,对比一个携带具体答案的 Ok),而不在 SPARQL 查询自身的结果中;在那里,拒绝与假想的丢弃呈现方式相同。
超出 SEP-0002 与 F&O 的扩展
purrdf 新增了三个 SEP-0002 以及 XPath and XQuery Functions and Operators(F&O)均未定义的运算符,每一个都立足于一条既有规则,并把它扩展到 F&O 遗漏的类型上:
-
针对 duration 的
SUM/AVG。 SPARQL 1.1 §18.5.1.3 通过反复应用op:numeric-add来定义SUM,其定义域仅为数值类型体系;purrdf把同样的折叠扩展到 duration 群上,该群在逐分量加法下是精确且满足结合律的。PREFIX xsd: <http://www.w3.org/2001/XMLSchema#> SELECT (SUM(?d) AS ?total) WHERE { VALUES ?d { "P1M"^^xsd:yearMonthDuration "P2M"^^xsd:yearMonthDuration } }?total为"P3M"^^xsd:yearMonthDuration。混合了数值与 duration 值的分组保持未绑定——该扩展并不拓宽SUM既有的仅限数值的接受范围,只是新增了第二个互不相交的接受范围。 -
duration 的一元负号。 F&O 的一元负号(§4.2.8)仅限数值,没有定义 duration 形式。
purrdf对 duration 的两个分量同时取负,因此-(?duration)绝不会产生该类型无法表示的混合符号值。一元正号刻意保持仅限数值,因此+(?duration)是类型错误,而-(?duration)不是:PREFIX xsd: <http://www.w3.org/2001/XMLSchema#> SELECT ?neg WHERE { BIND(-("P1Y2M"^^xsd:yearMonthDuration) AS ?neg) }?neg为"-P1Y2M"^^xsd:yearMonthDuration。 -
按值可公度性进行的
duration ÷ duration。 F&O 只定义了两种同子类型的形式(op:divide-yearMonthDuration-by-yearMonthDuration、op:divide-dayTimeDuration-by-dayTimeDuration)。purrdf还接受一般的xsd:duration,并依据两个操作数的_值_是否可公度(均为纯月份,或均为纯秒数)来分派,而不是依据其声明标签,因此一个dayTimeDuration与一个恰好纯粹由天构成的一般xsd:duration仍然可以相除:PREFIX xsd: <http://www.w3.org/2001/XMLSchema#> SELECT ?ratio WHERE { BIND("P30D"^^xsd:duration / "P1D"^^xsd:dayTimeDuration AS ?ratio) }?ratio为30,类型为xsd:decimal。两个值不可公度的操作数(一个纯月份值对一个纯秒数值,即使声明标签一致)是带类型的错误,而不是随意给出的答案。
ADJUST
ADJUST(value, timezone) 把一个 xsd:dateTime/xsd:date/xsd:time 值移到给定的时区偏移,或为不带时区的值附加一个时区。SPARQL 1.2 Query 规范自身的正文没有 ADJUST 一节;该函数唯一有文档记载的定义是 SEP-0002 的双参数签名,它对应 XPath and XQuery Functions and Operators §9.6 的 fn:adjust-*-to-timezone 系列(purrdf-xsd 为其他每一个 SPARQL 1.2 时间内置函数实现的也是同一张表)。
PREFIX xsd: <http://www.w3.org/2001/XMLSchema#>
SELECT ?adjusted WHERE {
  BIND(ADJUST("2011-01-10T14:45:13Z"^^xsd:dateTime,
              "-PT05H"^^xsd:dayTimeDuration) AS ?adjusted)
}
timezone 是位于 [-PT14H, PT14H] 内(仅限整分钟)的 xsd:dayTimeDuration,或空的简单字面量 ""——它是 SPARQL 对 XPath 中表示「移除时区」的空序列参数的替代,因为 SPARQL 本身没有空序列;其他每一个已知的 SEP-0002 实现(例如 Apache Jena 的 E_AdjustToTimezone)得出的也是同一解决方式。参数个数固定为二,并在解析时强制执行——ADJUST(?x) 与 ADJUST(?x, ?tz, ?extra) 都会在求值前被拒绝。每一种定义域或类型违规(非整分钟的偏移、越界的偏移、非时间类型的第一个参数)都是 SPARQL 类型错误;按照引擎普通的类型错误处理规则,它在 BIND、FILTER 或聚合参数内部会被毒化为未绑定,而不会中止查询。
LATERAL(SEP-0006)
SPARQL 1.2 Query 规范自身的正文没有 LATERAL 产生式;唯一有文档记载的定义是 SEP-0006 的定义,已在 Apache Jena 4.7.0 中实现,本节即依照该定义。LATERAL 为 GroupGraphPatternSub 新增一个产生式,与 OPTIONAL/MINUS/ GRAPH 处于同一位置,并以同样的方式左结合:
GroupGraphPatternSub ::= ... | 'LATERAL' GroupGraphPattern
与普通连接不同,LATERAL 的右侧针对其左侧的每一个解各求值一次(ONCE PER SOLUTION),且该解的绑定在右侧内部可见——这与 SQL 中 LATERAL/CROSS APPLY 子查询同其外层查询的关系相同。这使得按分组取「前 N 项」的查询可以用纯 SPARQL 表达:左侧的每个主语在右侧挑选自己最小的标签,而不是只计算一次全局最小的标签、再与每一行连接。
PREFIX : <https://example.org/>
PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>
SELECT * WHERE {
  ?s :p ?o
  LATERAL {
    SELECT * WHERE { ?s rdfs:label ?label }
    ORDER BY ?label LIMIT 1
  }
}
关联会把左侧任意(ANY)RDF 1.2 项类型的绑定——包括空节点或引用三元组——带入右侧,即使该变量在右侧唯一的出现位置是在表达式中(一个 FILTER、一个 BIND、一次 BOUND(?s) 调用),而不是作为三元组模式的叶子:对于左侧绑定的空节点或引用三元组,BOUND(?s) 的应答与对 IRI 或字面量一样正确,而这样的行也不会因为缺少可承载它的叶子出现位置而被静默丢弃。
作用域限制
LATERAL 的右侧可以自由地复用(REUSE)左侧已绑定的变量(这正是其全部意义所在——关联就是这样发生的),但不得为其引入(INTRODUCE)新的绑定:在右侧自身的作用域层级上,BIND 的变量目标、子 SELECT 的 (expr AS ?v) 投影、GROUP BY 聚合的输出、表达式值的 GROUP BY (expr AS ?v) 分组条件,以及 VALUES 列,都不得与左侧已可见的变量冲突。仅仅指名一个已绑定变量的裸 GROUP BY ?v 分组键是一次使用(USE),而不是引入,永远不会冲突。唯一开启新作用域层级的构造是子 SELECT 自身的投影——OPTIONAL/UNION/GRAPH/嵌套分组/嵌套 LATERAL 对此均是透明的。以下是该 SEP 自己给出的一对合法与非法示例:
PREFIX : <https://example.org/>
PREFIX rdfs: <http://www.w3.org/2000/01/rdf-schema#>
# 合法:子 SELECT 只投影 ?label,因此它自身(未投影的)对 ?s 的复用
# 属于关联,而不是引入,不可能发生冲突。
SELECT * WHERE {
  ?s a :T
  LATERAL { SELECT ?label WHERE { ?s rdfs:label ?label } LIMIT 1 }
}
# Illegal — refused with a typed ParseError naming ?o: ?o is already bound by
# the left-hand triple pattern, and BIND tries to give it a NEW value at the
# LATERAL right-hand side's own scope level.
SELECT * WHERE {
  ?s ?p ?o
  LATERAL { BIND(123 AS ?o) }
}
与 Jena 的分歧之处
该限制有两处边角与 Jena 自身的 SyntaxVarScope 检查不一致,每一处都由一个具名测试固定下来,而不是任其漂移:
- 更宽松。 仅限于
MINUS右操作数内的BIND/VALUES/聚合引入,在这里无论处于何种深度都会被接受(ACCEPTED)——无论是直接位于LATERAL关键字之下,还是嵌套在SELECT *子查询之下——而 Jena 会拒绝它。SPARQL §18.2.1 把MINUS-右侧的变量置于作用域之外,§18.5 的求值说明了原因:右操作数仅用于构建与左操作数各行之间的兼容性测试,之后其绑定即被丢弃,因此在MINUS之上构建的任何东西——SELECT *投影或其他任何东西——都永远无法观察到该操作数引入的值。这条规则没有任何可观察的东西可以拒绝。(在这样的右侧上使用SELECT *只是通往同一形态的一条路径,而非另一种形态。) - 更严格。
SERVICE ?g { ... }的端点变量在这里计为左侧作用域;Jena 则忽略它。带变量端点的SERVICE ?g { ... }要求?g在传入的解中已被绑定——端点 IRI 在发起远程调用之前由该绑定解析——因此当LATERAL右侧运行时,?g已持有一个来自左侧、可观察的逐行值,与其他任何左侧绑定的变量无异。因此,右侧用BIND/VALUES赋予它一个新(NEW)值,恰恰是这条规则所要拒绝的那种可观察的重新绑定。
在 UPDATE 中
INSERT/DELETE ... WHERE 与 WITH ... WHERE 与 SELECT 的 WHERE 子句经由同一套分组图模式语法,因此 LATERAL——以完全相同的方式做作用域检查——在那里同样合法。DELETE WHERE 的四元组模板是另一条语法产生式(TriplesTemplate,而非 GroupGraphPattern),不含任何种类的分组模式运算符,因此 LATERAL 出现在那里会被点名拒绝,而不会被误解析为一个主语项。
SERVICE 转发
包含书面 LATERAL 子句的模式——位于转发查询体中的任何位置,包括嵌套在另一个 SERVICE 内部——无论是否写了 SILENT,都会原样带着 LATERAL { … } 文本转发,因此端点的实际裁决——来自支持 LATERAL 的端点的答案(LATERAL 是 Jena 自己的扩展,因此以 Jena 为后端的端点会应答它),或来自未实现它的端点的失败——会以与其他任何转发构造被拒绝时相同的方式呈现:一个错误,或者在 SILENT 下成为连接的单位元并记录在证据中。自定义标量函数调用也以同样的方式转发。变量端点 SERVICE ?g 仅在没有任何东西提供 ?g 的绑定时被拒绝——即传入的解中没有任何东西为远程求值器指名一个可解析的 IRI——而 SERVICE SILENT 不会改变这一点,因为根本没有发出任何调用可供 SILENT 吸收。当外围模式绑定了 ?g——同一分组中位于其前的三元组模式,或 LATERAL 左侧的逐行关联——端点会在发起远程调用之前解析为该 IRI(与上文「与 Jena 的分歧之处」中描述的逐行替换相同),查询照常分派,与带固定 IRI 的 SERVICE 无异:每个传入的解一个请求,因此指明同一 IRI 的两个解各自发出自己的请求。当包含该子句的 OPTIONAL、MINUS 或组连接的左侧在每个解中都绑定了 ?g 时,右侧仍然独立求值,而该子句只向左侧为 ?g 绑定的每个不同 IRI 各发送一次。连接满足交换律,因此当组连接的另一侧绑定 ?g 时——{ SERVICE ?g { … } ?s ex:endpoint ?g }——同样成立;而 OPTIONAL 或 MINUS 只从其左侧获取端点。
逐服务上下文:ServiceResolver 扩展点
SERVICE 通过单一 trait ServiceResolver 应答,它以 ServiceRequest 的形式接收整个请求——端点、转发的查询文本、SILENT 标志、正在执行的查询的停止信号,以及中间单元格上限。随附两个实现:HttpRemoteQuerySource,它通过宿主注入的 HttpTransport 构建并解码 SPARQL Protocol 请求;以及 InProcessServiceResolver,它从已在内存中的数据集作答。
解析器需要了解的关于_单个_服务的一切——额外的请求头、凭据、超时,以及允许它做什么——都存放在解析器上的 ServiceCatalog 中,以服务 IRI 为键。刻意不放在 IRI 本身中:服务 IRI 是一个名称,而不是凭据存储;把上下文编码在那里会使其进入查询文本,从而对编写查询的任何人可见,被序列化进计划与回执,并随嵌套的 SERVICE 查询体一同传播。
ServiceCatalog 把每个服务 IRI 映射到一个 ServiceProfile,每个 profile 授予一组显式的能力:
| 能力 | 授予 |
|---|---|
Query | 解析该服务本身 |
Network | 为解析它而执行网络 I/O |
Credentials | 把该 profile 的凭据附加到请求上 |
目录默认拒绝:没有条目、也没有显式配置回退 profile 的服务会被拒绝。管控是选择加入的——没有目录的解析器,其行为与目录出现之前完全相同,会联系交给它的任何端点,且不添加任何请求头——而配置目录不会改变 profile 未添加任何内容的请求中的任何字节。
扣留 Network 正是使进程内门面_可证明_而非仅仅承诺的关键:InProcessServiceResolver 只拥有一个数据集映射,别无他物——没有传输层,没有套接字,没有注入的回调——因此不存在经由它执行 I/O 的代码路径。于是,宿主可以提供 SERVICE 形态的组合,而无需承担 SERVICE 形态的风险。ServiceRouter 把二者组合起来,将部分服务发往进程内、其余发往网络,由路由表而非查询文本决定哪个去往哪里。每一次解析都会查阅目录,嵌套解析也包括在内,因此埋在转发查询体中的 SERVICE 无法到达目录在顶层拒绝的端点。
该策略在调用传输层_之前_施加,这正是闸门与审计日志之间的全部区别:被拒绝的服务从不会先打开套接字再被丢弃。
服务 IRI 与其他任何 IRI 一样,因此它由工作区唯一的 RFC 3986 基准 IRI 层解析(见 基准 IRI),而不是由该扩展点自创的规则解析。序言中没有 BASE、也没有向 API 传入 base 的 SERVICE <sparql>,会触发共享的 iri-relative-no-base 硬错误,该错误在解析查询时抛出——早于查阅任何解析器,且不会被 SILENT 软化,因为它是针对不应答的端点的承诺,而不是针对无法构成的端点 IRI 的承诺。在有 base 的作用域中,解析器收到的是绝对 IRI,这正是 ServiceCatalog 用作键的形式。
SILENT 契约
SPARQL 1.1 Federated Query §3.2 将 SERVICE 子句定义为端点的应答:“in case of a successful service invocation according to the SPARQL protocol, and otherwise Ω0 in case SilentOp is true, and otherwise error”(依照 SPARQL 协议成功调用服务时为其应答,否则若 SilentOp 为真则为 Ω0,否则为错误)。Ω0 是唯一的空解——连接的单位元,因此外围查询照常进行、不受影响。PurRDF 按字面理解这里的「否则」:
| 结果 | SERVICE | SERVICE SILENT |
|---|---|---|
| 调用因任何原因失败:端点不可达或其响应无法解码;没有任何来源能到达它;某项能力被拒绝或宿主拒绝了该请求;宿主的处理函数发生故障;变量端点绑定到了不是 IRI 的项 | 查询错误 | 连接的单位元,并记录在证据中 |
| 本引擎自身的 governor 被触发,或其栈已耗尽 | 截断,或栈拒绝 | 截断,或栈拒绝 |
SILENT 是关于调用的声明,绝不是关于调用方自身预算的声明,因此经由 SERVICE 子句到达的 governor 触发,无论是否写了 SILENT,都会作为截断向外传播。拒绝是一次没有成功的调用,而查询的作者写下 SILENT 时就已知道该服务可能不会应答。
SILENT 给出的应答与一个没有任何内容可补充的端点的应答无法区分,因此每一次被静默的调用都会被记录下来:GovernorEvidence::silenced 为每一次失败列出一条 SilencedInvocation——端点、失败的种类(transport、decode、disabled、unconfigured、denied、host-denied、not-an-iri、fault),以及该错误本应携带的消息。每一个受 governor 管控的查询都携带它;不受管控的调用只返回裸结果,因此要读取这份记录,请在 QueryGovernors::METERED 下运行。由 InProcessServiceResolver 求值的查询体中嵌套的 SERVICE 所引发的拒绝,会作为其本来面目——结构化的拒绝——传回外层,因此外围子句在每一层深度上都会把它作为拒绝报告出来,或者记录下来。
LOAD SILENT 遵循 SPARQL 1.1 Update §3.1.4:按照该节,操作失败时 “will still return success”(仍将返回成功):无法抓取或无法解析的文档、一次拒绝、一次故障,以及缺少 GraphResolver,都各自是一次不加载任何内容的成功,并在更新的证据中记录为一条指名来源 IRI 的 SilencedInvocation。GraphResolver 以带类型的 LoadError 报告它为何没有产出文档,其 code() 就是不写 SILENT 的 LOAD 失败时所用的诊断代码。
在 MINUS 下,变量端点的左侧解按端点划分,每一部分都由只列出其自身端点而求值的右侧来相减,因此被静默的端点——Ω0,不绑定任何变量——不会移除自己的任何行,而每个应答了的端点仍会移除与之匹配的行。
SEP-0007 下的 EXISTS
SPARQL 1.1/1.2 §18.6 通过两个函数定义 EXISTS/NOT EXISTS:substitute,它依据被过滤的行改写模式中的变量;以及 evalExists,它判断替换后的模式的求值结果是否非空。若按字面的项改写来理解,substitute 在几个确切的点上存在缺陷:
- 仅限变量的位置。
substitute是针对模式中的变量位置(POSITIONS)来表述的,对于Bgp/Path叶子项或GRAPH ?g名称,除了将其视为表达式之外,没有定义任何动作——因此一个仅出现在三元组位置或图名位置的关联变量,没有可以施加的替换。 MINUS定义域翻转。 把MINUS的共享变量作为常量改写掉,恰恰抹去了其定义域连接用以比较两个操作数的那些列,从而把一个关联的MINUS变成无条件不相交的形式——这与代入该行本应保持的东西正好相反。- 作为变量的空节点。 任何 SPARQL 表层语法都无法把空节点或引用三元组写成改写后的常量,因此在字面的项改写下,关联的空节点绑定或引用三元组绑定没有合法的替换形式。
- 不相连的变量。 一个仅(ONLY)能经由嵌套
EXISTS内部的表达式位置到达的关联变量——从不经由该内层自身的三元组模式叶子——在substitute的模式改写解读中,没有任何东西能把它带到那里。 - 赋值限制。 §18.6 自身的正文对于
EXISTS主体重新绑定其所过滤的行上已处于作用域中的变量,没有规定任何规则。
SEP-0007——一份 SPARQL-dev 提案,尚未并入 SPARQL 1.1/1.2 REC 正文——通过把 substitute 重新表述为 Replace(一次连接(JOIN),而不是改写)修复了前四项,并把第五项作为第 3 部分新增为一条限制。purrdf 完整实现了 SEP-0007 的各项修复,包括第 3 部分。
唯一的定义
exists(X, μ) ⟺ eval(D(G), Replace(PrjMap(X), μ)) is non-empty
Replace 即值插入(Values Insertion):当前行 μ 在每个 Bgp/Path/Graph(Var, ·) 位置上,作为单行 VALUES 表连接进 X,而不是作为语法常量拼接进去——它对每一种 RDF 1.2 项类型都是全定义的,包括空节点与引用三元组,因为它经由真实 VALUES 数据所用的同一求值路径到达数据集;并且对于仅能经由表达式到达的变量,它不需要任何特例,因为无论关联是由哪个位置引入的,连接都会到达每一个叶子。PrjMap 即**Project-边界收窄**:μ 在连接进 Project 节点之下之前,先被限制到该节点自身的变量列表——这是表层语言唯一的作用域边界,也是子 SELECT 自身的投影可以合理遮蔽外层变量的原因。
SEP-0007 以 toMultiSet(μ) 表述 Replace——把行转换为连接所需的多重集单元。purrdf 的代数中没有需要这一转换来弥合的模式/查询类型之分:解行本身就是(IS)那个多重集单元,因此 Replace 在结构上直接落在包裹其目标叶子的任何解修饰符之下,无需额外构造或裁定任何东西。
HAVING 位置不在 SEP-0007 所声明的覆盖范围之内——SEP-0007 只为 Bgp/Path/Graph 值插入位置与普通表达式位置规定了 Replace,没有为子 SELECT 的 HAVING 子句作出规定。purrdf 遵循字面的 PrjMap 解读:子 SELECT 的 HAVING 仅过滤该子 SELECT 自身的作用域,与其内部的其他每个表达式完全相同——不会为它自创任何特殊的关联通道。
存在范式(Existential Normal Form)
在 EXISTS 之下,每一行恰好只观察一个比特:内层模式的求值结果是否为空。以下改写律把一个节点替换为可证明在空性上等价、但代价更低的东西,凡在内层顶部出现之处均会应用(绝不在 Join/Filter/Extend/ Graph/Minus 的操作数内部应用,因为它们从子节点读取的不只是空性):
LeftJoin(A, B, c) → A。OPTIONAL无条件地为每个左侧行至少输出一行——一个填充后的左侧行,或每个兼容匹配各一行——且从不移除任何一行,因此当且仅当A为空时,LeftJoin(A, B, c)为空,与B或其连接条件无关。OrderBy(P) → P。 排序是一种置换,绝不是过滤:一旦唯一的问题是空性,排序键根本不会被求值。Distinct(P) → P、Reduced(P) → P。 去重只会移除行,而且只在更早的某一行已携带相同的值时才移除,因此只要P非空,第一行的值总会保留下来。Slice(0, len ≥ 1)(P) → P。 偏移为零、至少容纳一行的LIMIT只从P的多重集末尾丢弃行,因此只要P非空,第零行总在窗口之内。Slice(_, Some(0))(P) → false。 长度为零的LIMIT对每个P、每一行都为空——整个EXISTS折叠为常量false(NOT EXISTS折叠为true),完全不触及数据集。
上述每条定律都是在行集合(SETS)上证明空性等价的,绝不涉及副作用,因此每条定律仅在其所抹去的部分(对 LeftJoin 而言是 B 与连接条件,对 OrderBy 而言是排序键,对长度为零的 Slice 折叠而言是整个内层)无副作用时才会触发——即其中不可能到达任何 SERVICE 调用、属性函数或自定义/heldIn/rdf:List 函数——因此,本会传播到 EXISTS 之外的硬错误或远程副作用仍会传播,而不会仅仅因为写在其内部就消失。
两种策略,一个答案
对于上述唯一的定义,purrdf 恰好携带两种实现:
- 定义本身 —— 经由
Replace的逐行替换,外包一个Slice{0, Some(1)}首个见证即停(这是可靠的,因为「这个多重集有没有第一行」恰恰就是EXISTS所问的问题),并由一个以限制为键的记忆表支撑:记忆键是被限制到内层自身关联变量列上的外层行,因此N个外层行中k个不同的限制,恰好对内层求值k次,绝不是N次。对任何内层模式都始终正确。 - 记忆化探测 —— 对内层不加约束地恰好求值一次,在其与外层模式共享的列上建立索引,然后针对该索引对每一行的
μ做存在性探测。仅当预备阶段的可采纳性证明表明,对该位置可见的每一行,它都与定义等价时,才是正确的。
预备阶段的分析在每次求值中对每个位置决定一次,由哪种策略应答每个 EXISTS/NOT EXISTS。--explain 的逐代数节点计费台账通过三个证据计数器报告该决定:exists-probe-answered(一次记忆化探测求值)、exists-definition-answered(一次逐行定义求值)以及 exists-inner-solutions-consumed(定义路径的内层实际物化出的一行——受首个见证即停约束,每次求值最多为 1)。EXISTS/NOT EXISTS 内层自身的计划节点——一个 MINUS、一个 Bgp、一个嵌套的 EXISTS(无论嵌套多深),主体所含的任何东西——同样各自带有台账行,在两种(EITHER)策略下,都与普通节点一样精确分解,而不是折叠进外围的 FILTER/BIND:记忆化探测每个位置仅一次的那次求值,其归属方式与逐行定义完全相同,只是只计费一次,而不是按每个不同的限制各计费一次。一个合理地显示 fuel=0 rows=0 的节点,是被存在范式从所求值的树中彻底抹去的节点(一个被保持空性的定律证明为透明的 OPTIONAL/ORDER BY/DISTINCT/LIMIT 包装——见上文「存在范式」),因此它从未运行,而不是一笔遗失的计费。
唯一具名的例外:若 EXISTS/NOT EXISTS 内层自身(OWN)经 ENF 规范化后的顶层形态是 Project(一个子 SELECT)或 Union(顶层的 { A } UNION { B },而非嵌套在更深处的那种),则不(NOT)进行归属——其中的每个节点,无论多深,在任一策略下都会以 fuel=0 rows=0 折叠进外围的 FILTER/BIND,与主体本身包含什么无关。Project/Union 由不止一个子节点合成其输出,而不是原始树中任何东西的 1:1 结构克隆;为它们重建同样的原始地址对应关系,需要 LATERAL 值插入机制已在做的那种包装者/被包装者 counts_rows 仲裁——这是刻意不去尝试的,因此对于这一个位置,对应关系干脆不存在,而不是靠猜测给出。这并非倒退:这恰恰是在逐节点归属出现之前,每个 EXISTS/NOT EXISTS 内层原有的行为,如今只局限于这一种形态,而不是整个功能。
性能特征,直白地说:一个不关联的内层,或一个仅由 Bgp/Path/Values/Graph/Join/ Union/OrderBy/Project/Distinct/Reduced 以及只读取内层中确定已绑定列的 Filter/Extend 表达式构建的关联内层,由探测来服务——总共只求值一次,无论有多少外层行经过它的过滤。探测无法服务的形态——MINUS、具有限制作用的 Slice(任何偏移或上限,不仅是越过第一行的那种)、GROUP BY、LATERAL、属性函数调用、SERVICE 调用,或读取了内层并不确定绑定的关联变量的 FILTER/BIND 表达式(例如仅在某个 OPTIONAL 分支下可见的变量)——则经由定义逐行求值,由上述以限制为键的记忆表与首个见证即停来约束代价。
第 3 部分的赋值限制
在 EXISTS/NOT EXISTS 主体内部,无论是 BIND/子 SELECT 的 (expr AS ?v) 投影目标/GROUP BY (expr AS ?v) 分组目标,还是 VALUES 列,都不得重新绑定在被过滤的行上已处于作用域中的变量。NOT EXISTS 与 EXISTS 共享完全相同的语法产生式——并不存在单独的「NOT EXISTS」表述——因此该限制同等适用于二者,也适用于嵌套 EXISTS 自身的主体(相对于紧邻其外的 EXISTS 已处于作用域中的变量)。局限于主体内 MINUS 右操作数中的重新绑定,在任何深度上都豁免,理由与 LATERAL 自身的作用域限制相同(§18.2.1:MINUS-右侧的引入永远不会逃逸出去,因此永远无法可观察地重新绑定该行)。
PREFIX : <https://example.org/>
# 合法:?fresh 不在 FILTER EXISTS 所测试的行的作用域中,因此 BIND
# 为它赋值是一次普通的新绑定,而不是重新绑定。
SELECT ?s WHERE {
  ?s :p ?o .
  FILTER EXISTS { BIND(1 AS ?fresh) }
}
# Illegal — refused with a typed ParseError naming ?o: ?o is already bound by
# the row FILTER EXISTS is testing, and BIND tries to give it a NEW value at
# the EXISTS body's own scope level.
SELECT ?s WHERE {
  ?s :p ?o .
  FILTER EXISTS { BIND(1 AS ?o) }
}
该限制是 SEP-0007 自己的新增内容,在此采纳,是因为正是它使 EXISTS 的替换语义在每个位置上都有据可依——SPARQL 1.1/1.2 自身的 §18.6 正文并不要求这样的规则。
SHA-3 哈希(SEP-0008)
SPARQL 1.1 §17.4.6 提供五个哈希内置函数——MD5、SHA1、SHA256、SHA384、SHA512。purrdf 新增了 SEP-0008 所提议的四个 SHA-3(FIPS 202 Keccak)函数,调用约定完全相同。SEP-0008 是一份提案,不属于 SPARQL 1.1 或 1.2 推荐标准——这四个函数是第一方扩展,且无法移植到其他引擎:
| 调用 | 摘要 | 十六进制字符数 |
|---|---|---|
SHA3-224(string) | SHA3-224 | 56 |
SHA3-256(string) | SHA3-256 | 64 |
SHA3-384(string) | SHA3-384 | 96 |
SHA3-512(string) | SHA3-512 | 128 |
SELECT ?s (SHA3-256(?label) AS ?fingerprint)
WHERE { ?s <http://example.org/label> ?label }
参数契约
每个函数接受一个参数,对其词法形式的 UTF-8 字节求哈希,并以小写十六进制 xsd:string 返回摘要——与 SHA256 的契约相同,因此查询可以把二者互换,而不必改动该行的任何其他内容。
可接受的参数是简单字面量和显式标注为 xsd:string 类型的字面量,这正是 SPARQL 1.1 §17.4.6 对每个哈希内置函数的要求:SHA3-256("abc") 与 SHA3-256("abc"^^xsd:string) 的摘要相同。
其他任何参数都是表达式错误,这是 SPARQL 普通的「该行不产生值」结果,而不是查询失败:
- 未绑定的变量(
SHA3-256(?missing)), - IRI 或空节点,
- 带语言标签的字符串或 RDF 1.2 带方向的字符串(
SHA3-256("abc"@en)), - 非字符串字面量(
SHA3-256(7))。
在 SELECT 投影中,出错的调用会使被投影的变量在该行上未绑定;在 FILTER 下,它使约束为假;对它做 BIND 则不绑定任何东西。当意图是「对这个项看起来的样子求哈希」时,请用 STR(…) 包裹参数——SHA3-256(STR(?anything))——因为 STR 才是把项转为字符串的函数,而这些函数不会隐式地这样做。
连字符是名称的一部分
这些是语言中仅有的名称含 - 的内置函数,因此值得把空白规则明确说明:
| 文本 | 解读 |
|---|---|
SHA3-256(?o) | 内置函数调用——一个记号,含连字符 |
SHA3 - 256 | 解析错误:单独的 SHA3 既不是函数也不是关键字 |
STRLEN(SHA3-256(?o)) - 4 | 减法——- 跟在 ) 之后,而不是跟在单词字符之后 |
词法分析器的 PN_PREFIX 扫描把 - 视为名称字符,因此 SHA3-256 作为单个单词到达解析器。连字符两侧有空白时,它又成为减法运算符;而由于 SHA3 本身不是函数,带空格的形式会显式报错失败,而不是被理解为别的含义。名称与其他每个内置函数一样不区分大小写(sha3-256 是同一个调用)。
SEP-0008 自身的正文用下划线拼写这四个函数(sha3_256),因此 SHA3_256(?o) 被接受为 SHA3-256(?o) 的别名:从提案中复制出的查询可以解析。该别名仅是一种输入拼写——代数中每种摘要长度只有一个函数,因此序列化后的查询总是携带规范的连字符名称,无论键入的是哪种拼写,都保持字节级确定性。
把 SHA-3 查询带到另一个引擎
预计会得到解析错误。SHA3-256 在这里是内置名称,但 SPARQL 1.1/1.2 语法恰好只提供两种命名函数的方式——其自身内置列表中的关键字,或 iri 为 IRIREF 或前缀名的 FunctionCall ::= iri ArgList。在尚未采纳 SEP-0008 的引擎上,SHA3-256 不在内置列表中,而不带冒号的裸单词也不是 iri,因此 SHA3-256(?o) 根本无法解析。带下划线的 SHA3_256(?o) 拼写因同样的原因失败。因此,这种失败是显式且即时的,而不是一个悄无声息地未绑定的列。
可移植的替代是 SPARQL 1.1 §17.4.6 中的某个哈希函数。SHA256 接受同样的单个参数,返回同样的小写十六进制 xsd:string,因此改名就是全部修改——它改变摘要,查询的其他一切均不变。当引擎由调用方掌控且明确需要 Keccak 构造时,选用 SHA-3 名称;当查询文本必须能在任何地方运行时,选用 SHA256。
从其他宿主到达它
无需任何配置:与扩展函数和自定义聚合的扩展点不同,这些是内置函数,因此每个接受查询文本的接口都具备它们——purrdf query、Python 中的 Store.query / MutableDataset.query、WebAssembly 中的 Dataset.query / QueryEngine.select,以及 C ABI 上的 purrdf_query / purrdf_query_json。
复合数据类型(SEP-0009)
SPARQL 1.1 与 1.2 没有可容纳若干其他项的项。purrdf 实现了 SEP-0009 的两种复合数据类型 cdt:List 与 cdt:Map,连同该 SEP 定义的十五个函数、由分组构建复合值的 FOLD 聚合,以及将复合值拆开的 UNFOLD 图模式。SEP-0009 是一份提案,不属于 SPARQL 1.1 或 1.2 推荐标准——本节中的一切都是扩展,使用它们的查询无法原样移植到其他引擎。
命名空间是该 SEP 自己的,仅被识别,绝不自创——下面的每个示例都写在这段序言之下:
PREFIX cdt: <http://w3id.org/awslabs/neptune/SPARQL-CDTs/>
复合值是一个普通的 RDF 字面量,其数据类型为 cdt:List 或 cdt:Map,其词法形式逐一写出其内容。以下是项,而不是查询:
"[1,2,3]"^^cdt:List
"[1,null,<http://example.org/s>]"^^cdt:List
"[[1,2],[3]]"^^cdt:List
"{1:'a', 2:'b'}"^^cdt:Map
"[]"^^cdt:List        "{}"^^cdt:Map
列表元素可以是 IRI、空节点、字面量、null 或嵌套的复合值。映射的键可以是 IRI 或字面量——绝不能是空节点、绝不能是 null、绝不能是嵌套的复合值——并且必须按项两两不同,因此 {1: "a", "1"^^xsd:integer: "b"} 是同一个键写了两次,会被拒绝。映射的值没有这样的限制。复合值词法形式中的每个 IRI 都必须是绝对的:复合值的内容属于它自己,不会依据外围文档恰好声明的任何 base 进行解析。
函数库
该集合是封闭的。没有需要配置的注册表,调用方也无法遮蔽这些名称中的任何一个,因此同一个查询在每个宿主上含义相同,已配置的扩展命名空间也无法截获 CDT 名称。参数个数在解析时强制执行,早于任何求值。
| 调用 | 参数个数 | 结果 |
|---|---|---|
cdt:List(…) | 任意 | 由各参数项构成的 cdt:List |
cdt:Map(…) | 偶数 | 由交替的键/值参数构成的 cdt:Map |
cdt:concat(…) | 任意 | 将各参数列表首尾相接 |
cdt:contains(list, term) | 2 | xsd:boolean —— 列表是否包含相等的项 |
cdt:get(coll, n_or_key) | 2 | 按从 1 开始的位置取一个元素,或按键取一个映射值 |
cdt:head(list) | 1 | 第一个元素 |
cdt:tail(list) | 1 | 除第一个元素之外的全部元素 |
cdt:reverse(list) | 1 | 按相反顺序排列的元素 |
cdt:size(coll) | 1 | xsd:integer 元素数或条目数——唯一一个两种数据类型都接受的函数 |
cdt:subseq(list, start[, len]) | 2–3 | 一段连续的元素,start 从 1 开始 |
cdt:containsKey(map, key) | 2 | xsd:boolean —— 这是否是映射的一个键 |
cdt:keys(map) | 1 | 映射的键,以 cdt:List 形式给出 |
cdt:merge(…) | ≥ 2 | 各参数映射的并集;被不止一个映射持有的键,以携带它的第一个映射为准 |
cdt:put(map, key[, value]) | 2–3 | 设置了一个条目的映射;省略的值或出错的值会存入 null 条目 |
cdt:remove(map, key) | 2 | 去掉该条目的映射;键不存在时映射保持不变 |
把映射交给列表函数(或反之)会抛出错误——这是类型错误,而不是未绑定的列。按照该 SEP,索引始终从 1 开始。
PREFIX cdt: <http://w3id.org/awslabs/neptune/SPARQL-CDTs/>
SELECT ?s ?first
WHERE {
  ?s <http://example.org/tags> ?tags
  FILTER(cdt:size(?tags) > 1)
  BIND(cdt:head(?tags) AS ?first)
}
FOLD:一个分组变成一个项
FOLD 是聚合,因此凡是 SUM 或 GROUP_CONCAT 可以出现的地方它都可以出现——在 SELECT 列表中、在 HAVING 中、与其他聚合并列、在 GROUP BY 之下。
Aggregate ::= … | 'FOLD' '(' 'DISTINCT'? Expression ( ',' Expression )?
                    ( 'ORDER' 'BY' OrderCondition+ )? ')'
一个表达式构建 cdt:List;两个表达式构建 cdt:Map,第一个为键。可选的 ORDER BY 属于聚合本身,跟在最后一个表达式之后,且不加逗号——正是这一扩展点使 FOLD 成为引擎中第一个依赖顺序的聚合,这也是为什么 FOLD 可以携带 ORDER BY,而其他每个聚合都会拒绝它。
可接受的写法,汇总如下:
FOLD(?v)                        FOLD(DISTINCT ?v)
FOLD(?v ORDER BY DESC(?v))      FOLD(DISTINCT ?v ORDER BY ASC(?a) ASC(?b))
FOLD(?k, ?v)                    FOLD(?k, ?v ORDER BY ?ord)
以及一个完整的查询:
PREFIX cdt: <http://w3id.org/awslabs/neptune/SPARQL-CDTs/>
SELECT ?s (FOLD(?tag ORDER BY ?tag) AS ?tags)
WHERE { ?s <http://example.org/tag> ?tag }
GROUP BY ?s
在依赖以下任何一项之前,有四种行为值得了解:
- 空分组折叠为一个已绑定的空复合值——
"[]"^^cdt:List或"{}"^^cdt:Map——绝不会是未绑定的列。对空集的SUM为0,对空集的GROUP_CONCAT为"";FOLD遵循的是这种形态,而不是MIN的形态。 - 元素表达式未绑定或出错的行会贡献一个
null元素,这与其他所有聚合相反,它们都会跳过这样的行。该 SEP 要求列表的元数与分组的元数相符。未绑定或出错的映射键会使整个条目被丢弃,因为没有可以用来归档该值的键。 - 重复的映射键以最后一个绑定为准。
DISTINCT依据的是 RDF 项的同一性,而不是值相等,因此"1"^^xsd:integer与"01"^^xsd:integer作为两个元素保留下来。
FOLD 没有 ; SEPARATOR=——这个标量参数只属于 GROUP_CONCAT——而 FOLD(*) 不合语法。
UNFOLD:一个项变成若干行
UNFOLD 是一个图模式,而不是函数。它是一个独立的 GraphPatternNotTriples 备选项——在结构上与 LATERAL 所处的位置相同——并叠放在迄今已解析的模式之上:
Unfold ::= 'UNFOLD' '(' Expression 'AS' Var ( ',' Var )? ')'
| 操作数 | 第一个变量 | 第二个变量 |
|---|---|---|
cdt:List | 每个元素,按列表顺序,保留重复 | 从 1 开始的 xsd:integer 索引 |
cdt:Map | 每个条目的键 | 该条目的值 |
SELECT ?elem ?i
WHERE {
  ?s <http://example.org/tags> ?tags
  UNFOLD(?tags AS ?elem, ?i)
  FILTER(?i < 4)
}
两个目标变量都遵守 BIND 的 §19.6 作用域规则:已在分组图模式中处于作用域的变量是语法错误,而不是连接;两次指名同一个变量同样会被拒绝。
决定 UNFOLD 外围的 OPTIONAL 是否在做预期之事的两个边界情形:
- 良构但为空的复合值(
"[]"^^cdt:List、cdt:Map())产生零行。该行消失。 - 根本不是复合值的操作数——未绑定、出错、
xsd:integer、普通字符串,或词法形式无法解析的cdt:-类型字面量——会原样放行该行,两个目标变量均未绑定。这逐字遵循 SEP-0009 §12.3,并且刻意不作为无行结果,因此UNFOLD绝不会静默删除一个它仅仅是未能理解的行。
FOLD 与 UNFOLD 可以组合,查询正是借此在不离开查询语言的情况下对列表重新排序:
PREFIX cdt: <http://w3id.org/awslabs/neptune/SPARQL-CDTs/>
SELECT (FOLD(?e ORDER BY ?e) AS ?sorted)
WHERE { BIND("[3,1,2]"^^cdt:List AS ?l) UNFOLD(?l AS ?e) }
排序、MIN 与 MAX
ORDER BY、MIN、MAX 以及 FOLD 自身的 ORDER BY,都按复合字面量所表示的值对其排序,而不是按其词法形式,途径是 SPARQL §15.1 的同一个共享投影。复合值的排位介于普通字面量与 RDF 1.2 三元组项之间:unbound < blank < IRI < literal < composite < triple term。SEP-0009 并未固定这一位置;这是 purrdf 有文档记载的选择。
purrdf 为复合值导出的顺序是语法性的,这并非疏忽。SEP-0009 的值关系是偏序,并在不可比较的操作数上抛出错误,而显而易见的修补方式——按值排序、以语法打破平局——在 SPARQL 自身的类型格上是非传递的("9"^^xsd:double < "P1D"^^xsd:duration < "8"^^xsd:float < "9"^^xsd:double)。Rust 的排序在这样的比较器上可能会 panic,因此在这里,全序是正确性要求,而不是锦上添花。
MEDIAN 与 PERCENTILE 是数值折叠,不感知复合值:复合值不在其定义域内,聚合结果为未绑定。
复合值内部的空节点
写在复合值词法形式内部的 _:b,在每个编解码器上——Turtle、TriG、N-Triples、N-Quads、RDF/XML、TriX、HexTuples、JSON-LD,以及两条 GTS 导入路径——都经由与裸 _:b 记号相同的入口规则绑定。因此,在同一文档中,作为主语写出的 _:b 与写在 cdt:List 内部的 _:b 是同一个节点,而同一标签出现在两个不同文档中则仍是两个节点,这完全符合 RDF 1.1 §4.1 的要求。嵌入复合值中的空节点同样参与规范化与 skolem 化(skolemization)。
出于同样的原因,查询文本拥有自己的空节点作用域,因此在查询中写在复合字面量内部的 _:b 永远不是数据中的 _:b。
限制,以及复合值拒绝什么
复合值的嵌套只受内存限制,另有两个界限是值的不变量——程序化构造函数与解析器以完全相同的方式强制执行它们,并且每一层嵌套都计为一个元素:
| 界限 | 值 |
|---|---|
| 元素总数(所有层级) | 2²⁰ (1 048 576) |
| 词法字节数 | 64 MiB |
在求值时越过任一界限都是硬性查询失败,并指名所越过的界限,绝不会是一个悄无声息地未绑定的答案。
文档中格式错误的复合字面量会使整个文档被拒绝(cdt-literal-malformed),而格式错误的 "abc"^^xsd:integer 则不会。这种不对称是刻意为之,并已完整记录在案:嵌入式空节点扫描器是词法层面的,因此若不透明地接纳一个无法解析的形式,就会让空节点作用域一半已绑定、一半仍为原始形式。在查询文本中,同一个字面量可以解析——在那里,类型是否不良是求值时的问题,作用于它的函数结果为未绑定,与它的比较则会抛出错误。
把复合值查询带到另一个引擎
对于 FOLD 与 UNFOLD,预计会得到解析错误,因为它们是任何未扩展语法都不接纳的关键字;对于函数调用,则会悄无声息地得到不同的答案,因为它们是普通的 iri ArgList 调用,没有 SEP-0009 的引擎会把它们报告为未知函数。从宿主到达其中任何一项都无需配置:与 SHA-3 内置函数一样,复合值是无条件提供的,因此 purrdf query、Python 的 Store.query / MutableDataset.query、WebAssembly 的 Dataset.query / QueryEngine.select,以及 C ABI 的 purrdf_query / purrdf_query_json 都具备它们。
有一处分歧方向相反,这里只作陈述,不作论证。purrdf 的读取器接纳两种已发布的 SEP-0009 词法空间所不包含的元素形式——RDF 1.2 三元组项 <<( s p o )>>,以及带方向的语言标签字面量("x"@en--ltr)——作为列表元素与映射值,因为在同样由数据模型定义的容器内部,拒绝 RDF 1.2 数据模型所定义的项类型,对本工具包而言不是可接受的结果。仅当值根本无法用已发布的语法表达时,才会输出这些形式。**把这样的字面量交给符合规范的 SEP-0009 读取器,它会将其判定为格式错误。**关于这一分歧以及限定其影响范围的扫描,见 docs/CONFORMANCE.md。
四元组模板:CONSTRUCT 到命名图中
SPARQL 1.1 的 CONSTRUCT 模板是一组三元组,结果是一个图。purrdf 还接受四元组模板,从而模板可以指名每条语句所落入的图,单个结果也可以跨越多个命名图。
溯源:purrdf 的扩展,并非 SPARQL 1.2 特性
SPARQL 1.2 并未定义四元组模板。 1.1 与 1.2 的语法均不接纳 CONSTRUCT 模板内部的 GRAPH 块(ConstructTemplate ::= '{' ConstructTriples? '}',而 ConstructTriples 仅含三元组),也都没有定义 CONSTRUCT GRAPH … 简写。下文记录的两种写法都是本引擎随附的第一方扩展。让 CONSTRUCT 产生四元组,是 SPARQL 社区提案流程中一项由来已久的诉求,其他引擎——包括 Jena 与 Stardog——已随附了它的某种形式,但并不存在标准化的写法,因此这里描述的写法是 purrdf 自己的。
声明 VERSION "1.2" 不会去掉该扩展:版本声明选择的是语义,而不是功能白名单。见 VERSION 声明。
把这类查询带到另一个引擎
预计会得到解析错误,而不是不同的答案。没有该扩展的引擎一旦在 CONSTRUCT 模板内部遇到 GRAPH 关键字,就会拒绝它,因为其语法中没有在那里接纳它的产生式——查询在求值之前就会失败,因此不存在静默得到错误图的风险。随附了自己形式的该功能的引擎,可能只接受两种写法中的一种,因为二者都未标准化。
两种可移植的改写:
-
如果结果要写入存储,请使用 SPARQL 1.1 Update 而不是
CONSTRUCT。Update 的模板向来就是四元组模板,因此INSERT { GRAPH … { … } } WHERE { … }是标准的、被普遍实现的,并能提供同样的逐解图定位——包括逐行绑定的图名:PREFIX ex: <http://example.org/> INSERT { GRAPH ?g { ?s ex:friend ?o } } WHERE { GRAPH ?g { ?s ex:knows ?o } } -
如果结果必须以文档形式返回,请针对每个目标图各发出一个普通的、产生三元组的
CONSTRUCT,并在客户端组装数据集。这样每个图都要付出一次往返的代价,且无法表达逐解行计算出的图名,而这正是四元组模板所填补的空白。
停留在三元组形式内的查询在两个方向上都不受影响:没有 GRAPH 槽位的模板在这里就是普通的 SPARQL 1.1 CONSTRUCT,输出逐字节相同,因此只有真正指名了图的模板才无法移植。
模板内部的 GRAPH 块
PREFIX ex: <http://example.org/>
CONSTRUCT { GRAPH ex:derived { ?s ex:friend ?o } }
WHERE { ?s ex:knows ?o }
变量图名
图槽位既接受 IRI,也接受变量,因此语句所落入的图可以逐解行决定:
PREFIX ex: <http://example.org/>
CONSTRUCT { GRAPH ?g { ?s ex:friend ?o } }
WHERE { GRAPH ?g { ?s ex:knows ?o } }
多个图,以及混合的默认图三元组
一个模板可以写入不止一个图,并且可以把限定于图的四元组与落入默认图的未限定三元组混合在一起:
PREFIX ex: <http://example.org/>
CONSTRUCT {
  ?s ex:seen true .
  GRAPH ex:people  { ?s ex:friend ?o }
  GRAPH ex:reverse { ?o ex:friend ?s }
}
WHERE { ?s ex:knows ?o }
整模板简写
CONSTRUCT GRAPH <iri> { … } 把整个模板限定到一个图,而无需在外面包一个 GRAPH 块。它同样适用于简短形式(CONSTRUCT GRAPH <iri> WHERE { … }),并接受变量(CONSTRUCT GRAPH ?g { … })、前缀名或相对于 BASE 的 IRI:
PREFIX ex: <http://example.org/>
CONSTRUCT GRAPH ex:derived { ?s ex:friend ?o }
WHERE { ?s ex:knows ?o }
该简写是默认值,而不是覆盖:它为每个自身未指名图的模板槽位提供图,因此内部的 GRAPH 块仍然优先于它。不带名称的 CONSTRUCT GRAPH { … } 是语法错误,而不是一个被静默取消限定的模板。
跳过语义
SPARQL §16.2 已规定跳过变量未绑定或实例化结果格式错误的模板语句。格式错误意为「不是合法的 RDF 1.2 语句」,逐位置而言:
- 主语是 IRI 或空节点——字面量在那里是非法的,三元组项也是如此(引用三元组是一个值;断言的语句是关于具体化节点的,而不是关于被引用的三元组本身)。二者都可能来自普通数据:对于 RDF 1.2 输入,
CONSTRUCT { ?o ?p ?s } WHERE { ?s ?p ?o }把?o绑定到三元组项,就像绑定到字面量一样轻而易举; - 谓语是 IRI,别无其他;
- 宾语可以是任何项,但当它是三元组项时,该三元组项自身的各分量递归地遵守同样的规则(其主语不得为字面量,其谓语必须是 IRI)。
图槽位遵循同样的规则,这一点值得明确说明:
无法解析的图名会使其语句被跳过。 这不是错误,也_不是_回退到默认图。图槽位最先解析,因此,图名为未绑定变量、或被绑定到任何非 IRI 之物(字面量、空节点、三元组项)的语句,根本不会被实例化——它也不会生成任何空节点标签,因此结果的其余部分与模板中不存在该四元组时完全相同。
跳过是逐语句的,而不是逐行的:对于同一个解,自身图槽位可以解析的同级模板四元组仍会被输出。
哪些输出格式可以承载该结果
命名图需要一种有地方放置图名的语法。九种 RDF 语法中有六种具备这一点:
| 承载命名图 | 不承载 |
|---|---|
| TriG, N-Quads, TriX, HexTuples, JSON-LD, YAML-LD | Turtle, N-Triples, RDF/XML |
单图序列化器会丢弃限定于图的语句——不会把它们折叠进默认图——因此把承载图的结果写入其中之一,会产生一个良构、却恰好静默缺失了查询所要求内容的文档。没有任何宿主会不加提示地放行这种情况。出口为_文档_的三个宿主会直接拒绝,各自指名本会丢弃的图、所要求的格式,以及可承载四元组的替代格式;出口为数据集本身的 C ABI 则改为以计数形式报告损失:
-
CLI ——
purrdf query … --results-format turtle以 2 退出(这是用法层面的拒绝,有别于求值错误),并在 stderr 上打印拒绝信息,指向--results-format trig/nquads/trix/hextuples/jsonld/yamlld。 -
Python —— 承载图的
CONSTRUCT的结果是QueryQuads(其成员是带有有效graph_name的Quad),而不是QueryTriples。QueryQuads.serialize(RdfFormat.TURTLE)会抛出ValueError,并指名RdfFormat.N_QUADS/TRIG/TRIX/HEXTUPLES/JSON_LD/YAML_LD。 -
WebAssembly —— 显式的
serialize("turtle")/queryRaw(…, {format: "turtle"})会抛出异常,给出同样的说明与同样的替代格式。当调用方未(NO)指名格式时,默认格式由turtle拓宽为trig,而不是抛出异常,因为并不存在可被违背的请求,而一个空文档会是错误的答案;不含命名图的结果仍然得到turtle,逐字节相同。 -
C ABI —— 形态不同,且是刻意如此。
purrdf_query返回一个PurrdfDataset句柄,它就是冻结 IR 本身,有地方放置图名,因此图在查询边界上永远不会丢失。序列化该句柄是一次单独的调用,而purrdf_serialize序列化为单图媒体类型时会成功,同时通过out_named_graph_rows_dropped输出参数报告其丢弃的内容——以计数而非异常的形式,因为这是 C 所具备的信号机制。该参数可独立地为空;为它传入 null 的调用方表示不希望被告知,因此只要结果可能承载图,就应读取它——或序列化为可承载四元组的媒体类型。便捷路径
purrdf_query_json两者都不需要:它在其{"graph": "..."}信封内把CONSTRUCT/DESCRIBE结果呈现为 N-Quads,因此图名、基础四元组与 RDF 1.2 陈述层全部得以保留,没有需要报告的损失。该成员是purrdf自己的信封,而不是由调用方选择的 RDF 语法,这正是它像 WebAssembly 未指定格式时的默认值那样拓宽、而不像显式serialize("turtle")那样拒绝的原因。仅含默认图的结果,与该成员过去所存放的 N-Triples 逐字节相同——不含图项的 N-Quads 行就是 N-Triples 行。
仅承载默认图语句的结果在任何地方都不受影响:每一个 SPARQL 1.1 CONSTRUCT 与每一个 DESCRIBE 都与以往完全一样序列化为 Turtle。CLI、Python 与 WebAssembly 在被明确要求使用单图语法时,会整体拒绝混合结果,因为输出默认图那一半会把部分答案报告为完整答案。C ABI 则改为报告丢弃的行数,如上所述。
VERSION 声明
查询或更新的序言可以声明 VERSION "<string>"(SPARQL 1.2 Query 规范 §4.4)。解析仅涉及语法——接受任何字符串,序言重复声明时以最后一个为准——但声明的值不再被丢弃:Query::version() / Update::version() 以带类型的 SparqlVersion 公开它,与既有的 dataset()/base_iri() 访问器并列。
求值是准入边界。VERSION "1.2" 与 VERSION "1.2-basic" 可被识别;其他任何声明的字符串——VERSION "1.1"、拼写错误、本构建之后才出现的未来版本——都会在求值准入时被拒绝,给出指名所声明字符串的带类型错误,且早于任何工作的开销。
VERSION "1.2" 在完整引擎上正常求值。VERSION "1.2-basic" 作为一个更窄的 profile 强制执行:SPARQL 1.2 Query 规范 §4.3.1 的「Version Labels」表把 1.2-basic 定义为完整的 1.2 语法,但「不含三元组项,也不含主语或宾语位置上带有三元组模式的三元组模式」——即 RDF 1.2 的三元组项/具体化功能领域。使用了引用三元组项(<<( s p o )>>)、具体化三元组或注解(<< s p o >>、{| ... |})、VALUES 中不含变量的(ground)三元组项,或某个「Functions on Triple Terms」(TRIPLE、isTRIPLE、SUBJECT、PREDICATE、OBJECT,§17.4.6)的 1.2-basic 查询或更新,会在求值准入时被拒绝,给出指名违规构造的带类型错误——对于更新,不会施加任何变更。未使用上述任何构造的 1.2-basic 请求,其求值与 1.2 请求完全相同。
聚合的确定性:行顺序、DISTINCT 与 GROUP_CONCAT
SPARQL 1.1/1.2 有意对 GROUP BY/聚合求值的若干边角不作完整规定——符合规范的引擎可以在规范允许的范围内选择任何答案。purrdf-sparql-eval 为每一处选定唯一(ONE)一个确定性的答案,并在此记录(同时反映在 purrdf_sparql_eval::modifier 的 crate 文档中),从而「GROUP_CONCAT 返回什么」具有单一、可测试的含义,而不是「引擎碰巧产生的任何顺序」。
行顺序与分组顺序(§18.6.1「Aggregate Algebra」)。 GROUP BY 把内层解序列划分为若干分组;本 crate 按首次出现顺序保持分组(即每个分组的键在内层解序列中首次出现的顺序),并按内层算子顺序保持每个分组自身的行(即未分组的输入产生它们的顺序)。每一个对顺序敏感的折叠——GROUP_CONCAT 的拼接、SAMPLE 的「第一个值胜出」、自定义聚合的 OrderDependent 折叠——都严格按这一顺序对各行折叠。
「内层算子顺序」是可复现(REPRODUCIBLE)的(同一查询针对同一数据集每次都产生相同的顺序),但就其本身而言,对于普通的三元组模式扫描,它并不是查询文本可以依赖的有文档保证的不变量:裸 BGP 的解顺序取决于本存储的内部索引布局(目前按规划器所选索引上的驻留项 id 排序),这是实现细节,而非承诺。查询能够(CAN)依赖的唯一行顺序是显式的 ORDER BY:当聚合的直接输入是(或来自)按 ORDER BY 排序的解序列时——例如为外层聚合提供输入的子查询 { SELECT ?v WHERE { ... } ORDER BY ?key }——「内层算子顺序」恰恰就是该 ORDER BY 的 SPARQL 全序(§15.1),而这是规范本身所固定的。
DISTINCT(聚合调用内部)。 依照 §18.6.1 的 Aggregation 定义,DISTINCT 折叠的是 Dedup(M(Ψ)) 而不是 M(Ψ)——一个保持顺序、无重复的视图,其中各元素首次出现的相对顺序得以保持。本 crate 的去重保留按值相等的元组的第一次(FIRST)出现(按上述行顺序);之后的每次出现都不会到达折叠的 step。
GROUP_CONCAT 的排序
§18.6.1.7 把 GroupConcat 定义为用 sep 连接序列的各元素,但明确对序列自身的顺序不作规定(「字符串的顺序未作规定」)——这恰恰就是上述段落所固定下来的自由度。本 crate 按上述行顺序拼接:分组按首次出现,行按内层算子顺序,DISTINCT 保留第一次出现——产生一个由各词法形式以 sep 连接而成的普通 xsd:string(在没有显式 SEPARATOR 时,依照 §18.6.1.7 默认为 " ")。没有词法形式的项(空节点或三元组项)会把折叠毒化为未绑定,这与 SUM/AVG 对非数值累计值的解读相同。
由于普通 BGP 自身的扫描顺序是实现细节而非有文档的保证(见上文),一个想用精确字符串固定来展示这一确定性解读的 GROUP_CONCAT 测试夹具,不能把证明建立在直接扫描三元组模式之上——那样固定的将是当前索引布局的一个偶然属性,而不是本节所记录的、有规范支撑的排序。本项目自己的一致性测试夹具 crates/sparql-conformance/suite/purrdf-extend/group-concat-order.rq,用一个为外层 GROUP_CONCAT 提供输入的 ORDER BY DESC(?s) 子查询来驱动其行顺序——把固定锚定在 SPARQL 自身针对互不相同的 IRI 的 ORDER BY 全序(§15.1)上,并使用 DESC 而不是 ASC,这样一个静默忽略子查询 ORDER BY(并退回到存储偶然的扫描顺序)的回归,就会产生一个可以察觉的不同的错误字符串,而不是碰巧通过。
扩展求值器:自定义聚合
在 SPARQL 1.1 内置聚合(COUNT/SUM/AVG/MIN/MAX/ SAMPLE/GROUP_CONCAT)之外,Rust 宿主还可以注册额外的 GROUP BY 归约,并在查询文本中以 AGG(<iri>, [DISTINCT] arg, arg, …) 到达它们——这是规范性的位置参数写法(刻意有别于 Jena ARQ 的 AGG <iri>(args))。purrdf_sparql_eval::property_fn 注入的是一个_关系_(图模式位置上的行来源),user_fn 注入的是一个_标量函数_(每次调用一个值),而 agg_fn 注入的是一个折叠:分组中的各行经由调用方提供的累加器归约为一个值,与内置聚合的做法完全相同。
注册的聚合实现两个 trait——CustomAggregate(逐 IRI 的工厂:声明的参数个数、Volatility、AlgebraicClass 以及声明的状态界限)与 AggregateAccumulator(逐调用的折叠:step 每次处理一个已求值的参数元组,combine 按源顺序合并两个部分折叠,finish 得出分组的答案)——并以调用方选定的 IRI 注册到 AggregateRegistry 中:
#![allow(unused)]
fn main() {
use std::sync::Arc;
use purrdf::sparql::{
    AggregateAccumulator, AggregateRegistry, AlgebraicClass, Arity, CustomAggregate, EvalError,
    ExtensionEnv, NativeSparqlEngine, QueryOptions, Volatility,
};
use purrdf::{RdfDatasetBuilder, SparqlRequest, SparqlResult, TermValue};
use purrdf::xsd::datatype::XSD_INTEGER;

/// 经检查的非负整数累计求和(不超过 i64::MAX)——`example.org` 自己的
/// `AGG(<https://example.org/agg#total>, ?x)`。
struct TotalAccumulator {
    sum: i64,
}

impl AggregateAccumulator for TotalAccumulator {
    fn step(&mut self, args: &[TermValue]) -> Result<(), EvalError> {
        let [TermValue::Literal { lexical_form, datatype, .. }] = args else {
            return Err(EvalError::function("total requires one xsd:integer"));
        };
        if datatype != XSD_INTEGER {
            return Err(EvalError::function("total requires one xsd:integer"));
        }
        let n = lexical_form.parse::<i64>()
            .map_err(|_| EvalError::function("total requires a signed-64-bit integer"))?;
        if n < 0 {
            return Err(EvalError::function("total requires a nonnegative integer"));
        }
        self.sum = self.sum.checked_add(n)
            .ok_or_else(|| EvalError::function("total overflow"))?;
        Ok(())
    }

    fn combine(&mut self, other: Box<dyn AggregateAccumulator>) -> Result<(), EvalError> {
        // 通过 `into_any` 恢复 `other` 的真实状态,而不是
        // 从 `finish()` 的词法形式重新推导:`finish()` 是一个
        // 有损的、字符串类型的答案,重新解析它恰恰是本 crate 自己的
        // `agg_fn`/`stat_agg` 合并所避免的模式(见其
        // 「Real merges via `into_any`」文档)。累计求和碰巧能够
        // 无损地经受这一往返,但下面这种恢复类型的合并,
        // 才是在折叠的最终答案本身并非(NOT)充分的可合并状态时
        // 应当照搬的模式。
        let other = other.into_any().downcast::<Self>().map_err(|_| {
            EvalError::function(
                "combine received a partial accumulator of a different concrete type",
            )
        })?;
        self.sum = self.sum.checked_add(other.sum)
            .ok_or_else(|| EvalError::function("total overflow"))?;
        Ok(())
    }

    fn into_any(self: Box<Self>) -> Box<dyn std::any::Any + Send> {
        self // 累计求和本身就是(IS)其充分的合并状态
    }

    fn finish(self: Box<Self>) -> Result<Option<TermValue>, EvalError> {
        Ok(Some(TermValue::typed_literal(
            self.sum.to_string(),
            XSD_INTEGER,
        )))
    }
}

struct TotalAggregate;

impl CustomAggregate for TotalAggregate {
    fn arity(&self) -> Arity {
        Arity::Exact(1)
    }
    fn volatility(&self) -> Volatility {
        Volatility::Stable // 可参与分组内的并行折叠
    }
    fn algebraic_class(&self) -> AlgebraicClass {
        AlgebraicClass::Commutative
    }
    fn state_bound(&self) -> u64 {
        0 // 除累计求和外无其他状态
    }
    fn init(&self, _scalarvals: &[(String, TermValue)]) -> Box<dyn AggregateAccumulator> {
        Box::new(TotalAccumulator { sum: 0 })
    }
}

let mut registry = AggregateRegistry::default();
registry.register(
    "https://example.org/agg#total",
    Arc::new(TotalAggregate),
);
// 读取查询文本所处的环境:`AGG(<iri>, …)` 依据这个
// 注册表被接纳。
let env = ExtensionEnv::over_aggregates(registry).expect("aggregate environment");

let ds = RdfDatasetBuilder::new().freeze().expect("empty dataset");
let engine = NativeSparqlEngine::new();
let result = engine.query_with_options_view(
    &ds,
    SparqlRequest {
        query: "SELECT (AGG(<https://example.org/agg#total>, ?x) AS ?t) WHERE { VALUES ?x { 1 2 3 } }",
        base_iri: None,
        substitutions: &[],
    },
    QueryOptions::EMPTY.with_env(&env),
).expect("custom total");
let SparqlResult::Solutions { rows, .. } = result else {
    panic!("SELECT result");
};
assert_eq!(rows, vec![vec![Some(TermValue::typed_literal("6", XSD_INTEGER))]]);
}
对未注册 IRI 的 AGG(<iri>, …) 调用、参数个数错误的调用,或带有无效 ; NAME=value scalarval 子句的调用(名称无法识别、名称重复、缺少必需的名称,或值的类型错误——见下文),都会在查询预备时被拒绝——早于任何预算单位的开销——并且预备好的计划携带注册表的指纹,因此在一个注册表下获准的计划,永远不会静默地在另一个注册表下运行(完整的信任边界与确定性契约,包括 into_any 在合并折叠最终答案本身无法重建的结构化状态时所起的作用,见 purrdf-sparql-eval 的 agg_fn 模块文档)。
具名标量值参数
除位置参数 args 外,AGG(<iri>, …) 还接受零个或多个尾随的 ; NAME=value 子句——一个具名的、逐聚合的标量参数,把 GROUP_CONCAT 自身的 ; SEPARATOR="…"(SPARQL 中具名标量聚合参数的既有先例)推广到任何自定义聚合:AGG(<{NS}PERCENTILE>, ?x; P=0.95)、AGG(<{NS}TOPK>, ?x; K=3)。NAME 不区分大小写匹配,并以大写形式存储;value 是任何 SPARQL 字面量——包括带符号形式在内的完整数值类型体系(Q=-1、P=+0.5)、布尔字面量(B=true)以及字符串——因此数值型 scalarval 保持其自然的数据类型。与位置参数不同,scalarval 对整个聚合只求值一次,绝不逐行求值——这对百分位秩或「前 k 项」计数这类参数而言是正确的语义,它们必须是整个分组中一个固定的值,而不是查询作者仅仅打算保持不变的逐行表达式。
注册的聚合通过 CustomAggregate::scalarvals 声明其接受哪些名称,返回一个 ScalarvalSpec { name, kind } 切片(kind 为 ScalarvalKind::Numeric 或 ScalarvalKind::String);每个声明的名称都是必需的。CustomAggregate::init 收到的调用点 scalarval 已被解析为 TermValue,并已依据该声明验证过,因此累加器可以按名称读回它们(scalarvals.iter().find(|(k, _)| k == "P")),而无需重新检查类型或是否存在。
AGG(<iri>, …) 的执行与其他任何折叠一样受治理:profile v6 新增了两个计费点——aggregate-invocation(每个分组、每个聚合表达式一次)与 aggregate-accumulation(每检查一个值一次)——由内置聚合与自定义聚合共同使用,因此在给定的分组形态上,注册的聚合所消耗的燃料与内置聚合完全相同。见 docs/SPARQL-GOVERNOR-PROFILE.md。
统计聚合集
purrdf-sparql-eval 随附十个精确的统计聚合——MEDIAN、PERCENTILE、STDDEV、STDDEV_POP、VARIANCE、VAR_POP、MODE、FIRST、LAST、TOPK——它们是位于同一个 agg_fn 扩展点背后的第一方 CustomAggregate 实例,是封闭的(没有供调用方扩展的扩展点),并通过一次调用到达:AggregateRegistry::register_statistical_aggregates:
#![allow(unused)]
fn main() {
use purrdf::sparql::AggregateRegistry;

let mut registry = AggregateRegistry::default();
registry.register_statistical_aggregates("https://example.org/agg#");
assert_eq!(registry.len(), 10);
// 现已可到达:AGG(<https://example.org/agg#MEDIAN>, ?x), …STDDEV…, …TOPK…
}
与 PurRDF 涉及的每个词汇表一样,namespace 是调用方提供的配置,没有捏造的默认值——从不调用该方法的宿主,十个 IRI 一个也不会被注册,这与从不配置 ParserOptions::extension_fn_namespaces 的宿主得不到任何内置标量扩展函数完全一样。
各成员的语义:
- 数值型成员(
STDDEV*/VARIANCE*、MEDIAN、PERCENTILE)遵循内置SUM/AVG折叠所用的同一个integer ⊂ decimal ⊂ float ⊂ double提升体系;非数值输入会把折叠毒化为未绑定,而不是抛出硬错误,与SUM自身的处理规则一致。只有STDDEV/STDDEV_POP最后的平方根会离开精确的 decimal 体系;VARIANCE/VAR_POP从不离开。 STDDEV/VARIANCE是样本统计量(分母为n - 1,少于两个值时为未绑定);STDDEV_POP/VAR_POP是总体统计量(分母为n,一个值时即有定义)——这是 SQL 自身的命名约定。MEDIAN即p = 0.5时的PERCENTILE,在两个最接近的秩之间做线性插值——对于大小为偶数的分组,这恰好是两个中间值的平均值。PERCENTILE接受一个具名 scalarval,AGG(<{NS}PERCENTILE>, ?x; P=0.95):P对整个聚合只解析一次(绝不逐行——见上文「具名标量值参数」);位于[0, 1]之外的P会毒化为未绑定,这与每个数值型成员所用的「毒化,而非中止」规则相同。缺失或非数值的P会在预备时被拒绝。MODE适用于任何项类型,按 RDF 项的同一性计数(而不是值相等——"5"^^xsd:integer与"05"^^xsd:integer算作两个不同的项)。平局时取MIN/ORDER BY所用的同一全序下最小的项。FIRST/LAST适用于任何项类型,按输入行顺序。TOPK接受一个具名 scalarval,AGG(<{NS}TOPK>, ?x; K=3):K必须是正的xsd:integer,对整个聚合只解析一次(K ≤ 0会毒化为未绑定;缺失或非整数的K会在预备时被拒绝)。由于每个 SPARQL 聚合恰好产生一个 RDF 项,TOPK的应答方式与GROUP_CONCAT应答多值问题的方式相同——前k个值,按降序排列,其词法形式以单个固定的空格分隔符连接。
全部十个成员都声明 Volatility::Stable,并通过真实的、恢复了类型的结构化状态(AggregateAccumulator::into_any)合并部分折叠,而不是从最终答案做有损的重新推导——因此单个大分组可以分块并行折叠(见 crate::modifier::eval_custom_aggregate),其结果与顺序折叠逐字节相同。
路径见证:绑定推导过程,而不是端点
核心语法的属性路径回答的是可达性问题。?s ex:p+ ?o 表示存在某个由 ex:p 边构成的序列从 ?s 通往 ?o,答案是端点对;哪些边则无法表达,因此需要解释、加权、过滤或重新连接该路线的查询无处可查。
路径见证属性函数回答的则是推导问题。调用形式如下
?start <caller-iri> ( ?end ?pathId ?len ?step ?node ?edge )
并每跳输出一行。对于一次 k 跳的游走,第 i 行把 ?len = k、?step = i 绑定好,把 ?node 绑定到该跳到达的节点,把 ?edge 绑定到它所经过的语句——一个以断言方向给出的一等 RDF 1.2 三元组项,因此它可以通过普通的基本图模式直接连接回数据集。?step 与 ?len 是 xsd:integer 字面量,正是为了让 ORDER BY ?step 按数值排序,而不是把 "10" 排在 "2" 之前。
没有默认的关系 IRI,也没有默认的遍历范围。PurRDF 不生成任何词汇表 IRI,因此查询在谓语位置写出的名称由调用方提供;而零跳路径没有见证,无界的游走则没有尽头,因此最小与最大跳数以及两个资源守卫每次都要写明,而不是由库自行臆造。u32 能容纳的任何 max_hops 都会被接受:遍历把每一层深度的状态都保存在堆上,而两个资源守卫限定一次游走所做的工作量。
两种关系类型(TYPES),而不是一种带模式开关的类型:PathWitnessRelation 枚举每一条简单前缀游走(最坏情况下为指数级),ShortestPathWitnessRelation 为每个可达对产生一个最短见证(多项式级)。规划器从注册信息中读取基数,因此由二者中的哪一个应答某个 IRI,是注册的属性,而不是规划器无法看到的运行时值的属性。
一个完整示例
在一条三边链 ex:a → ex:b → ex:c → ex:d 上:
purrdf query --data chain.ttl --results-format csv \
  --path-relation 'iri=http://example.org/pf#walk;forward=http://example.org/p;min-hops=1;max-hops=4;max-paths-per-seed=1024;max-expansions=100000;mode=walk' \
  'SELECT ?end ?len ?step ?node
   WHERE { <http://example.org/a> <http://example.org/pf#walk>
           ( ?end ?pathId ?len ?step ?node ?edge ) }
   ORDER BY ?len ?step'
end,len,step,node
http://example.org/b,1,1,http://example.org/b
http://example.org/c,2,1,http://example.org/b
http://example.org/c,2,2,http://example.org/c
http://example.org/d,3,1,http://example.org/b
http://example.org/d,3,2,http://example.org/c
http://example.org/d,3,3,http://example.org/d
GROUP BY ?pathId 正是把各跳的行重新组成游走的方式。该标识符在一次游走的各行中保持不变,在不同游走之间互不相同,因此每个分组就是(IS)一次游走;?start、?end 与 ?len 在分组内保持不变,因此同时按它们分组仍保持相同的分组,并使它们能够被投影出来:
purrdf query --data chain.ttl --results-format csv \
  --path-relation 'iri=http://example.org/pf#walk;forward=http://example.org/p;min-hops=1;max-hops=4;max-paths-per-seed=1024;max-expansions=100000;mode=walk' \
  'SELECT ?end ?len (GROUP_CONCAT(?node; separator="->") AS ?route)
   WHERE { <http://example.org/a> <http://example.org/pf#walk>
           ( ?end ?pathId ?len ?step ?node ?edge ) }
   GROUP BY ?pathId ?end ?len ORDER BY ?len'
end,len,route
http://example.org/b,1,http://example.org/b
http://example.org/c,2,http://example.org/b->http://example.org/c
http://example.org/d,3,http://example.org/b->http://example.org/c->http://example.org/d
把 ?node 换成 ?edge,同样的分组就会重建语句(STATEMENT)序列,而这正是针对游走的聚合应在之处:对经由 ?edge 连接进来的逐跳权重求 SUM、对逐跳置信度求 MIN、用 HAVING 只保留每一跳都带有注解的路线。这些都无法从一个返回端点的关系中得到,而且都不需要列表项。
在 Python 中进行同样的注册:
store.query(
    "SELECT ?end ?len ?step ?node WHERE { <http://example.org/a> "
    "<http://example.org/pf#walk> ( ?end ?pathId ?len ?step ?node ?edge ) } "
    "ORDER BY ?len ?step",
    path_relations={
        "http://example.org/pf#walk": (
            [(purrdf.NamedNode("http://example.org/p"), "forward")],
            1, 4, 1024, 100000, "walk",
        )
    },
)
在蕴涵机制(entailment regime)下,游走读取的是推理闭包
路径关系是步骤所含边的快照,而它必须据以建立快照的数据集,是查询所依据作答的那个数据集。在 --entailment(或 Python 的 query_entailment_governed)下,那就是推理闭包,而不是源图——因此,在步骤谓语下推导出四元组的蕴涵机制,会拓宽游走,与它拓宽写在旁边的 p+ 完全一样。以如下数据为例:
ex:sub rdfs:subPropertyOf ex:p .
ex:a   ex:p ex:b .
ex:b   ex:sub ex:c .
在 rdfs 下,SELECT ?end WHERE { ex:a ex:p+ ?end } 的答案是 ex:b, ex:c,而以 ex:a 为起点注册的游走同样会到达 ex:c。没有该蕴涵机制时,二者都止于 ex:b,因为推导出的 ex:b ex:p ex:c 并不存在,无从游走。
有一种组合会被拒绝,而不是作答:在受限 chase 会生成存在性见证的本体上使用 --entailment owl-direct。这些见证是不属于作用域图的项的空节点,而该蕴涵机制的见证过滤无法到达属性函数的输出——因此在该推理闭包上的游走可能会把其中一个作为绑定交还。拒绝携带代码 reasoning-closure-relation-witness,并指名确实接受这种组合的蕴涵机制。不生成任何见证的 owl-direct 运行——TBox 位于组合方法的 Horn 片段之外,或其 chase 未触发任何存在性规则——不会被拒绝。
Rust 接口把同样的事情明确写出:query_with_entailment 与 query_with_entailment_governed 接受一个 ClosureRelations 参数,它要么是 ClosureRelations::NONE(每个注册的关系都与数据集无关,因此调用方的注册表原样使用),要么是 ClosureRelations::rebuilt_by(&f),其中 f 接收物化后的推理闭包,并返回用于作答的注册表。
从其他宿主到达扩展
SHACL-AF 函数注册表与一般(GENERAL)的自定义聚合注册表是 Rust 闭包扩展点:注册的函数或聚合是任意的宿主 Rust 代码(对聚合而言是 init/step/combine/finish 闭包),因此注册它们是仅限 Rust 宿主的操作。它确实无法以字符串或任何其他 FFI 形态的值跨越 Python、WebAssembly 或 C 边界——本项目不愿为此自创任何回调协议,下述四个宿主接口也都没有公开它。
属性函数注册表在同样的意义上也是闭包扩展点——PropertyFunction 是任意的宿主实现——但其数据形态(DATA-SHAPED)的成员不是,这些成员可以跨越边界。冻结的项表、以 rdf:List 的 rdf:List 形式从存储自身数据集中读出的表,以及路径见证遍历,各自都完全由自有数据描述,因此每一种都可以从 Python 注册(每个 Store / MutableDataset 查询与更新入口上的 relations、relations_from_graph、path_relations),路径关系还可以从 CLI 注册(purrdf query --path-relation、purrdf update --path-relation)。它们都不是回调:引擎在释放 GIL 期间调用的任何东西都无法重新进入解释器,这正是它们能够跨越边界的原因。WebAssembly 与 C-ABI 接口完全不公开属性函数注册。
关系对自身作出的证明,以及唯一能够记录它的通道
关于一次调用,有两项事实只有关系的游标知道,其他任何东西都不知道:由其索引的哪一代作答,以及该索引是否完整。因此,每个 Python 关系声明都接受一个尾随位置 (generation, incompleteness),二者各为字符串或 None,并各自被逐字记录。两者都不声明是默认情况,意味着该关系什么也没说——这是沉默,而不是声称索引完整。
声明自身不完整的关系,会在任何无处存放该声明的入口被拒绝:不受治理的 query 与每一条 update 通道都会抛出 native-sparql-relation-incomplete,且更新不施加任何内容。这一拒绝正是受治理通道存在的原因,而不是它的障碍——一个无人能读取其回执的不完整(被截短)的答案,恰恰是硬失败原则所禁止的。因此,受治理通道会作答,其结果携带:
outcome.relation_witness
# {relation_iri: {"invocations": int,
#                 "generations": [str | None],
#                 "incompleteness": [str]}}
该映射始终存在,且可以为空——未调用任何关系的受治理查询报告 {},这是一项事实,而不是缺失。generations 中的 None 表示一次什么也没证明的调用,它刻意作为集合的成员保留,而不被丢弃:没有它,「每次都声明了一代」与「有时声明、其余时候什么也没说」读起来会完全相同。键与两个列表都按引擎自身的排序顺序输出,因此在同一快照上两次运行的声明(DECLARATIONS)可以逐字节比较。已触发的 governor 仍会报告各关系在触发之前所证明的内容。
invocations 是唯一不具备这一性质的字段:它统计进入宿主代码的次数,这是关于调度的事实,而不是关于索引的事实。在 FILTER EXISTS 之下,并行行循环在工作线程上对每一块驱动行求值,而工作线程的 EXISTS 记忆表从冷状态开始,因此内层模式——以及其中的关系——每一块都会被重新进入一次,而块数取决于运行时的线程数。因此,同一份数据上的同一个查询可能报告不同的计数,而旁边的每一项声明都完全相同,包括在两次仅所给预算不同的运行之间。应把它读作「该关系是否运行过」(0 对比非零),或作为日志行中的粗略量级;绝不要在两份回执之间比较它。
PurRDF 的第一方统计集则不同,恰恰因为它不是(NOT)任意闭包:AggregateRegistry::register_statistical_aggregates 只接受一个命名空间字符串,并在内部连接十个预构建的 Rust 实例,因此它能跨越本 crate 随附的每一个宿主边界,方式与 property_fn_namespaces 完全相同——没有回调,没有逐聚合的封送。每个宿主接口都以名为 aggregate_namespace(在采用 camelCase 拼写的 JavaScript 中为 aggregateNamespace)的关键字参数 / 标志 / 参数传递它,与该接口传递 property_fn_namespaces 或最接近的等价可选字符串配置的方式保持一致:
-
Rust(直接嵌入引擎):
QueryOptions.aggregates,如本页各处所示。 -
Python(
purrdf.Store/purrdf.MutableDataset):query/query_governed/update/update_governed上的aggregate_namespace关键字参数。store.query( "PREFIX ex: <https://ex.example/> " "SELECT (AGG(<https://ex.example/agg#MEDIAN>, ?v) AS ?m) " "WHERE { ?s ex:value ?v }", aggregate_namespace="https://ex.example/agg#", ) -
CLI(
purrdf query/purrdf update):--aggregate-namespace IRI标志。purrdf query --data data.ttl --aggregate-namespace 'https://ex.example/agg#' \ 'SELECT (AGG(<https://ex.example/agg#MEDIAN>, ?v) AS ?m) WHERE { ?s ?p ?v }' -
WebAssembly(
QueryEngine.queryGoverned/updateGoverned):aggregateNamespace选项,与其他受治理调用选项并列。const outcome = engine.queryGoverned(dataset, sparql, { aggregateNamespace: "https://ex.example/agg#", }); -
C ABI(
purrdf_query_governed/purrdf_update_governed):一个可为空的const char *aggregate_namespace参数,与该 ABI 上其他每个可为空字符串所用的可选 C 字符串约定相同。purrdf_query_governed(dataset, query, /* base_iri */ NULL, "https://ex.example/agg#", &governors, /* … */);
在上述每一个接口上,namespace 都保持为调用方提供的配置,没有捏造的默认值:省略它(None / 不传该标志 / undefined / 空指针)会使十个名称中的每一个都成为普通的未注册自定义聚合 IRI,与该参数出现之前完全一样被拒绝。
感知蕴涵的查询通道(query_with_entailment/ query_with_entailment_governed,以及围绕受治理入口的每一个 Python/CLI/WebAssembly/C 包装)与 aggregate_namespace 的组合方式,与原始视图通道完全相同:二者都接受引擎的 QueryOptions,并将其贯穿推理闭包查询的解析与求值,因此 AGG(<{NS}MEDIAN>, …) 在蕴涵得出的推理闭包上的解析方式,与在原始视图上相同。
purrdf query --data ent.ttl --entailment rdfs \
  --aggregate-namespace 'https://ex.example/agg#' \
  'SELECT (AGG(<https://ex.example/agg#MEDIAN>, ?w) AS ?m)
   WHERE { ?x <http://example.org/measure> ?w }'
purrdf.Store.query_entailment_governed(..., aggregate_namespace=NS) 以同样的方式回答同一个查询,WebAssembly 与 C-ABI 的受治理蕴涵入口也接受同一个参数。
在统计集可到达的所有地方,都适用一个结构性限制:SPARQL UPDATE 的语法只在 WHERE 子句中嵌套的 SELECT … GROUP BY 内部接纳聚合(普通的 DELETE/INSERT WHERE 基本图模式自身没有 GROUP BY)——每个宿主的 update 入口都恰好通过这种嵌套子查询形态到达统计集。
带日期的 XPath 正则法则
REGEX 与 REPLACE 运行在兼容正则表达式之上,除非调用方按稳定名称选择一种带日期的原生 XPath 法则:
| 名称 | 法则 |
|---|---|
xpath-2.0-2010-12-14 | XPath and XQuery Functions and Operators 2.0(第二版),2010 年 12 月 14 日 |
xpath-3.1-2017-03-21 | XPath and XQuery Functions and Operators 3.1,2017 年 3 月 21 日 |
两种法则都接受反向引用,而兼容正则表达式拒绝反向引用。只有 3.1 接受 (?:a) 这样的非捕获组和 q 标志。在任一法则下,下面的查询保留前两个字符相同的每个 ?code:
SELECT ?code WHERE {
  ?item <http://example.org/code> ?code
  FILTER(REGEX(?code, "^(.)\\1"))
}
每个宿主都以自己的写法选择法则:
| 宿主 | 写法 |
|---|---|
| Rust | NativeSparqlEngine::with_xpath_regex(profile, limits) 作用于该引擎运行的每个请求,QueryOptions::with_xpath_regex(profile, limits) 则只作用于一个请求,其中 Profile 与 Limits 来自 purrdf_core::xsd_regex::xpath;purrdf_validate::xpath_regex::{parse_profile, sparql_engine, query_options} 按名称选择,并使用生产限制 |
| CLI | query 与 update 上的 --xpath-regex <NAME> |
| Python | query、query_governed、query_entailment_governed、update、update_governed 与 Store.prepare 上,以及 rdflib 层的 Graph.query 与 Graph.update 上的 xpath_regex=;purrdf.XPATH_REGEX_PROFILES 列出这些名称 |
| WebAssembly | 每个求值型 QueryEngine 方法及其异步孪生方法上的 xpathRegex 选项,以及 Dataset.query、queryRawConfigured 与 queryRawWithContext 的尾随参数 xpathRegex |
| C | purrdf_query_xpath_regex、purrdf_query_json_xpath_regex、purrdf_query_governed_xpath_regex、purrdf_query_entailment_governed_xpath_regex 与 purrdf_update_governed_xpath_regex 上的 regex_profile |
名称须精确匹配,不做大小写折叠,也没有不带日期的别名,因此像 xpath-3.1 这样的名称会被拒绝,并附上可接受名称的列表。未作选择时(没有选项、没有标志,或 regex_profile 为 NULL),兼容正则表达式的行为与以往完全一样。预备好的查询在每次运行中都保留其法则,而未设置法则的请求继承引擎的选择。
所选法则未定义的模式或标志是普通的表达式错误,因此 FILTER 会剔除该行,BIND 会使其变量保持未绑定。所选法则还在有限的资源上限下运行,其中包括 64 KiB 的模式源文本。超出任一上限都是运行层面的失败,并携带该资源的 xpath-* 代码,该页面列出了触及每个上限的、经过测量的几类工作。它绝不会成为部分答案或 false 的过滤结果,被拒绝的更新也不会改变任何内容。
蕴涵机制
先用 purrdf-entail 物化数据集,即可在蕴涵机制下回答 SPARQL 查询——Regime::from_iri 把 sparql:entailmentRegime IRI 映射到相应的引擎。
一致性
完整的 W3C SPARQL 1.1 查询 + 更新求值测试套件以及 SPARQL 1.2 测试套件都被原样随库固化,并由 purrdf-sparql-conformance 运行;每一个未通过项都是带类型、记入台账的预期失败。实时矩阵见 一致性与测试 与 docs/CONFORMANCE.md。
SPARQL:结果格式
purrdf-sparql-results 是 SPARQL 技术栈的结果边界:它是把 SparqlResult(SELECT 解、ASK 布尔值或 CONSTRUCT 图)转换为四种 W3C SPARQL 结果格式——JSON(SRJ)、XML、CSV 与 TSV——的规范权威实现,并在格式能够承载时附加一个增补性的、由调用方命名的溯源扩展。JSON 与 XML 文档也可以读回(from_json、from_xml)。
#![allow(unused)]
fn main() {
use purrdf::{RdfDatasetBuilder, TermValue};
use purrdf::sparql::{from_json, serialize, ResultProvenance, SparqlResult, SparqlResultsFormat};

let result = SparqlResult::Solutions {
    variables: vec!["s".to_owned()],
    rows: vec![vec![Some(TermValue::Iri("https://example.org/alice".to_owned()))]],
    aux: RdfDatasetBuilder::new().freeze().expect("empty auxiliary dataset").into(),
};
let outcome = serialize(&result, SparqlResultsFormat::Json, &ResultProvenance::default(), None)
    .expect("SELECT serializes to SRJ");

assert!(!outcome.provenance_dropped);
let decoded = from_json(&outcome.bytes).expect("emitted JSON parses back");
assert_eq!(decoded.variables, ["s"]);
assert_eq!(decoded.rows, [vec![Some(TermValue::Iri("https://example.org/alice".to_owned()))]]);
}各格式的写出器(to_json、to_xml、to_csv、to_tsv)与读取器(from_json、from_json_boolean、from_xml、from_xml_boolean)也会直接导出。
选择格式之前值得了解的行为
- 逐字节确定的输出——同一结果总是序列化为相同的字节,与 PurRDF 其他所有输出路径一样(编解码器与确定性)。
- 支持矩阵是强制执行的,而不是含糊处理的——XML 拒绝 CONSTRUCT 图,CSV/TSV 则同时拒绝 ASK 布尔值与 CONSTRUCT 图,各自报告为带类型的
Error::Format,而不是输出某种形似规范却错误的东西。 - 有损投影会被标记——CSV/TSV 没有扩展点,因此已填充的溯源会在出口关卡处被裁掉,并设置
SerializeOutcome::provenance_dropped;这种丢弃绝不是静默的。当为 JSON/XML 提供了非空的ResultProvenance、却没有可供锚定的ProvenanceNamespace时,也会设置同一标志——见下文。 - RDF 1.2 基础方向使用规范自身的键——带方向字面量的基础方向序列化为
its:dir(JSON:在"value"/"xml:lang"旁增加一个"its:dir"成员;XML:<literal its:dir="…">),这与 SPARQL 1.2 Query Results 规范自身示例所用的拼写相同,也是 RDF/XML 编解码器已经输出的拼写。为了向后兼容,XML/JSON 读取器还接受本 crate 自身写出器过去产生的两种旧拼写(裸的dir属性,以及——仅限 XML——一个带purrdf:dir命名空间的属性),但当同一字面量上存在多于一种拼写时,以its:dir为准,并且写出的永远只有its:dir。
| 格式 | SELECT | ASK | CONSTRUCT | 溯源扩展 |
|---|---|---|---|---|
| JSON (SRJ) | 是 | 是 | 是 | 是,需提供命名空间 |
| XML | 是 | 是 | 拒绝 | 是,需提供命名空间 |
| CSV | 是 | 拒绝 | 拒绝 | 丢弃,并加标记 |
| TSV | 是 | 拒绝 | 拒绝 | 丢弃,并加标记 |
溯源扩展
溯源扩展是增补性的且由调用方命名:标准的 SPARQL 结果使用方可以原样读取 JSON/XML 文档,而能够识别溯源的使用方可以恢复随绑定一同携带的逐结果数据,这些数据锚定在由_调用方_提供的标识符之下——绝不是 PurRDF 生成的标识符(PurRDF 不生成任何自有的词汇表 IRI;参见 AGENTS.md 中的「不是本体」契约)。提供一个 ProvenanceNamespace——一个 prefix(即裸的顶层 JSON 成员键,也是 XML 命名空间前缀)加上 XML 命名空间 iri——作为 serialize 的第四个参数(to_json/to_xml 则作为第三个参数接受它:这两者没有需要选择的 format 参数)。ProvenanceNamespace::new 把 prefix 作为 XML Namespaces 的 NCName 进行验证(除其他情况外,拒绝 :、空白以及保留的 xml/ xmlns 名称),并把 iri 作为绝对 IRI 进行验证,因为 prefix 会被直接拼接进 XML 元素/属性名,无法像文本内容那样进行转义:
#![allow(unused)]
fn main() {
use purrdf::sparql::{from_json_boolean, ProvenanceNamespace, ResultProvenance, SparqlResult, SparqlResultsFormat, serialize};

let result = SparqlResult::Boolean(true);
let namespace = ProvenanceNamespace::new("prov", "https://example.org/provenance#")
    .expect("valid NCName prefix + absolute IRI");
let provenance = ResultProvenance {
    query_hash: Some("example-query".to_owned()),
    ..ResultProvenance::default()
};
let outcome = serialize(&result, SparqlResultsFormat::Json, &provenance, Some(&namespace))
    .expect("ASK with caller-named provenance serializes");
assert!(!outcome.provenance_dropped);
assert!(from_json_boolean(&outcome.bytes).expect("emitted ASK parses back"));
let without_namespace = serialize(&result, SparqlResultsFormat::Json, &provenance, None)
    .expect("ASK without a provenance namespace serializes");
assert!(without_namespace.provenance_dropped);
}
当 namespace: None 时,无论 ResultProvenance 填充了多少内容,JSON/XML 都完全不输出溯源元素/成员——这与 CSV/TSV 一贯采用的「丢弃并标记」契约相同。在格式完全没有扩展点的地方(CSV/TSV),无论 namespace 如何,溯源都会被丢弃并显式告知,遵循切片、映射与溯源中描述的损失纪律。
唯一的项语法权威
该 crate 依赖 purrdf-core、purrdf-lex 和 purrdf-iri,并保持 wasm 洁净。共享的词法读取器和 IRI 验证服务于结果格式;项与 N-Triples 语法来自内核的输出原语以及共享的词法项写出器。因此,结果、编解码器和诊断使用同一个项语法权威实现。
相关内容
- SPARQL:查询——首先要产生
SparqlResult。 - docs.rs/purrdf-sparql-results——完整的 API 参考。
全文检索
它能取代什么,以及止步于何处。 正是这一接口,让一个 RDF 项目可以舍弃它为带排名的文本检索而放在三元组存储旁边的 PostgreSQL tsvector/tsquery:问题变成了在已持有该图的 SPARQL 查询中的一次属性函数调用,在进程内、针对同一数据集执行,且答案在原生环境与 wasm32 上逐字节相同。它是 BM25 排名,而不是 Lucene——Unicode 大小写折叠与词边界切分、显式英语词干提取和带代价的词典分析,没有停用词表或查询方言(短语与邻近查询在 SPARQL 中由词项出现关系组合而成),k1 固定,各字段的长度归一化参数显式声明,索引在内存中、针对冻结数据集构建。
purrdf-text(在总括 crate 中为 purrdf::text)是 PurRDF 的确定性全文检索索引。它从冻结数据集中读取 RDF 1.2 字面量,按 Unicode 标准自身的规则进行分词,并用 BM25 分数回答带排名的检索查询——从 SPARQL 出发,经由求值器的属性函数扩展点,使用调用方提供的 IRI。
它是一个 purrdf-core 之外的兄弟 crate,而不是对内核的改动:为了接纳它,purrdf-core、purrdf-sparql-algebra 以及属性函数扩展点本身都没有任何改动。这正是本章中每个扩展所采取的形态。
两种关系,一个索引
索引在数据集上构建一次,由两个属性函数共享;它们是两个不同的类型,而不是带模式开关的同一个类型:
?doc <caller-iri>  ( "needle" ?score ?rank ?lang ?matched )   # 带排名的检索
?doc <caller-iri2> ( "term"   ?lang  ?position )              # 每次出现一行
- 带排名的检索(
TextSearchRelation)对每个匹配的文档输出一行。?score是携带精确 BM25 值的xsd:decimal,?rank是文档在其语料分区内从 1 开始的位置(默认GraphLanguageprofile 使用(graph, language)分区),?lang是该分区的语言标签,?matched统计该文档包含多少个不同的检索词。 - 词项出现(
TermOccurrenceRelation)对单个词项的每次出现输出一行,并给出其 token 位置?position。
短语与邻近检索通过在 SPARQL 中组合来实现,而不是通过内嵌的查询方言——内嵌语法会再造出一种互不兼容的厂商语言,而这恰恰是载体不应做的:
# "quick" 紧接着 "brown"
SELECT ?doc WHERE {
  ?doc <https://example.org/pf/occurs> ( "quick" ?l ?p1 ) .
  ?doc <https://example.org/pf/occurs> ( "brown" ?l ?p2 ) .
  FILTER(?p2 = ?p1 + 1)
}
FILTER(ABS(?p2 - ?p1) <= 3) 即邻近检索;在带排名的关系上使用 FILTER(?matched = 2) 即合取检索。
从 Rust 接入
索引接受它应读取其字面量的谓词,以及一个图选择器——GraphSelector::Any、Default 或 Named(iri)——PurRDF 对两者都不提供默认值。未指名任何谓词的配置是一个带类型的 TextError::Config,而不是一次猜测。
use std::sync::Arc;
use purrdf::sparql::{ExtensionEnv, NativeSparqlEngine, PropertyFunctionRegistry, QueryOptions};
use purrdf::text::{
    GraphSelector, TermOccurrenceRelation, TextIndex, TextIndexConfig, TextSearchRelation,
};
use purrdf::{SparqlRequest, TermValue};

// 索引哪些字面量:由调用方指名谓词。
let config = TextIndexConfig::new(
    vec![TermValue::iri("https://example.org/note")],
    GraphSelector::Any,
    purrdf::text::Analyzer::empty_lexicon(), // 显式选择字素回退。
)?;
let index = Arc::new(TextIndex::from_dataset(&dataset, &config)?);

// 查询通过哪些 IRI 调用索引:同样由调用方指名。
let mut registry = PropertyFunctionRegistry::new();
registry.register(
    "https://example.org/pf/search".to_owned(),
    Arc::new(TextSearchRelation::new(Arc::clone(&index))),
);
registry.register(
    "https://example.org/pf/occurs".to_owned(),
    Arc::new(TermOccurrenceRelation::new(index)),
);
// 读取查询文本所处的环境:每个已注册的 IRI 都在谓语位置
// 被认领,并依据这个注册表解析。
let env = ExtensionEnv::over_relations(registry)?;

let result = NativeSparqlEngine::new().query_with_options_view(
    &dataset,
    SparqlRequest {
        query: r#"SELECT ?doc ?score ?rank WHERE {
                    ?doc <https://example.org/pf/search> ( "quick brown" ?score ?rank ?lang ?matched )
                  } LIMIT 3"#,
        base_iri: None,
        substitutions: &[],
    },
    QueryOptions::new().with_env(&env),
)?;
已注册的 IRI 在谓词位置上被精确识别,因此无需任何解析器选项即可到达它。若查询指名的某个 IRI 已通过 ParserOptions 声明但未注册,则会以点名该 IRI 的方式硬失败;两者皆非的 IRI 仍是普通的三元组模式。
这是一个 Rust 宿主扩展点。索引及其关系是宿主闭包,因此不会跨越 Python、WebAssembly 或 C 边界——只有数据形态的属性函数(冻结表、以图为后端的表以及路径见证)才会。参见从其他宿主到达扩展。
每个分数都是精确的,且在每个目标上都相同
分数以十进制定点整数表示(i128,十二位小数)。评分和排序不使用浮点运算;crate 根模块声明 #![deny(clippy::float_arithmetic)]。
这是一项正确性要求,而不是偏好。BM25 需要自然对数,而 libm 的 ln 在不同实现之间可能相差一个最后位单位(ulp)——这足以颠倒两个分数几乎相同的文档的顺序,从而使同一数据上的同一查询,在原生构建中按一种顺序返回行,而在同一引擎的 wasm32-unknown-unknown 构建中按另一种顺序返回。这里的对数是一个固定长度、固定迭代次数的整数级数,从不使用收敛测试,因此其结果在每个目标上都是其输入的纯函数。排名——行顺序连同每个分数的十进制词法形式——由原生 Rust 测试按独立预期结果固定。make wasm 单独为 WASM 构建 crate;WASM 执行只覆盖实际目标路径与宿主接口。
k1 = 1.2 固定。RankingProfile::single_field() 选择一个权重为一、b = 0.75 的字段;显式的 RankingProfile 则声明每个字段的 b 与权重。这些参数绑定在不可变 profile 的指纹中。同一个已标识的 profile、索引与查询,在每个目标上都产生相同的排名与分数词法形式。
排序,以及复现它的惯用写法
默认的 GraphLanguage profile 按 (graph, language) 分区计算语料统计,因此分数是相对于某个语料的数值,?rank 是该分区内的位置,绝不是全局位置。行按 (partition key ASC, rank ASC) 顺序输出;在一个分区内,顺序为 (score DESC, document id ASC),而文档 id 是在按 (graph, subject, language) 排序之后分配的,因此平局决胜在各自独立构建的索引之间可复现。GraphFree 则按 (subject, language) 排列文档,并仅按语言分区。要在 GraphLanguage 中取得一个统一排名列表,应绑定 ?lang 并通过选择器限制 ?graph;在 GraphFree 中则只需绑定 ?lang。单分区索引也能给出一个统一排名列表。
在选定的同一分区内,有两个值得了解的推论:
- 裸
LIMIT k即 top-k。 输出顺序_就是_排名顺序,因此求值器的行上限许可适用,关系在输出k行后即停止。ORDER BY DESC(?score) LIMIT k不会被下推——ORDER BY加LIMIT没有 governor(执行调控器)可以许可的、经认证的下界——而且这里的ORDER BY本来就是多余的。 ORDER BY ?rank是可复现的惯用写法。 分数以固定宽度的十进制数交给使用方,因此两行可能报告相同的?score,却带有不同的?rank;所以ORDER BY DESC(?score)可能与精确的内部顺序不一致,而?rank不会。
RDF 1.2 一等支持
RdfDataset::quads() 只返回已断言的三元组表;注解位于单独的侧表中。索引读取这两层,因此仅由 :s :p :o {| :note "..." |} 携带的文本也可被检索,并以具体化节点作为文档主语。只读取已断言层的索引将索引零个注解字面量,并且什么也不报告——该 crate 的测试恰恰防范这一点。
明确的限制
- 文档 id 是内容的函数,但_空节点标签_除外——标签是解析的产物:两个同构但标签不同的数据集会产生不同的索引指纹。
- 索引在内存中,针对冻结数据集构建。
verify_binding检查查询所针对的索引是否基于眼前这个数据集构建,从而堵住一个静默通道:过时的索引输出的文档在连接回数据时得到零行。
评分设计记录——包括定点对数,以及被折入索引指纹的 Unicode 表版本——见 docs/design/purrdf-text-scoring.md。
GeoSPARQL
PurRDF 在进程内,对查询已持有的数据集计算空间谓词、地理度量、缓冲区和显式坐标操作。purrdf-geo 是 Rust 门面:它重新导出 purrdf-geo-kernel 的几何与地理类型,以及原生求值器的标量和属性函数适配器。计算内核不依赖 SPARQL 求值器、GEOS、PROJ 或外部地理运行时。同一内核服务于 Rust、Python、C、WebAssembly 和 CLI。
参考系必须显式指定
标准地理 profile 将无前缀 WKT、OGC CRS84 和 GeoJSON 解释为 WGS84,坐标顺序为经度、纬度。原始十进制坐标保持为精确有理数。经度超出 [-180, 180] 或纬度超出 [-90, 90] 时,在转换前拒绝;有效输入绝不被环绕或钳位。
EPSG:4326 要求显式注册 WGS84 纬度/经度顺序。其他参考系、单位和操作链也必须由调用方注册。指定椭球并不等于指定基准转换;引擎不会猜测分带、高程、历元、控制点或区域转换参数。标准 OGC 术语遵循其已发布含义;应用命名空间和自定义注册仍由调用方提供。
地理配置与请求 规定了带版本的 JSON 记录、参考坐标轴、操作参数、限制、身份规则及各个宿主入口。
原生查询引擎中的标量函数
默认 NativeSparqlEngine 安装不可变的标准 geof: 函数。注册与标准函数冲突的函数,会在执行前产生硬错误。查询通过 QueryOptions::with_geo 选择附加绑定及独立的数值限制:
use purrdf::geo::GeoProfile;
use purrdf::sparql::{NativeSparqlEngine, QueryOptions};
use purrdf::SparqlRequest;

let profile = GeoProfile::standard();
let result = NativeSparqlEngine::new().query_with_options_view(
    &dataset,
    SparqlRequest {
        query: r#"PREFIX geof: <http://www.opengis.net/def/function/geosparql/>
                  PREFIX geo: <http://www.opengis.net/ont/geosparql#>
                  SELECT (geof:metricDistance(
                    "POINT(0 0)"^^geo:wktLiteral,
                    "POINT(1 0)"^^geo:wktLiteral) AS ?metres)
                  WHERE {}"#,
        base_iri: None,
        substitutions: &[],
    },
    QueryOptions::new().with_geo(&profile),
)?;
地理 metricDistance、metricLength、metricPerimeter、metricArea、metricBuffer 及其显式单位版本使用声明的椭球。以米为单位的投影系统保留其平面法则。长度包含多边形边界,并保留声明的混合维度规则;面积扣除孔洞,并对单位换算因子取平方。Z 和 M 得到保留,不会凭空生成高程。
格式错误的参数和几何定义域错误保留 SPARQL 表达式错误行为。精度、工作量、内存、收敛、取消和浮点环境方面的运行故障,即使经过 FILTER 和 BIND 仍是致命错误。受治理的求值保留原有未完成结果和工作证据。直接地理请求 API 保留相同的类型化原因,不会将被拒绝的调用转成空结果。
几何与地理法则
WKT 和 GeoJSON 保留原始坐标线性边,包括明确写出的跨经度长路径。显式最短测地线及方位角/长度弧保留所选分支;仅由端点表示且存在歧义的弧会被拒绝。预备区域表示孔洞、补集和整个表面。度量、拓扑、连续坐标操作的像、缓冲区和覆盖,均使用这些相同的预备曲线与区域。
点距离是最短椭球距离,以米为单位保留六位小数,并按中点取偶规则正确舍入。完整且经过证明的包围区间必须确定唯一舍入结果;仅仅满足近似误差要求并不足以允许返回结果。正算坐标使用声明的角度网格。几何距离、长度、周长、面积和向外缓冲各自携带声明的证书与舍入法则。数值原语统一位于 purrdf-xsd;答案不会由平台 libm 或改变结合次序的归约决定。
显式坐标链涵盖投影、地理/地心转换、命名的 GCJ/BD 方程,以及由调用方提供参数的Helmert、相似、多项式和内存网格模型。有界反算隔离全部可接受根,并拒绝歧义。这些数学法则不声称具有测绘精度,也不声称获得官方提供方认证。
空间关系与网格单元
属性函数适配器将调用方选择的几何谓词投影到可复用的 GeoIndex,并注册所选的Simple Features、Egenhofer 或 RCC8 关系。已断言的关系三元组保留其 RDF 含义;计算关系补充蕴涵的匹配。实际查询选定的地理上下文和原始分配所有者在游标整个生命周期内保持存活。关系族注册为空时会被拒绝。
原生立方球层次在 0–30 层分配带 profile 身份的单元 ID。父子操作、大端键和有序范围共享这一定义。闭圆盘、包围盒和预备区域的覆盖具有保守保证;调用方限制会拒绝无法完整生成的覆盖,而不会截断或静默降低精度。可复用点索引保留原始坐标,并按请求的物理距离或报告距离法则精化候选。h3 v4.0 兼容性是架构文档,不是已实现的网格族。
宿主所有权与验证
GeoSession 和 GeoPointIndex 在所有宿主上提供相同的带版本请求。Python 查询和更新入口接受 geo=。WebAssembly 引擎为可挂起操作保存所选配置的快照。C 提供不透明的创建/调用/释放句柄及接受上下文的查询入口。CLI 的地理请求、查询和更新接受 --geo-profile。
语义拒绝具有完整响应记录。运行拒绝保留原始失败通道,且不会在失败调用下创建未经准入的响应。预备数据不可变且可共享;活动数值上下文仍绑定在线程上。原生存储在创建前取得准入,并保留至实际载荷销毁为止。
冻结的数值、几何和层次运行记录比较已完成的原生与 WebAssembly 答案。公开 GeodTest 收集器按摘要检查完整的 500,000 行源数据;分配器、后端和宿主测试分别检查各自的契约。数学推导和精确性边界记录于 测地线数值方法 和 几何精确性。
嵌入向量最近邻
它取代什么,止步于何处。 正是这一接口,让一个 RDF 项目可以去掉为最近邻搜索而放在三元组存储旁边的 pgvector:?neighbour <space> ( ?seed k ?distance ) 在进程内作答,在工件所声明的度量下给出精确的 top-k,并且在原生构建与 wasm32 上逐字节相同。它是一次精确扫描——对每个候选打分,不剪枝,不使用近似索引——受调用方提供的 KnnGuard 约束,支持三种度量(余弦、负点积、平方欧氏距离),作用于 PURREMB 嵌入(向量嵌入)空间。PurRDF 不计算任何嵌入,也不运行任何 ANN 载荷:向量来自调用方填充的 PURREMB 工件,而 PurRDF 自己写出该载体(内存中用 EmbeddingBuilder,流式用 EmbeddingStreamWriter——仅限 Rust),并以失败即关闭(fail-closed)的方式打开它;产生这些向量的模型属于调用方。
purrdf-core 中的 PURREMB 层(参见确定性嵌入伴随文件与 docs/PURREMB.md)存储可按 RDF 1.2 寻址的向量、一个声明的距离度量,以及把第三方索引载荷绑定到其所基于的精确矩阵的防篡改守卫。它刻意不对任何东西排名——排名是查询操作,而 PURREMB 是工件格式。purrdf-sparql-eval 的 knn 模块正是这一查询操作,经由属性函数扩展点对外提供。
调用形态
PREFIX knn: <https://example.org/space/>
PREFIX d:   <https://example.org/d/>

SELECT ?neighbour ?distance WHERE {
  ?neighbour knn:points ( d:a 3 ?distance )
}
四个展平后的位置——主语一侧一个,宾语一侧三个:
| 位置 | 名称 | 作用 |
|---|---|---|
| 0 | ?neighbour | 输出:其向量被检索到的 RDF 项 |
| 1 | ?query | 输入:以其向量作为搜索种子的项 |
| 2 | k | 输入:要检索多少个近邻 |
| 3 | ?distance | 输出:距离,类型为 xsd:double |
排名搜索模式是 fbbf:种子与 k 是该关系无法枚举的输入,而 ?neighbour 与 ?distance 各自可以是已绑定或自由的。k 接受任何由整数派生的数据类型(xsd:integer、xsd:int、xsd:long、xsd:nonNegativeInteger……);k = 0 是请求零个近邻的有效请求。在该空间中没有向量的种子得到的是空答案,而不是中止——否则,每个让种子遍历部分已嵌入项的查询都会失败终止。第二种模式 bbff 绑定近邻与种子,而让 k 保持自由:它询问空间是否持有该近邻,不对其排名。绑定 k 总是选择排名搜索,即使近邻也已绑定。
PurRDF 不为此生成任何 IRI
谓词属于调用方,它是查询为空间命名的方式:宿主为每个希望可查询的 (artifact, target set, vector space) 三元组构建一个 EmbeddingSpace,并在其自身词汇所用的任意 IRI 之下,为其注册一个 EmbeddingKnnRelation。没有默认 IRI,也没有后备空间。每个空间注册一个关系——而不是用一个关系把空间 IRI 作为参数——正是这一点让规划器能从实际将被搜索的空间读出一个如实的行数上界。
use std::sync::Arc;
use purrdf::sparql::{EmbeddingKnnRelation, EmbeddingSpace, KnnGuard, PropertyFunctionRegistry};

// 守卫是调用方提供的配置,没有默认值:一次调用可扫描的
// 最大空间,以及它可请求的最大 `k`。
let guard = KnnGuard::new(/* max_candidates */ 100_000, /* max_neighbours */ 64)?;

// `bindings` 为每个 PURREMB 行指明其所代表的 RDF 项。没有项的行
// 会在构造时被拒绝,而不是被跳过——在一个被静默缩小的候选集上
// 求 top-k,得到的只是某个子集的 top-k。
let space = EmbeddingSpace::from_artifact(
    &purremb_bytes, target_set_id, vector_space_id, bindings, guard,
)?;

let mut registry = PropertyFunctionRegistry::new();
registry.register(
    "https://example.org/space/points".to_owned(),
    Arc::new(EmbeddingKnnRelation::new(Arc::new(space))),
);
随后,注册表经由一个 ExtensionEnv(ExtensionEnv::over_relations,并用 QueryOptions::with_env 交给查询)到达引擎,与全文检索一页中的做法完全相同。这是一个 Rust 宿主扩展点。
精确搜索,按所声明的度量排序
搜索是精确的:每个候选行都在该空间所属族契约声明的度量(FamilyView::metric())下打分——余弦与平方欧氏距离在真实数据上结果不同,而对两者使用同一个内核的接口会在把二者区分开的测试中失败——返回的 k 个就是真正最近的 k 个。任何地方都不做候选剪枝。正因如此,引擎的行数上限下推在这里才是可靠的——输出顺序_就是_排名顺序,因此对每个 n ≤ k,前 n 行就是最近的 n 个——也正因如此,「排序正确」是本模块经过测试的属性,而不是某个调优参数的属性。
排名顺序为 (distance ASC, row ASC)。行号互不相同,因此该顺序是严格的全序,而平局裁决也有意义:PURREMB 目标集按 TargetId(规范标识的摘要)排序并去重,因此行号升序_就是_规范内容的升序。以相反插入顺序、由相同内容构建出的两个工件,作答逐字节相同,包括序列化后的 JSON。
binary64,按固定顺序
工作区中的全文排名检索接口不使用浮点运算,因为 BM25 需要对数,而 IEEE-754 并不要求 ln 正确舍入。这一理由在此并不适用。k 近邻内核不需要任何超越函数——减法、乘法、加法、除法与平方根都是正确舍入的——因此 binary64 在这里给出_同样的_跨目标保证。docs/PURREMB.md 以规范性条文固定了工件自身的归约(「binary64,就近舍入、平局取偶,按书写顺序,不使用融合乘加」),L2 范数就是其中之一,因此 k 近邻接口使用 purrdf_core 中规范性的范数归约,而不是它的一份副本。定点数会引入一个该格式本身并不具有的量化步骤。
两个残余风险在结构上被消除。每一次点积求和与平方欧氏距离求和都遵循同一条固定的法则 purrdf_core::distance::Exact(binary64-lane16-tree-v1):在所有完整的十六元素分块上使用十六条 binary64 通道,随后是一棵固定的两两归约树,最后按下标升序处理剩余项,且绝不拆分到多个工作线程。它在每个目标、每条分派路径上都是同一顺序,而正是相互独立的通道让它无需允许任何重新排序就能向量化(一个测试对某个向量做归约:按通道树求和得 1,按顺序求和得 0,并固定采用哪一种)。每个乘积在被累加之前都先绑定到一个具名局部变量,因此不会形成融合乘加;若某线程的浮点环境会把次正规数冲刷为零,该线程会以具名错误被拒绝。距离以 xsd:double 输出,其规范词法形式能往返还原精确的比特——舍入后的十进制表示会把两个相邻的 double 打印成同一个值,恰好掩盖本节所讨论的那种分歧。
有一个限制在此明说而不隐藏:余弦自距离不一定恰好为零(dot(v, v) 与 |v|·|v| 是对同一个实数的两次舍入)。不要假定自距离为零;排名遵循算出的距离,并按规范行号裁决平局。
一次搜索的代价
governor(执行调控器)早先的计费点按驱动的调用次数与接受的行数为宿主关系定价。对于生成器,代价并不在这两处:在一百万个向量上扫描并返回五行,本会被定价得像一次六行的表扫描。因此,该关系在每次拉取之后都通过 PfCursor::take_work 报告其内部工作量,而引擎对报告的每一单位工作量消耗一单位燃料——于是搜索的计费随空间大小而变化,而不是随返回的行数,而 KnnGuard 正是让计费与规划器的行数上界都保持如实的东西。
设计记录——四项并不显而易见的决定以及各自是由什么确定的——见 docs/design/purrdf-embedding-knn.md。
SHACL
purrdf-shapes(重新导出为 purrdf::shapes)是 PurRDF 的原生 SHACL 验证器与规则引擎。它实现了 SHACL 1.2:Core、SPARQL 扩展、节点表达式、推理规则以及 SPARQL 1.2 RL 规则语言,外加被这些文档取代的 SHACL-AF 1.0 拼写。它完全运行在 PurRDF 自己的驻留 IR 与原生 SPARQL 引擎之上(不含 PyO3)。
它依据 SHACL 形状图验证 RDF 1.2 数据图,不做任何推理(与 pySHACL inference="none" 一致);若要验证物化后的推理闭包,可与蕴涵组合使用,或声明 sh:entailment sh:RulesEntailment,先运行形状图自身的规则,或将形状图中的某个 sh:RuleSet 作为 sh:entailment 的值,只运行该规则集的规则(包括其所含规则集的规则);若给出多个这样的值,则合并为一个规则集一起运行。其他任何 sh:entailment 值都会被拒绝,这与 SHACL 对不支持该值的处理器的要求一致。把规则集作为 sh:entailment 的值,是 2026-10-16 的 SHACL 1.2 编辑草案首次定义的,因此默认法则和 shacl-ed-2026-10-16 会读取它,而 shacl-wd-2026-09-18 和 shacl-rec-2017-07-20 会拒绝它。
覆盖范围
- SHACL 1.2 Core——SHACL 1.2 词汇表声明的每个约束组件都以原生方式求值:完整的属性路径、限定值形状、列表组件(
sh:minListLength、sh:maxListLength、sh:uniqueMembers、sh:memberShape,带sh:detail结果)、三者均可取列表值的sh:class、sh:datatype与sh:nodeKind(sh:nodeKind还可取sh:TripleTerm)、sh:singleLine、sh:rootClass、sh:someValue、属性对与sh:subsetOf(二者均以路径为值)、sh:uniqueValuesFor、sh:closed sh:ByTypes、sh:reifierShape与sh:reificationRequired,以及按语言标签与基础方向判定的sh:uniqueLang。属性形状的sh:values与sh:defaultValue会计算值节点。目标包括隐式类目标(sh:ShapeClass亦然)、数据图中的sh:shape、sh:targetWhere,以及以节点表达式给出的sh:targetNode。约束三元组的具体化节点可以为这一条约束携带sh:deactivated、sh:severity或sh:message。严重级别包括sh:Debug与sh:Trace,一致性判定遵循请求中的sh:conformanceDisallows集合。每条sh:message都连同其语言标签与方向一起报告。 - 精确的数值范围 ——
sh:minInclusive、sh:maxInclusive、sh:minExclusive、sh:maxExclusive、sh:lessThan与sh:lessThanOrEquals按 SHACL 的定义,用 SPARQL 运算符比较数值。任意大小的xsd:integer或xsd:decimal字面量都精确比较,从不经过 double,所以9007199254740992低于界限9007199254740993。词法形式被其数据类型拒绝的字面量(例如"1.5"^^xsd:integer)无法比较,因而违反约束。参见数值限制。 - SHACL 1.2 SPARQL 扩展——基于 SPARQL 的约束与目标、具有预绑定语义的自定义约束组件、用户定义的
sh:SPARQLFunction调用、sh:SPARQLTargetType、sh:sparqlExpr,以及按该文档规定解析的sh:prefixes(见下文),全部运行在原生 SPARQL 引擎上。在默认法则和shacl-ed-2026-10-16下,基于 SPARQL 的约束的sh:deactivated是一个节点表达式;工作草案和 2017 年推荐标准在那里只允许true或false。传给自定义 SPARQL 函数的空节点,在同样这两种法则下是错误,在工作草案下则是普通参数。 - SHACL 1.2 节点表达式——
shnex:词汇表与较早的 SHACL-AFsh:节点表达式拼写解析为同一种表示,并由同一个求值器执行。每种表达式都保持其求值条款所规定的顺序与重数:有序序列、多重集或集合。sh:if仅当其条件为列表( true )时才取sh:then。shnex-sparql.ttl函数库为原生实现。sh:nodeByExpression与sh:ExpressionConstraintComponent均参与验证。 - SHACL 1.2 推理规则——
sh:TripleRule与sh:SPARQLRule,支持sh:condition、sh:layer、sh:order、sh:runOnce、sh:deactivated、规则集与sh:RulesGraph、SPARQL 规则模板、临时三元组、sh:expectedPredicate与sh:ruleProcessor。各层按升序运行。在每一层中,只运行一次的规则先运行一次,随后迭代规则反复执行,直到某次迭代不再推出任何结果。在一次迭代内,规则按sh:order升序运行,相同次序的规则一起运行,每一组都能看到之前各组的推论,因此交换两条规则的次序可能改变推论。无法解析的sh:condition是加载错误,而不是一条静默地永不触发的规则。 - SPARQL 1.2 RL——该规则语言的文本语法会被解析、检查良构性、分层、处理导入并求值(
purrdf_shapes::srl)。SHACL 规则降为同一种规则集表示,二者都运行在同一个规则引擎purrdf-datalog上。
形状图要么被如实加载,要么被拒绝。未知的术语、类型不符的参数值,或引擎不求值的构造,都会引发点名指出该项的加载错误,绝不会成为一条静默消失的约束。同样的检查也覆盖 SHACL-SPARQL 的节点:基于 SPARQL 的约束、验证器与 sh:SPARQLTarget 只能携带其规范赋予它们的术语,因此约束的 sh:select 旁的 sh:ask,或拼错的 sh:mesage,都会被拒绝,而不是被忽略。
SHACL 词汇表定义、而引擎会点名拒绝的术语有:
- SHACL JavaScript Extensions(
sh:js、sh:JSConstraint等),它们不属于 SHACL 1.2;本引擎没有可对其求值的 JavaScript 引擎。拒绝以ShapesError::ShaclJs给出,并且适用于形状触及 SHACL-JS 之处:形状上的sh:js或 SHACL-JS 类型,作为其目标的sh:JSTarget或某个sh:JSTargetType的实例,其规则中的sh:JSRule,以及从节点表达式或该形状所运行的 SPARQL 中对sh:JSFunction的调用。只声明了无人调用的sh:JSLibrary与sh:JSFunction的库可以加载,这些声明保持闲置。挂接到约束组件上的sh:JSValidator则并非闲置:它既不是基于 ASK 的验证器,也不是基于 SELECT 的验证器,因此作为sh:validator(validator-class)、sh:nodeValidator(nodeValidator-class)或sh:propertyValidator(propertyValidator-class)的值时,它会使形状图成为格式错误的,无论是否有形状使用该组件,加载都会以ShapesError::IllFormed失败; - 出现在形状、节点表达式、基于 SPARQL 的约束、验证器或规则上的
sh:describe与sh:update。SHACL 1.2 词汇表把它们声明为sh:SPARQLDescribeExecutable与sh:SPARQLUpdateExecutable的查询,但没有任何 SHACL 规范执行这两个类,因此在这些位置上,它们否则会被静默忽略。若某个资源仅仅是此类可执行体,且没有任何形状读取它,则它可以加载。
引擎所求值的术语中,有两个需要说明:
- SHACL-SPARQL 结果注解。 基于 SPARQL 的约束上、或基于 SPARQL 的约束组件的验证器上的
sh:resultAnnotation,会把其sh:annotationProperty添加到该查询产生的每一条结果中。其值是解中sh:annotationVarName所指变量的绑定;未给出变量名时,以该属性的本地名作为变量名。该变量未绑定时,使用sh:annotationValue给出的默认值。ASK 验证器的注解读取this、value与组件的参数。这些注解出现在ValidationResult::annotations、报告图、SARIF 属性shaclResultAnnotations、预备产物以及 Python 结果字典中。任何 SPARQL 查询都无法绑定的变量名会在加载时被拒绝;把sh:focusNode之类的 SHACL 报告属性用作注解属性,同样会被拒绝。 sh:minus。 SHACL Advanced Features 1.1 的 minus 表达式[ sh:nodes N ; sh:minus M ],其求值与 SHACL 1.2 的[ shnex:nodes N ; shnex:remove M ]完全相同:给出 N 中不在 M 里的节点,并保持 N 的顺序。其sh:nodes是必需的。
引擎实现的每个 IRI 都由某份 W3C 文档定义;PurRDF 一个也不生成。
W3C SHACL 1.0 data-shapes 套件按已批准的预期通过(129/129,撰写时入台账的缺口为 0);已批准的 W3C SHACL 1.2 套件同样按已批准的预期通过(590/591,唯一的例外是 hasLang-example,它与 SPARQL 1.2 语法的参数个数相矛盾);实时数字见docs/CONFORMANCE.md,复现方法见下文的 SHACL 1.2 一致性。
解析后的形状图还可以编译一次,写出为一个确定性的、经认证的字节工件,这样后续进程可以恢复一个预备好的验证器,而不必重新解析 Turtle——参见预备形状产物。
形状图中的 owl:imports
形状文档可以带有一个 owl:Ontology 头或一个 sh:ShapesGraph 声明,它们通过 owl:imports 导入其他文档,而它用来施加约束的形状可以完全位于这些导入中。PurRDF 会解析这一导入闭包——但绝不获取它。工作区中没有 HTTP 客户端,每个发布 crate 都为 wasm32-unknown-unknown 构建,而且依赖某个 URL 今天提供了什么内容的验证裁决是不可复现的。因此,导入闭包是调用方提供的配置,与 entails 和 shex 完全一样:
purrdf validate --shapes root.ttl \
  --import https://example.org/shapes-a=a.ttl \
  --import https://example.org/shapes-b=b.ttl \
  data.ttl -
该表会被传递地跟随——被导入文档自身的 owl:imports 也从同一张表中解析——遇到环时会终止而不会无限循环,因为 OWL 2 §3.4 把导入闭包定义为传递闭包,并明确允许 A 导入 B、后者再导入 A。每个被导入文档自身的 @prefix 声明随其一同携带,因此写在被导入文件中的 SHACL-AF sh:select 会依据该文件所声明的前缀解析。
形状文档在其自身的 file:// 获取 IRI 下解析,若给出 --shapes-base IRI 则在该 IRI 下解析。这个标志与 shacl pack --base 相同,并与 validate --base 相互独立——后者只设置数据图的基准 IRI。按 Turtle 的规定,形状文档内部的 @base 在该文档内仍然优先。
并非每条 owl:imports 三元组都是导入。OWL 2 从文档的本体头读取其导入(Mapping to RDF Graphs §3.1.2,表 4:x rdf:type owl:Ontology . x owl:imports y)。SHACL 1.2 Core 从形状图自身的 IRI 出发,沿 ^owl:versionIRI?/owl:imports 跟随这些导入,并指名了声明形状图的类:「The sh:ShapesGraph class MAY be used as an rdf:type of the IRI of a graph that typically acts in the role of a shapes graph.」PurRDF 以 OWL 2 作为这条规则的底线,并在其上加入 SHACL 的形状图。因此,只有当 owl:imports 的主语是以下之一时,它才是导入:
- 形状文档自身的 IRI(其
file://获取 IRI、--shapes-base、shacl pack --base或文档内的@base;对于被导入的文档,则是导入它时所用的 IRI); - 文档将其类型声明为
owl:Ontology的节点; - 文档将其类型声明为
sh:ShapesGraph的节点。每个这样的节点都计入;sh:RulesGraph,以及某个被文档声明为rdfs:subClassOf sh:ShapesGraph的类的节点,同样计入; - 以上述之一作为其
owl:versionIRI的节点。
在其他任何节点上,它都是数据:它按原样留在形状图中,也不会去查找任何文档。仅为 sh:DataGraph 的节点就是这样的节点。SHACL 1.2 Core §6.2 写道「owl:imports in the data graph is not enacted」,其注释要求:数据图若意在表示一个导入,则应同时将其类型声明为 owl:Ontology。数据图自身的 owl:imports 从不被读取。purrdf shapes lint 会把每条属于数据的 owl:imports 列在 unanchored-imports 下。蕴涵的导入由同一规则决定。导入锚点与下文隐式 SPARQL 前缀来源共用一个图角色分类器,但采用不同的选择条件:数据图角色提供前缀,却不会使其 owl:imports 成为导入。
SHACL-SPARQL 的前缀路径正是这样的数据。查询在形状图内沿 sh:prefixes/owl:imports*/sh:declare 收集其前缀,而 W3C 测试套件是这样写的:
<http://example.com/ns#> sh:declare [ sh:prefix "ex" ; sh:namespace "http://example.com/ns#"^^xsd:anyURI ] .
ex:TestPrefixes owl:imports <http://example.com/ns#> ;
  sh:declare [ sh:prefix "test" ; sh:namespace "http://test.com/ns#"^^xsd:anyURI ] .
ex:TestPrefixes 既不是文档的 IRI,也不是本体头,也不是形状图,因此那条 owl:imports 是一条前缀边,而不是导入,该测试按原样即可验证。sparql/component/validator-001 同样如此:其 owl:imports <http://datashapes.org/dash> 所在的节点三者皆非。
若某个导入的文档或本体已经加载,则无需提供配对。当它指向一份已读取的文档时即视为已解析:形状文档自身的基准(其 file:// 获取 IRI、--shapes-base 或 shacl pack --base)、文档内的 @base,或某个 --import 文档的 IRI。当图中含有 <X> a owl:Ontology、<X> a sh:ShapesGraph,或含有一个 owl:versionIRI 为 <X> 的本体时,导入同样视为已解析。
上述每条规则都适用于整个导入闭包,因此出现在某个被导入文档中的声明同样算数。合并了 W3C SHACL 1.2 词汇表的形状文档——shnex.ttl 导入 sh:,而与之并列的 shacl.ttl 声明了 sh:——按原样即是完整的。
其他任何没有配对能够解析的 owl:imports 都会被拒绝(退出码 1)。拒绝信息点名每个缺失的 IRI 以及可解析它的 --import IRI=FILE 配对,并对一份导入其自身已发布 IRI、而此处从本地文件读取的文档建议使用 --shapes-base IRI。在缺少被导入文档的情况下进行验证,得出的将是针对一个比所指名者更小的形状图的裁决,因此不存在「警告后继续」的路径。导入闭包从未到达的配对会作为未使用而被拒绝(退出码 2),而不是读入后忽略。
导入闭包还必须每个系列只含一个版本。SHACL 1.2 Core §1.3 规定:当形状图的导入闭包中含有两个图,它们「are different versions of the same series (i.e., they share the same shapes graph IRI but have different owl:versionIRI values), or one contains an owl:incompatibleWith annotation whose value is equal to either the shapes graph IRI or the owl:versionIRI of the other」时,该形状图是格式错误的;§6.1 则写道导入闭包「SHOULD NOT」含有它们。PurRDF 将其读作 MUST NOT。这样的导入闭包会在每个宿主上以类型化导入错误被拒绝,kind 为 incompatible-import-versions,并点名这两个图。蕴涵拒绝同样的导入闭包(OWL 2 §3.4 给出了同样的两个条件)。
数据图指名其形状图
SHACL 1.2 Core §6.4 允许由数据图一方建议形状图:
<http://example.com/myDataGraph> a sh:DataGraph ;
  sh:shapesGraph ex:graph-shapes1 ;
  sh:shapesGraph ex:graph-shapes2 .
「Every value of sh:shapesGraph is an IRI representing a graph that SHOULD be included into the shapes graph used to validate the data graph」,PurRDF 将这里的 SHOULD 读作 MUST。当一条 sh:shapesGraph 三元组的主语是数据图自身的 IRI(在命令行上为 --base,或数据文件的 file:// 获取 IRI),或是一个 sh:DataGraph 节点时,它就是这样的链接(交给绑定的 N-Triples 文本没有 IRI,因此在那里由类型充当锚点)。每个被链接的图都通过与 owl:imports 相同的导入表解析:一个表项、形状图已声明的图,或 owl:versionIRI 即为该链接的本体——「the same strategy of resolving a shapes graph IRI from a version IRI … applies here」——被链接图自身的 owl:imports 也会被跟随。被链接的图并入所提供的形状图;若形状文档为空,它们就构成整个形状图。只被某个链接指名的表项算作已使用,而不是未到达。
没有任何内容能够解析的链接会以 unresolved-shapes-graph-link 被拒绝,并点名该 IRI(在命令行上还会点名能解析它的 --import IRI=FILE 配对)。不是 IRI 的链接值为 invalid-shapes-graph-link。任何其他节点上的 sh:shapesGraph 都是数据,与其他三元组无异。数据图自身的 owl:imports 仍不执行(§6.2):链接是为形状图指名一个图,其中没有任何东西会把数据图的导入变成指令。
在数据图尚未可知之前就已预备好的形状图——一个针对多个图进行验证的已解析 Shapes、一个 PreparedShapes、一个预备好的产物——无法再纳入新的图。用它进行验证时,会检查每个链接是否都是它已持有的图:它的基准、其导入闭包或链接所并入的某份文档(产物会记录这些 IRI,因此恢复之后同样持有它们),或它所声明的某个形状图、本体或版本 IRI。其他任何链接都会以 unheld-shapes-graph-link 被拒绝,而不是针对一个比数据图所指名者更小的形状图进行验证。在增量变更路径上,添加或撤回链接的变更会改变形状图本身,因此该次运行会验证整个变更后的图,其范围(scope)会说明原因。
每个宿主上的同一规则
命令行是一条位于引擎内部的规则的调用方之一。形状图成为验证器的每一种途径——解析它、用它验证、运行它的规则、对它的某个节点表达式求值、对它执行 lint、把它打包成产物——都经由同一个辅助函数 purrdf_shapes::imports::resolve_shapes_imports 解析导入闭包,该函数建立在蕴涵同样应用的 purrdf_core::imports 规则之上。因此,同一个形状图在每个宿主上得到同一裁决,而每个宿主以各自的写法接受导入表:
| 宿主 | 导入表 | 拒绝 |
|---|---|---|
| Rust | 传给 parse_shapes_with_config、from_dataset_with_base、validate_graphs_with_options、lint::lint 或 FreeExpression 的 ShapesImports(from_turtle、insert、declare_loaded、link_data_graph);purrdf-validate 边界接受 (IRI, Turtle) 配对 | ShapesError::Imports(ShapesImportError::Unresolved | Unreached | InvalidEntry | UnresolvedLink | UnheldLink | InvalidLink | IncompatibleVersions) |
| CLI | --import IRI=FILE,可重复 | 未解析的导入为退出码 1;没有任何导入指向的配对或格式错误的配对为退出码 2 |
| Python | validate、entail、apply_rules、eval_node_expr、lint_shapes、pack_product 与 Shapes(...) 上的 imports=[(iri, turtle), ...] | purrdf.shapes.ShapesImportError(一个 ValueError),带有 .kind 与 .iris |
| WebAssembly | 每个接受形状图的 shacl* 函数末尾的 importIris、importDocuments 数组 | ShaclImportError,带有 kind、iris 与 message |
| C ABI | 位于输出参数之前的 import_iris、import_documents、import_count | PURRDF_STATUS_SHAPES_IMPORT_ERROR,通过 purrdf_shapes_import_error_kind、_iri_count 与 _iri 读取 |
每个被导入的文档都是 Turtle,以其本体 IRI 作为基准进行语法解析。kind 为 unresolved-import、unreached-import(既没有任何导入、也没有任何数据图链接指名的表项——在每个宿主上都会被拒绝,因为其中的形状会被读入却永不应用)或 invalid-import(不是绝对 IRI 的键、被指名两次的键,或语法解析失败的文档)。版本冲突使用 incompatible-import-versions;上文三种 *-shapes-graph-link kind 属于数据图的链接。应依据 kind 分支,而不是依据消息文本。
import purrdf

report = purrdf.shapes.validate(
    shapes_ttl, data_nt, imports=[("https://example.org/lib", lib_ttl)]
)
lint 认证整个导入闭包:被导入文档中的形状会像导入方文档中的形状一样被加载,并依据 shacl-shacl.ttl 检查;其导入文档并未备齐的形状图会被拒绝,而不是被报告为干净。
SPARQL 1.2 RL 规则集中的 IMPORTS
SPARQL 1.2 RL 规则集可以用 IMPORTS 导入其他规则集。PurRDF 不会获取其中任何一个。规则工具从它为形状图所接受的同一张导入表中取得被导入的规则集,只是以规则集文本代替 Turtle:purrdf rules --srl 上的 --import IRI=FILE,Python 的 apply_rules(srl=...) 上的 imports=[(iri, text), ...],shaclApplyRules 上的 importIris / importDocuments,以及 purrdf_shacl_apply_rules 上的 import_iris / import_documents / import_count。每个宿主都经由 RuleSetDocument::resolve_import_table 解析该导入表。导入会被传递地跟随,每个 IRI 只读取一次。被导入的规则集以其 IRI 作为基准 IRI 进行解析,其规则在导入方的规则之后运行。
对于没有任何表项提供的导入,每个宿主都以同一条点名该 IRI 的消息拒绝。导入闭包从未提及的表项同样会被拒绝,因为那个规则集会被读取却从不被使用。对第一种情况,命令行以退出码 1 退出;对第二种情况,以退出码 2 退出。
import purrdf

inferred = purrdf.shapes.apply_rules(
    data_nt, srl=rules_srl, imports=[("https://example.org/more", more_srl)]
)["inferred"]
SHACL-SPARQL 查询中的前缀
形状图中的 SPARQL 查询(sh:select、sh:ask、sh:construct、sh:sparqlExpr、验证器、目标或函数体)在编译前会获得一个 PREFIX 头。该头遵循 SHACL 1.2 SPARQL 扩展中的「Prefix Declarations for SPARQL Queries」:
- 带有
sh:prefixes的查询使用所选法则的路径上的前缀声明,该路径从查询节点以及携带它的形状或组件读取。默认法则和shacl-ed-2026-10-16读取编辑草案的路径sh:prefixes/(^owl:versionIRI)?/(owl:imports/(^owl:versionIRI)?)*/sh:declare。shacl-wd-2026-09-18读取工作草案的路径sh:prefixes/(^owl:versionIRI?/owl:imports)*/sh:declare,它不读取版本 IRI 所指向的图上的声明。shacl-rec-2017-07-20读取sh:prefixes/owl:imports*/sh:declare,没有owl:versionIRI步骤。 - 不带
sh:prefixes的查询使用形状图中owl:Ontology、sh:DataGraph、sh:ShapesGraph或sh:RulesGraph的每个 SHACL 实例的每个sh:declare。这些类的子类同样计入。前缀收集与导入解析共用一个图角色分类器;仅具有sh:DataGraph角色的节点提供隐式前缀,但不是导入锚点。 - 在查询所能到达的声明中,同一前缀对应两个不同的命名空间会使形状图不良构。加载会失败,错误信息点名该前缀与两个命名空间。同一前缀以相同命名空间声明两次则没有问题。没有任何查询到达的声明不会被检查。
- 查询所到达的格式错误的声明同样会使加载失败。一条声明需要恰好一个
xsd:string类型的sh:prefix与恰好一个sh:namespace。
形状文档自身的 @prefix / PREFIX 指令是后备来源。它们只补充上述声明未绑定的前缀,绝不替换声明已绑定的前缀。它们取自 Turtle 解析器对文档的自身记录,因此查询字符串字面量中的 PREFIX 行绝不会被误认为指令。若文档把某个前缀声明了两次,后备来源采用最后一次声明。查询自身文本中的 PREFIX 只作用于该查询。
作为命名图的形状图:$shapesGraph
SHACL 1.0 在每个 SHACL-SPARQL 查询中把 $shapesGraph 预绑定到形状图的 IRI,因此查询可以用 GRAPH $shapesGraph { … } 读取形状图。SHACL 1.2 移除了这一预绑定,在那里 $shapesGraph 是一个普通变量。PurRDF 把 SHACL 1.0 的行为保留为调用方的选择。指名形状图的 IRI,$shapesGraph 就会预绑定到它,形状图也以该名称公开。不指名,$shapesGraph 就保持为普通的未绑定变量。相对 IRI 相对于形状文档的基准解析,因此它所指名的,就是文档中 sh:shapesGraph <that reference> 所指名的对象。作用域内没有基准时,相对 IRI 不指名任何图,会被拒绝(iri-relative-no-base)。
每个宿主都接受该 IRI:
| 宿主 | 写法 |
|---|---|
| CLI | validate、shapes lint、shacl pack 与 rules 上的 --shapes-graph IRI |
| Python | validate、Shapes(...)、pack_product、lint_shapes、apply_rules 与 entail 上的 shapes_graph= |
| WebAssembly | shaclValidateToSarif、shaclValidateChangesToSarif、shaclPackProduct、shaclLintShapes、shaclApplyRules 与 shaclEntail 末尾的 shapesGraph 参数 |
| C | purrdf_shacl_validate_to_sarif、purrdf_shacl_validate_changes_to_sarif、purrdf_shapes_product_encode、purrdf_shacl_lint_shapes、purrdf_shacl_apply_rules 与 purrdf_shacl_entail_to_ntriples 上紧随 shapes_base_iri 之后的 shapes_graph_iri |
| Rust | engine::parse_shapes_with_graph、engine::validate_graphs_with_shapes_graph、engine::entail_graphs_with_shapes_graph、RulesRequest::shapes_graph,以及 purrdf-validate 的 *_with_shapes_graph 入口点 |
在该 IRI 下解析的 Shapes 会把它带入每一次验证、每一个 PreparedShapes 绑定以及每一个预备好的产物,产物的身份会绑定它。SHACL-AF 的 SPARQL 规则在同一形状图上下文中运行:若某次规则运行指名了 IRI,sh:SPARQLRule 的 $shapesGraph 就预绑定到该 IRI;若未指名,$shapesGraph 就是一个普通变量。SPARQL 1.2 RL 规则集没有形状图,因此与它一同指名的 IRI 会被拒绝,而不是被忽略。W3C SHACL 1.0 测试 sparql/pre-binding/shapesGraph-001 展示了其中的差别。指名 IRI 时,它报告那一条经批准的结果。不指名时,$shapesGraph 未绑定,查询什么也选不出,数据图符合约束。
保存在形状图中的类层次:subClassOfInShapesGraph
SHACL 类型——一个节点是否为某个类的 SHACL 实例,sh:targetClass、隐式类目标、sh:class、sh:rootClass 与 shnex:instancesOf 问的都是这个问题——从数据图的 rdf:type 与 rdfs:subClassOf 三元组中读取。类层次却往往与形状放在一起,因此 SHACL 1.2 Core §6.3 写道「SHACL processors SHOULD offer a parameter subClassOfInShapesGraph that, if set to true, should alter the definition of SHACL Type so that the rdfs:subClassOf triples are queried from the shapes graph in addition to the data graph.」PurRDF 在每个宿主上都提供该参数。它默认关闭,这也是规范的默认值。
开启后,形状图的 rdfs:subClassOf 三元组(其整个导入闭包中的)会在每一处判定 SHACL 类型的地方与数据图的三元组合并,且仅限于这些地方。它们不会变成数据图三元组,因此路径、sh:targetSubjectsOf rdfs:subClassOf 或 SPARQL 模式仍然只读取数据图。rdf:type 三元组始终从数据图读取。
| 宿主 | 写法 |
|---|---|
| CLI | validate 上的 --subclass-of-in-shapes-graph(文档与产物两种路径) |
| Python | validate 与 Shapes(...) 上的 subclass_of_in_shapes_graph=True |
| WebAssembly | shaclValidateToSarif 末尾的 subClassOfInShapesGraph 参数 |
| C | purrdf_shacl_validate_to_sarif 上紧随导入表之后的 bool subclass_of_in_shapes_graph |
| Rust | ValidationOptions::with_subclass_of_in_shapes_graph |
内置声明与 W3C 词汇表
SHACL 1.2 词汇表(shacl.ttl、shnex.ttl 与 shnex-sparql.ttl)声明了每个内置约束组件与节点表达式函数,例如 sh:SPARQLExprExpression a sh:NamedParameterExpressionFunction。这些声明都没有函数体或验证器,因为实现由引擎提供。形状图可以合并这些词汇表,加载时会把每条声明与引擎的「已实现项」表进行解析:
- 对内置项的裸声明绑定到原生实现,不向自定义函数索引或组件注册表添加任何内容;
- 若内置项被再次声明并带有函数体,即为重复定义;为内置组件另行给出其自身的
sh:ask或sh:select同样如此;在错误的类下声明或带有相矛盾签名的内置项即为不匹配;以上所有情形都会使加载失败; - 为内置组件声明的验证器,是被原生实现取代的备选实现。SHACL 1.2 SPARQL Extensions 从组件的验证器中选取「one of the values」,因此每个验证器都是同一组件的一种实现,而实际运行的是引擎自身的实现。DASH 等词汇表为 SHACL Core 组件声明了这类验证器。SPARQL 备选实现必须是与其挂接方式相符的良构 SPARQL 验证器:
sh:propertyValidator下的 ASK 验证器(propertyValidator-class)、任何挂接方式下的 SHACL-JSsh:JSValidator(validator-class、nodeValidator-class、propertyValidator-class),或无法解析的查询(ask-sparql),都会使加载失败。它从不执行,因此其查询可以调用引擎所没有的函数,其带预绑定变量的查询中的MINUS也不会使加载失败:purrdf shapes lint会把它列在unexecuted下; - 内置项声明上的任何其他
sh:语句都会使加载失败,但sh:message、sh:labelTemplate以及不参与验证的特征(sh:name、sh:description等)除外:例如,sh:MinCountConstraintComponent上的sh:severity会要求原生实现做一件它并不做的事; - 引擎未实现的函数无论位于哪个命名空间都仍需函数体:没有函数体的
ex:f会使加载失败,没有函数体的sh:NotABuiltin同样如此; - 若自定义函数的键参数与某个内置项的键参数相同,加载失败,因为所有节点表达式函数的键参数必须互不相交(任意两个函数都不得共用同一个键参数)。
因此,把 W3C 词汇表合并进形状图是一个空操作。一项测试在三个语料(第一方语料、W3C SHACL 1.0 套件以及 SHACL 1.2 的 sht:Validate 条目)中的每个形状图上验证这一点:无论是否合并,验证报告都逐字节相同。purrdf_shapes::spec 公开词汇表声明了什么、引擎实现了什么,一项测试把两者之差固定为零。purrdf shapes lint 按每个函数调用点报告该调用绑定到了原生实现、自定义函数体、SPARQL 注册项还是宿主扩展,并把为内置组件声明的每个验证器列为 superseded-by-native。这些行从不算作问题。
违反语法规则的 SHACL-SPARQL 或 SHACL-AF 声明,无论是否有形状触及它,都会使加载失败。SHACL 1.2 Core 写道「A SHACL processor SHOULD produce a failure in this case」,并没有把这一点限于形状所使用的内容。这些规则出自 SHACL 1.2 SPARQL Extensions 与 SHACL Advanced Features,拒绝会按 id 点名每一条规则。sh:nodeValidator 或 sh:propertyValidator 的值必须是 SELECT 验证器,sh:validator 的值必须是 ASK 验证器(nodeValidator-class、propertyValidator-class、validator-class)。组件参数不得命名为 this、path、PATH 或 value(parameter-name-not-in)。sh:SPARQLFunction 的参数既不得使用这些名称,也不得命名为 shapesGraph 或 currentShape。sh:SPARQLFunction 需要恰好一个 sh:ask 或 sh:select(SPARQLFunction-query)。sh:select 主体返回其唯一结果变量的绑定,SHACL Advanced Features 写道「such SELECT queries should only return at most one solution」;PurRDF 将其读作必须,因此若某次调用的主体返回了第二个解,验证会失败,而不是以恰好排在最前的那一行作答。拒绝以 ShapesError::IllFormed 给出,并列出图中的每一处违规,因此导入了带有格式错误声明的库(DASH 就有这类声明)的形状图会加载失败,并点名其中的全部违规。
预绑定违规在查询运行之处判定。SHACL 1.2 SPARQL Extensions 要求:一个「executed with pre-bound variables」的查询若含有 MINUS、提及预绑定变量的 VALUES,或针对预绑定变量的 AS ?var,则必须报告失败。sh:sparql 约束、组件验证器、sh:SPARQLTarget 的 sh:ask 以及 SPARQL 规则拒绝所有 VALUES,无论是否预绑定,因为随库固化的 W3C 用例 unsupported-sparql-002 要求拒绝 VALUES ?any { true };节点表达式、sh:SPARQLFunction 函数体和 sh:SPARQLTargetType 查询只拒绝提及预绑定名称的 VALUES。因此,当形状的 sh:sparql 约束违反其中一条,当自定义组件的某次使用选中了这样的验证器,当某个节点表达式或某个形状触及的查询调用了这样的 sh:SPARQLFunction,当某个形状实例化了这样的 sh:SPARQLTargetType,或当某个形状触及这样的 sh:select 节点表达式时,加载会以 ShapesError::Prebinding 失败。函数或目标类型的参数就是其可能预绑定的变量,可选参数也包括在内,因为提供它的调用会绑定它。节点表达式的预绑定变量是 $this 以及其上下文绑定的每个名称:sh:expression 中的 $value、自定义函数体中的函数参数,以及自由求值的作用域名称。每一个都与 $this 遵循同一规则;违反该规则的节点表达式查询会在某个形状触及该表达式时使加载失败。这比引擎自身的通道更严格:预备执行或请求的替换接受针对预绑定名称的 VALUES 和 MINUS(参见预绑定变量)。分组约束则更窄:在自定义函数体中,它只把每次调用都会绑定的参数(即必需参数)视为常量,因为调用可以省略可选参数。引擎自带组件的验证器从不运行;没有任何使用选中的验证器、没有任何调用的函数,以及没有任何形状实例化的目标类型,同样不会运行。它们可以加载,purrdf shapes lint 会把每一个列为一个问题。
同一附录写道「SPARQL queries SHOULD not contain a federated query (SERVICE)」,以及「Implementations that do not permit SERVICE MUST report a failure」。PurRDF 在任何 SHACL-SPARQL 查询中都不允许 SERVICE,包括 sh:SPARQLTarget 以及不带参数、因而什么也不预绑定的函数。一个取决于远程端点如何应答的裁决,就不再是关于数据图的裁决,而 PurRDF 不获取任何内容。这样的查询会在其运行之处以 ShapesError::Prebinding 使加载失败;在没有任何东西运行它的地方,则由 lint 列出。字符串字面量中的这个词不是 SERVICE。
若某个形状的 sh:target 是 PurRDF 无法计算的自定义目标,则会以 ShapesError::UnsupportedTarget 拒绝,并点名该形状与该目标。PurRDF 能计算 sh:SPARQLTarget,以及已声明的 sh:SPARQLTargetType 的实例。SHACL Advanced Features 写道,引擎若「cannot handle a given custom target SHOULD at least report a warning」。在一份关于无人计算过的焦点节点的报告旁附上一条警告,它仍然是那份报告,因此 PurRDF 选择拒绝,这更为严格。SHACL-JS 目标以 ShapesError::ShaclJs 被拒绝。
sh:SPARQLTarget 还可以携带一个 sh:ask。SHACL Advanced Features §3.1 写道「SPARQL-based targets have at most one value for the property sh:ask」,它面向无法改写为等价 ASK 的 SELECT:「A SHACL engine can then determine whether a given shape applies to a given node by executing the ASK query with the variable this pre-bound to the node.」凡是检查给定节点、而不枚举目标的地方,PurRDF 都正是这样做的:PreparedValidator::validate_focus_nodes 及其直接以内部 id 运作的对应版本。(对带有 SPARQL 目标的形状图进行变更路径验证时,其影响范围没有上界,因此它会验证整个图。)候选节点被预绑定到 $this,因此该 ASK 必须满足预绑定限制,数据图中并不存在的节点也同样会得到应答。该 ASK 并不单独作出决定:由于两者陈述的是同一个目标,它的应答会与该目标自身的 SELECT 在同一数据图上的结果相互核对。两者应答不同的节点会以 ShapesError::SparqlTargetDisagreement 被拒绝,错误中点名该形状、两个查询、该节点以及两个应答,因为无论依据哪一个应答来检查它,都无法得到完整验证所给出的判定。完整的验证仍用其 SELECT 枚举目标,并且从不运行该 ASK。第二个 sh:ask、不是 ASK 查询的值,或违反预绑定限制的 ASK,都会在加载时被拒绝。没有 sh:ask 的目标检查候选节点的方式,是在其 SELECT 的结果中查找它。
SHACL 1.2 一致性
完整的 W3C shacl12-test-suite 逐字节随库固化在 vectors/shacl12/ 下,并经由库 API 运行:共 592 个测试,涵盖 213 个 sht:Validate、143 个 sht:EvalNodeExpr 与 27 个 sht:Infer 测试,以及 209 个 SPARQL 1.2 RL 语法、良构性、分层与求值测试。其中 591 个由上游清单列出。在这 591 个中,590 个按已批准的预期通过,且预期失败台账为空。其余 1 个是没有任何清单收录的随库固化文件中的条目,单独报告。唯一未通过的已批准条目 node-expr/shnex-sparql/hasLang-example 连同其理由一并报告为失败:它以两个参数调用 sparql:hasLang,而 SPARQL 1.2 语法中的 hasLANG 恰好接受一个参数。SPARQL 1.2 RL 的负例测试必须在其测试类型所指明的阶段失败,而不能在更早的阶段失败。复现方式:
cargo test -p purrdf-shapes --test w3c12_conformance -- --nocapture
这 213 个 sht:Validate 测试也会经由构建出的 purrdf validate --shacl-profile shacl-ed-2026-10-16 二进制运行,并由同一个评分器对照已批准的结果评分,因此该结果在已发布的接口上同样成立:
cargo test -p purrdf-cli --test w3c12_validate_cli -- --nocapture
已批准套件记分板的最后一行是 W3C12 TOTAL: passed 590, spec-contradicted 1, xfailed 0, ledger 0,未收录文件自己的那一行是 W3C12 UNLISTED: passed 1, exact 1, with-delta 0, total 1。
有一个随库固化的文件带有没有任何上游清单收录的测试条目:inference-rules/rdfs/rdfs1.ttl。它不属于已批准的套件,因此从不计入该套件的通过数。另一个单独的测试 w3c_shacl12_unlisted_vendored_files 严格按原文对它判分,并以它自己的标签报告。
sh:reifierShape 或 sh:reificationRequired 的结果以值节点作为 sh:value。SHACL 1.2 Core 第 7.8.5 节的文字定义用名称 t 指代两样东西。它开头写道「Let t be the triple term (focus node, $path, value node)」,随后写道「For each reifier t that does not conform to $reifierShape, there is a validation result with t as sh:value」,并在缺失具体化时写道「there is a validation result with t as sh:value」。已批准的测试 core/property/reifierShape-001 与 -002 都期望值节点,PurRDF 遵循已批准测试套件的这一解读。针对不符合形状的具体化节点的结果,还以 sh:detail 携带该具体化节点自身的验证结果,每条都以该具体化节点为焦点节点,因此报告仍会点名该具体化节点并说明其失败原因。缺失的具体化没有具体化节点,因而不携带任何细节。
在六个节点表达式测试中,已批准结果将计算得到的 xsd:decimal 写作 "4.0"、"3.0"、"42.0" 与 "00"。规范把计算所得字面量的词法形式留给处理器决定,因此 PurRDF 计算十进制数时带小数点和一位小数(4.0),并将 SECONDS 计为其参数词法形式的秒部分(00)。这六个条目与其他所有条目一样,按 RDF 项逐一与已批准结果比较判分。
sparql/component/validator-001(本套件与 SHACL 1.0 套件中各有一份)在不提供任何导入的情况下按名称通过。其 owl:imports <http://datashapes.org/dash> 所在的节点既不是文档自身的 IRI,也不是 owl:Ontology 或 sh:ShapesGraph,也不以其中之一作为其 owl:versionIRI,因此按照 OWL 2 到 RDF 的映射(§3.1.2)与 SHACL 1.2 Core,这条三元组是数据,而不是导入(参见形状图中的 owl:imports)。测试工具以空的导入表加载该用例。
SPARQL 1.2 RL 语法规则 [2] RuleOrDataBlock ::= Prologue ( RuleOrData+ ( Prologue1 RuleOrData? )* )? 按其明显的意图实现:在起始序言之后,声明与规则块或数据块可以自由交错,因此每条声明之后都可以跟任意数量的规则块或数据块。若按字面理解,该规则会拒绝 RULE … PREFIX … RULE … RULE …,却接受在最后两条规则之间多一条声明的同一组规则。
JSON-LD 实例投影与 JSON Schema
json_schema::compile 与 instance::project_graph 是一对。模式描述投影所写出的 JSON-LD @graph 文档,一个被投影的节点当且仅当符合形状时才通过验证,下文列出的已记录损失除外。投影不丢弃任何三元组。每个被携带的项都保留约束所能判定的内容:
@id是完整的 IRI,空节点则为_:label。它从不是紧凑 IRI,因此词法约束直接判定 IRI 的str()。键与@type值保持紧凑形式。- 良构的 RDF 列表是 JSON-LD 列表对象
{"@list": [...]},其单元不是@graph节点。rdf:nil是{"@list": []}。哪些列表会被转换,由 JSON-LD 1.1 Processing Algorithms and API 第 8.4.2 节的列表转换决定,并按严格解读,从而不丢弃任何三元组。分叉的、成环的、共享的、以 IRI 命名的或带注解的列表(含有类型为rdf:List的单元的列表也包括在内)保持节点图形式。作为另一个列表成员的列表,以其首单元的标签作为@index。@index不具有 RDF 意义,它使两个不同的成员列表保持区分。 - 裸 JSON 标量只出现在它精确表示该字面量的位置(JSON-LD 1.1 第 8.6 节):64 位以内的规范
xsd:integer,以及xsd:boolean的true或false。其他所有数值字面量都保留其{"@value", "@type"}对象。 rdf:dirLangString字面量携带@direction。
模式把 SHACL 1.2 列表组件投影到 @list 数组上。sh:minListLength 变为 minItems,sh:maxListLength 变为 maxItems,sh:uniqueMembers true 变为 uniqueItems,sh:memberShape 变为 items,并按单个值的模式编译。它们每一个都要求值是列表。在节点形状上,它们判定焦点节点的 rdf:first 与 rdf:rest。每个 sh:flags 字母(包括 i)都写入 ECMA-262 正则模式。i 遵循 XPath 的大小写变体,而不是简单大小写折叠。词法约束判定 IRI 的 @id。它们在编译时判定常量 rdf:nil、true 与 false,并把裸整数的数字串长度作为整数范围来判定。数值数据类型在其词法空间与值空间上加以区分。范围界对带类型的整数族或十进制字面量,按其词法形式上的次序正则模式进行比较,对 double 或 float 界则采用 SPARQL 的数值提升。xsd:dateTime、xsd:date 或 xsd:time 上的时间界,按词法形式上的次序正则模式,在 XSD 时间线上比较其数据类型的带类型字面量。时区使值成为一个时刻,24:00:00 是次日的午夜。带时区的值与不带时区的界(或反之)仅在相距超过 14 小时时才可比较。相距更近时它们不可比较,组件将此报告为违反。任何其他数据类型的值都违反该界。dateTime 或 time 界的正则模式逐一表述其 ±14:00 范围内的 1,681 个分钟,因此体积很大:约 100 KB,带小数秒的界则更大。节点形状的节点种类、sh:in、sh:hasValue 与词法约束判定焦点节点的 @id。
余下的情况都记录在正向台账上,每种情况附带其原因:
- 以链接的
@graph节点形式保留的列表不被判定。JSON Schema 关键字只判定它所作用的实例位置及其下方的位置,因此没有任何关键字能到达另一个节点的rdf:first。 - 节点形状的
sh:uniqueMembers不会把焦点节点自身的成员与其尾部的成员相比较。它们是两个实例位置。 - 裸整数数字串上的正则模式不被判定。数字串以
1开头的整数,不是minimum、maximum与multipleOf所表述的区间与剩余类的任何有限并集。 xsd:double或xsd:float词法形式上的范围界不被判定。位于某个界一侧的这些形式不构成正则语言。- 节点形状的类成员关系不被判定。它要经由其他节点上的
rdfs:subClassOf*三元组。
Pydantic 包通过一个作用于原始 JSON 项的验证器,强制执行列表组件(包括唯一性)。TypeScript 在任意大小下都能精确表述长度界,并在成员是有限多个标量时表述元素互不相同。对于无约束成员的互不相同元素,或整数下界,它没有对应的类型。LinkML 在 @list 槽上表述全部四项。GraphQL 把列表值承载为一个由节点引用与列表对象组成的 @oneOf 输入对象,并把每个成员承载为一个由成员形状的备选项组成的 @oneOf 输入对象,因此成员类型会被检查。GraphQL 列表类型没有长度或唯一性约束,其数值类型也没有界,因此这些都在其所在位置被记录。每个输出器判定依据(oracle)都在真实数据的投影实例上运行这些组件。
依据形状判定其值的属性形状,会把每个形状投影为单个值的模式,其编译方式与 sh:memberShape 相同。sh:node 与 sh:and 变为 allOf,sh:or 变为 anyOf,sh:xone 变为 oneOf,sh:not 变为 not。sh:someValue 在由多个值组成的数组上变为 contains,在单个值上则变为值模式本身,此时它要求该值存在。形状的属性形状判定的是值自身的属性,这些属性位于值自身的 @graph 节点上,因此它们被记录。当某个成员模式接受的比其形状更多时,oneOf 与 not 会拒绝一个值。因此,只有当每个成员形状都是精确的——即由 sh:datatype、sh:nodeKind、sh:in、sh:hasValue 以及其他精确形状构建,且没有任何内容被记录——时,才会输出它们。否则,该 sh:xone 或 sh:not 会被记录并被省略。sh:class 不是精确的,因为值的类型位于它自己的节点上。当单个值不加包装地写出、与多个值组成的数组并存时,值模式也会拒绝数组,因此数组中的每个值都会被判定。
Pydantic 通过其作用于原始 JSON 输入的运行时检查,强制执行 allOf、oneOf、not 与 contains,因此在其中每一项上都与验证结果一致。LinkML 将它们表述为 all_of、any_of、exactly_one_of、none_of 与 has_member,其中 has_member 的表达式是完整的值模式(包括类的值域),因此没有任何内容需要记录。官方 LinkML 1.11.1 JSON Schema 生成器(LinkML 验证器也会运行它)只针对标量约束把 has_member 转换为 contains。因此,尽管 LinkML 模式声明了该约束,其输出仍会接受一个不含任何符合约束的值的数组。TypeScript 表述交集与并集,并记录它没有对应类型的 oneOf、not 与 contains。GraphQL 把组合委托给其自定义标量。每个输出器判定依据(oracle)都在真实数据的投影实例上运行这些约束。
每个输出器判定依据还在投影实例上运行时间界。在每个时间界上,Pydantic 与 LinkML 都与验证结果一致。TypeScript 与 GraphQL 在该界所在位置记录其否定。两者都没有补集类型。TypeScript 也无法正向写出被接纳的词法形式,因为仅四位数年份的日期就已超出其并集上限。
本体完整的开发者模式(schema)
公开的 compile_schema 边界接受一个 SchemaCompileRequest,它绑定解析后的形状、精确的本体数据集、调用方持有的 Namespaces,以及一个显式的 SchemaSurfaceMode。ShapedOnly 保留活动的 SHACL 目标类接口。OntologyComplete 额外加入调用方词汇中已有的类,以及可选的、由 OWL/RDFS 推导的属性。结果携带 JSON Schema draft 2020-12、OpenAPI 3.1、常规的正向损失台账、一份规范的属性覆盖报告,以及一个确定性的预编译缓存键。其 CompiledSchema 供 LinkML、TypeScript、GraphQL 与 Pydantic 输出器使用,无需第二遍模式发现。
有界理论只收录模式证据:直接 IRI 形式的 sh:path、RDF/OWL 属性声明、定义域/值域声明,以及子属性、等价属性与逆属性关系的两个端点。仅在实例上出现的谓词不会被提升。类的接纳同样是显式的,合成的定义仅限于调用方提供的命名空间;PurRDF 不会把内置的压缩前缀变成本体边界。
子类/等价类闭包决定定义域成员关系。多个定义域是合取关系;OWL 并集的成员是备选项,交集的成员是合取关系。子属性继承父属性的定义域、值域与正向函数性,等价属性双向传播,逆属性交换定义域与值域。强连通环以确定性方式收缩。多个值域在输出的 JSON Schema 中仍保持合取;并集与交集表达式分别映射为 anyOf 与 allOf。
匿名类表达式是该理论的一部分。命名类通过 rdfs:subClassOf 或 owl:equivalentClass 关联到的限制(owl:someValuesFrom、owl:allValuesFrom、owl:hasValue、owl:hasSelf,以及基于 owl:onClass 或 owl:onDataRange 的非限定与限定基数)或布尔形式(owl:unionOf、owl:intersectionOf、owl:complementOf、owl:oneOf)会连同其源公理一起被记录,并由每个子类继承;若断言于 owl:Thing,它对每个类都成立,而 owl:Thing 上的全称限制就是该属性的值域。它所命名的属性加入属性目录,并在承载该限制的类上输出,无论其声明的定义域为何;该公理作为溯源出现在其拥有者以及引用它的类的覆盖行上。若某属性的逆被命名,则针对该属性之逆的限制就是针对那个命名属性的限制。由 owl:onDatatype 与 owl:withRestrictions、owl:datatypeComplementOf 或字面量 owl:oneOf 构成的数据范围被读作填充项与值域;[ owl:inverseOf p ] 在任何可以出现属性表达式的位置都会被读取。OWL 2 数据类型映射以及 XSD 之外的 RDF 1.2 数据类型(owl:real、owl:rational、rdf:PlainLiteral、rdf:XMLLiteral、rdf:dirLangString、rdf:HTML、rdf:JSON)都是数据类型。IRI 与数据范围(或另一个数据类型)之间的等价定义了一个数据类型:此后,该数据类型的值要么满足其定义范围,要么以该数据类型的名称作为类型。类所等价的并集中的每个命名成员都成为它的子类,存在性限制则把类置于被限制属性的定义域之内,使该定义域的其他属性也能到达它。
开发者 schema 能够表述的部分会被投影到类定义上。owl:allValuesFrom 要求每个值都满足填充项;类填充项只作为节点引用来检查,这是一种近似,而 owl:Nothing 禁止该属性。存在性限制、owl:hasValue 或最小基数使该属性成为必需属性,并在填充项收窄取值时附加 contains 与 minContains。最大基数变为 maxItems;若限定项的值 schema 是精确的,则变为针对该限定项的 maxContains。数据类型限制的数值、时间、长度与正则(pattern)分面由 SHACL 值约束编译器编译,XSD 正则会被锚定;数据类型补集依据字面量的数据类型标签而非其值空间来判断,这是一种近似。由命名个体组成的 owl:oneOf 约束 @id,命名类的补集把该类排除在 @type 之外,限制的并集变为针对各成员属性约束的 anyOf。要求存在取值以及按不同的项计数,是以封闭世界的方式解读开放世界的公理,因此它们所涉及的覆盖行属于表示近似。
继承的限制以引用方式表示,而不是复制:拥有该限制的类把它放在 <Class>.Restriction.<property> 片段定义中,每个子类和每个下层片段都通过 allOf 引用最近拥有者的片段(析取同样通过 <Class>.Disjunctions 引用),因此 schema、溯源与清单随限制的数量增长,而不随层次结构的深度增长。IRI 上的类构造子,例如 ex:Day owl:oneOf ( … ) 或类型为 owl:Restriction 的 IRI,按 OWL 赋予它的等价关系来解读。
任何 schema 关键字都无法表述的部分会被报告,从不被丢弃:owl:hasSelf、针对未命名之逆或多个属性的限制、基于类限定项的最大基数、匿名表达式的补集、含有该类尚未蕴涵的命名成员的并集、owl:equivalentClass 的充分条件方向、子类为匿名表达式的一般类包含、出现在 owl:disjointWith、owl:AllDisjointClasses、owl:disjointUnionOf 与类断言中的匿名类,以及匿名类上的 owl:hasKey。SchemaCompileRequest::class_expression_report 与 compile_schema_with_class_expressions 返回类表达式清单:每条此类公理恰好出现一次,并在公理本身或拥有它的每个类上给出每个组成部分的结果(已投影、已近似、无法表示或被排除)及原因;拥有者之下的类只有在其结果不同时才有自己的行。类定义还会在 $comment 中列出其无法表示的组成部分。此前被接受的输入不会被拒绝:此前被跳过的公理中格式错误的匿名部分会被报告为无法表示。在一直会被读取的公理中,格式错误的表达式会被拒绝:没有属性的限制、不是非负整数的基数、限定项不匹配、取值不为 true 的 owl:hasSelf、没有构造的空节点或同时是类表达式与数据范围的空节点、格式错误的枚举、列表或数据类型限制、包含自身的表达式,或出现在需要类的位置上的数据范围。带有多种解读的空节点(多个分面、分面取值、属性、限定项或类构造)被读作这些解读的合取;定义数据类型上的分面约束的是其定义范围的值。空的、仅含一个成员的或含重复成员的并集与交集、空枚举、空分面列表以及超出 64 位的基数都按其含义读取,双关(punning)的属性则按基于 RDF 的语义读取。每个属性的值也都按这种方式读取,与其声明的种类无关:值可以是任意节点(IRI 可以指称一个数据值),也可以是任意类型正确的字面量(其词法形式属于其数据类型的词法空间;"abc"^^xsd:integer 不是)。没有值域约束的属性精确地表述这一点。数据范围按其值空间约束字面量,并不加判定地接受节点;类值域或类填充项不加判定地接受类型正确的字面量;二者都报告为近似,但与 rdfs:Literal 不相交的类精确地拒绝每个字面量。跨种类的 owl:hasValue 读作 ∃p.{v},数据类型属性上的 owl:hasSelf 读作自指限制;每个带有 owl:hasSelf 的单元格都报告为近似。owl:Nothing 以及按其形式为空的表达式(¬owl:Thing、空枚举)在任何值域或填充项位置都不接受任何值,并按精确报告:基于它的存在限制或限定最小基数使该类没有任何实例。一次请求最多展开 1,048,576 个表达式节点。
OWL 的值域、填充项、数据范围、枚举与 owl:hasValue 按字面量的值判断它,与 OWL 2 解读数据类型的方式一致,而 sh:datatype 判断的是其类型标签:xsd:decimal 接受整数 1,xsd:string 接受 xsd:token,1 的枚举匹配 "01"^^xsd:integer。十进制或整数值域对类型为 owl:rational 的字面量不加判断地接受,并报告为近似;长度或模式分面作用于每个字符串字面量的词法形式,即其值。在以井号结尾的命名空间下,schema 的 $id 去掉片段,这是 draft 2020-12 的要求。
直接的 SHACL 仍是权威。仅来自本体的字段是可选的,除非某个类限制要求它们;owl:FunctionalProperty 给出标量表示,并附带标明其为近似的溯源信息(approximation provenance),而逆函数性不会如此。封闭形状拒绝未被形状描述的字段,除非这些字段直接出现或被忽略。没有目标形状的类以开放载体的形式输出,绝不会被输出为捏造的封闭模型。这既不是 ABox 物化,也不是不受限的 OWL:属性链以及该片段之外的公理不会产生字段。
SchemaCoverageReport 对每个收录的属性恰好计入一次(包括被排除的属性),并附有排序后的逐类结果与源公理溯源。SchemaCompileRequest::coverage_report 可以在输出之前生成它。请求缓存键绑定形状图与本体图的 RDFC-1.0 标识、调用方命名空间、模式(mode)、值词汇标记、编译器/策略盐值,以及固定上限:65,536 个属性、65,536 个类、1,048,576 个关系或覆盖单元格、16,777,216 个类层次成员关系,以及表达式深度 64。格式错误的 OWL 列表、相互矛盾的属性种类/值域、键冲突以及上限耗尽,都是带类型的失败。
运行完整的双模式、四输出器示例:
cargo run -p purrdf-shapes --example ontology_schema_surface --locked
Schema → SHACL 导入
模式投影接口是双向的。SchemaImportConfig 要求调用方提供命名空间表,以及 JSON 标量到 RDF 数据类型的完整映射;不存在默认词汇表。五种生产用逆向转换是 JSON Schema draft 2020-12(import_json_schema)、原生 LinkML 1.11(import_linkml),以及经过校验的、由 PurRDF 输出的 Pydantic v2、TypeScript 7.0 与 GraphQL September 2025 包(import_*_package)。五者都经由同一个有序的 JSON-Schema 语义模型转换,返回带类型的形状,外加一份总会计算的、带位置的反向 LossLedger。
范围界读回时仍是其自身。次序正则模式表述的是位于某个界一侧的词法形式集合,而不是该界本身,而不同的界可以表述同一个集合:< 150 与 ≤ 149 接纳相同的整数。因此,编译器依据某个界写出的每条拒绝,都在其 $comment 中携带该界,形式为该分面(facet)的 SHACL 术语以及以 N-Triples 项表示的界,例如 sh:minInclusive "2020-01-01"^^<http://www.w3.org/2001/XMLSchema#date>。导入器只有在检查过注释之后才信任它。它重新生成所指名的界投影出的拒绝,并按值的 sh:datatype 收窄,这些拒绝必须恰好是携带该注释的那些。对于数值界,其旁边的 minimum 与 maximum 还必须正是该界所接纳的整数。任一项检查失败的注释都记录为 schema-applicator-dropped。因此,sh:maxExclusive 150、sh:minInclusive 1.5 以及 xsd:date、xsd:dateTime 或 xsd:time 上的界都能经受往返,重新输出的模式逐字节相同。
格式错误的值、开放或悬空的引用、标识冲突、生成的工件/映射漂移以及资源上限耗尽,都按失败即关闭(fail closed)处理。没有精确 SHACL 解释的有效源构造,会在其原生 JSON Pointer 处记入台账。任意的 Python、TypeScript 与 GraphQL SDL 被有意排除在逆向边界之外,因为它们都没有定义唯一的运行时 JSON 接受关系。LinkML 确实有原生读取器;因此,即使承载验证语义的 SHACL 逐字节重新编译一致,其模式标识与文档仍可能表现为损失。
可执行示例构造调用方持有的 example.org 配置,并覆盖全部五条路径:
cargo run -p purrdf-shapes --example schema_reverse --locked
Pydantic v2 投影
purrdf-shapes 可以完全在内存中把编译后的、由 SHACL 推导出的 JSON Schema 转写为一个确定性的、带类型的 Pydantic v2 包。公开函数 emit_pydantic 消费 CompiledSchema;PydanticConfig 要求调用方提供包名以及包/模块说明文字,因此库不会自行发明词汇表、命名空间或下游品牌。
每个 $defs 条目都获得一个稳定的导入路径,JSON 属性名通过 Pydantic 别名保持精确,生成的类通过 model_json_schema(by_alias=True) 公开其来源定义。Pydantic 运行时注解强制执行可表示的部分。没有精确运行时注解的 JSON Schema 断言在该模式接口上保持可见,并在总会计算的 json-schema → pydantic-v2 LossLedger 中产生一条带位置的条目;无损输入得到空台账。渲染器本身不依赖 Python,并保持 wasm-clean。一个仅用于开发的 Python 判定依据(oracle)执行生成的代码,并检查实际的反向/模式接口。import_pydantic_package 在导入 SHACL 之前,单独校验所保留的源模式、生成的文件、模型映射、方言以及正向台账。
JSON Schema 的 not 没有对应的注解。包改为在运行时检查它:一个 before 验证器在原始 JSON 输入上对被否定的模式求值。该检查遵循 JSON Schema 自身的语义。数字按精确值比较,字符串长度按码点计数,pattern 经由 Pydantic 自己的正则引擎运行。该检查覆盖一张封闭的关键字表,包括 $ref。使用任何其他关键字的被否定模式——例如 propertyNames、某种 format,或通用语法之外的 pattern——仍是一项已记录的损失。
可选的、由调用方持有的 PydanticPackageTopology 是把 $defs 条目划分到可移植的点分叶模块中的一个全划分。每条路由携带类的 docstring,以及一个排序后的、与词汇无关的 json_schema_extra 映射,适用于文档 URL、内容摘要以及其他由调用方定义的关联。可选的 PydanticVersionStamp 增加一个精确的 PEP 440 __version__ 导出。经路由的包共享模式/运行时支持模块,生成中间包的初始化文件,使用显式符号表完成一次根级重建,并通过可执行的运行时判定依据(oracle)以及严格模式的 mypy。精确的路由覆盖、可移植的路径/符号唯一性以及固定的输入/配置/输出上限,都按失败即关闭处理。拓扑与版本标记都省略时,原有的扁平包字节保持不变。扁平包的版本标记会增加 __about__.py 并更新 __init__.py 的导出。
LinkML 1.11 投影
同一个 CompiledSchema 载体可以用 emit_linkml 投影为规范的 LinkML 1.11。LinkmlConfig 要求调用方提供模式 IRI、名称、描述、默认前缀以及完整的前缀映射,因此 PurRDF 绝不会为使用方生成词汇表或标识。返回的 LinkmlPackage 包含带类型的文档、确定性的 YAML、一个可逆的 $defs 键映射,以及一份带位置的 json-schema → linkml-1.11 损失台账。它还携带有序的、经完整性检查的 slot 重命名报告与跳过诊断报告。
类以及精确的属性别名、类型、枚举、本地引用、内联对象、是否必需、同质数组、模式(pattern)、闭区间边界与 LinkML 布尔表达式都被直接表示。不安全的 LinkML slot 名默认使用 SanitizePolicy::Rename;Skip 只省略该 slot,并给出带位置的诊断/损失;Fail 返回带上下文的错误。Rename 在 slot_uri 中逐字节保留所声明的 CURIE 与绝对 IRI 标识;不安全的裸 token 或调用方精确指定的重新归属,会在调用方提供的默认前缀下获得一个被报告的标识。除非调用方标记了该确切 token,所有有效的 IRI scheme 都保持为绝对形式,因此不会根据拼写猜测自定义 scheme。安全名称优先保留,而基于哈希加序号的冲突分配是有界且确定性的。
每个不受支持的断言都由一张封闭的能力表分类;格式错误的输入、外部/动态/悬空引用、过时的重新归属提示、语义标识冲突以及超出固定上限,都按失败即关闭处理。parse_linkml 与 write_linkml 保留所有与 JSON 兼容的元模型字段,提供逐字节稳定的读/写往返(转换),同时拒绝仅限 YAML 的标签、重复键、非字符串键以及非有限数。
import_linkml 消费经过验证的原生文档;面向输出包的变体 import_linkml_package 会先校验规范 YAML 以及可逆的元素映射、slot 报告、策略损失、别名与输出的标识。两者使用同一个由调用方持有的 SHACL 导入配置。迁移适配器应原样传递 CompiledSchema,配置精确的重新归属,并消费 slot_renames;无需重写共享的属性键/必需键。
Rust 生产路径不依赖 LinkML 工具包。CI 仅把锁定版本的官方 LinkML 1.11.1 Python 包用作差分判定依据(oracle)。它通过 SchemaDefinition 与 SchemaView 加载安全、有损与重命名的测试夹具,重新生成 JSON Schema,并验证反向谓词:
make linkml-oracle
TypeScript 7.0 投影
emit_typescript 把同一个 CompiledSchema 投影为确定性的 TypeScript 7.0 声明。调用方通过 TypeScriptConfig 提供包名以及所有包/模块说明文字。返回的包包含一个 index.d.ts、一个从 $defs 键到导出类型的可逆映射,以及一份带位置的 json-schema → typescript-7.0 损失台账;PurRDF 不为使用方发明任何标识或词汇表。
固定的声明方言使用 strict 加 exactOptionalPropertyTypes。类型别名保留 JSON 原始类型与字面量、必需字段与可选字段之分、显式的 null、本地递归引用、并集、交集、数组以及元组。不存在运行时枚举、可合并的接口、带品牌的伪验证器或 any 逃生口。无效关键字、开放/悬空引用以及名称冲突都会在输出字节之前失败。
数组长度界在任意大小下都是精确的。元组元素表述每个特定位置的项。超出这些位置的长度以元素属性表述:上下文类型类似元组的数组字面量会被类型化为元组,而长度为 n 的元组恰好具有属性 "0" 到 "n-1"。因此,minItems: m 是一个必需属性 "m-1",maxItems: n 是一个可选的 never 属性 "n"。当各项只接纳有限多个 JSON 标量时,uniqueItems 同样是精确的。生成的 JsonDistinct 辅助类型把互不相同的序列枚举为元组类型的并集。枚举止于编译器的上限:实例化深度 100(TS2589),以及编译器将其展开为元组、或将交集分配于其上的并集中的 100,000 个成员(TS2590)。作用于有限 const 或 enum 的数值关键字,会排除不满足它们的数字。
TypeScript 结构可赋值性之外的运行时断言绝不会被静默抹去:整数、数值/字符串谓词、封闭性、模式属性、依赖、条件、否定、contains、唯一性以及求值状态等缺口,都会获得稳定的代码与 JSON Pointer 位置。作用于无限多个数的数值界,以及无限项类型的互不相同元素,都没有对应的类型。number 仅有的真子类型是字面量的并集,而元组类型对每个位置分别独立约束。判定依据(oracle)编译这些损失所依赖的事实:Exclude<number, -1> 仍接纳 -1,且每个枚举上限在其边缘处被接受、越过一步即被拒绝。CI 用一个 draft 2020-12 验证器独立地对实例分类,并用锁定版本的 TypeScript 7.0.2 编译器编译生成的声明,包括新鲜字面量与经由变量的探针:
make typescript-oracle
该投影有意不提供任意 TypeScript 的读取器。TypeScript 声明并未定义唯一的运行时 JSON 接受关系,而且该投影是多对一的。import_typescript_package 是权威的反向接口:它以确定性方式校验所保留的源模式、声明、可逆名称映射、方言以及正向台账。TypeScript 只是开发期的判定依据(oracle)依赖;Rust 输出器/导入器不访问文件系统,并保持 wasm-clean。
GraphQL September 2025 投影
emit_graphql 把 CompiledSchema 投影为确定性的 GraphQL September 2025 SDL。GraphqlConfig 没有默认值:调用方提供模式名称、包与模块说明文字,以及一个非内置的后备标量名称。返回的 GraphqlPackage 包含 schema.graphql、规范的 name-map.json、以带类型 Rust 数据表示的同一名称映射、一份带位置的 json-schema → graphql-september-2025 损失台账,以及生产用的值编解码器。
该 SDL 被有意设计为类型系统片段。PurRDF 输出成对的输出 type 对象与输入 input 对象,但不输出查询、变更或订阅根类型、解析器、分页规则、授权策略、联邦指令或其他应用行为。调用方把该片段与其自己的可执行模式组合起来。
精确语法包括 GraphQL 布尔值、字符串、数字、有符号 32 位 Int 值域、显式可空性、有限的 JSON const/enum 集合、封闭的对象字段、是否必需、同质列表、直接的本地 $defs 引用与别名、描述以及内联对象辅助类型。当每个值都只选中一个备选项时,anyOf 是精确的:依据其 JSON 种类,或者在对象备选项之间,依据一个其他备选项都未声明的必需键。它变为每个备选项各占一个字段的 @oneOf 输入对象,以及一个输出联合类型。不是对象类型的备选项,经由一个以其 value 字段承载它的包装类型成为联合成员。一个全局的、经冲突检查的命名空间覆盖类型、辅助类型与后备标量;字段与枚举符号在其 GraphQL 局部命名空间中检查。带类型/规范的名称映射保留源定义键、属性键以及有限的 JSON 值。
GraphqlPackage::encode_input 把源 JSON 键与有限值映射为输入字段名与枚举符号,并把联合值包装在其备选项的 @oneOf 字段中。若某个非对象值的种类不被任何备选项接纳,该值会原样通过,并由 GraphQL 强制转换拒绝。decode_input 是针对已强制转换参数的逆映射。encode_output 写出解析器(resolver)返回的值,其中联合值在 __typename 中指名其成员。decode_output 对 GraphQL 响应中出现的字段执行逆映射,不会凭空补出被省略的选择。未知或不兼容的值会失败。这个包编解码器是精确的值边界;import_graphql_package 是模式的反向边界,它校验 SDL、带类型/规范的映射、标识、所保留的源模式以及正向台账。任意的 GraphQL SDL 没有唯一的 JSON Schema 接受关系,不被接受为逆向格式。
GraphQL 变量强制转换与 JSON Schema 验证在以下封闭边界上存在差异:
| 边界 | 带位置的损失类别 |
|---|---|
| 对象字段与名称 | 附加属性、模式属性、属性名/属性数量 |
| 是否必需与递归 | 可空存在性放宽,一处确定性的递归输入可空性放宽 |
| 列表 | 单例强制转换、基数、contains、唯一性、元组、未求值项 |
| 标量断言 | 整数值域委托、数值谓词、字符串谓词 |
| 应用器(applicator) | 条件、依赖、交集、重叠的并集与类型数组并集、oneOf、否定 |
| 运行时边界 | 自定义标量与未知关键字的验证委托 |
由调用方命名的后备标量会被声明,但 PurRDF 不会自行发明其 parseValue、parseLiteral 或序列化语义。因此,每一处委托使用都会记入台账。损失条目携带稳定的代码与源 JSON Pointer 位置;精确的包台账为空。
对于无效的调用方配置、格式错误的模式关键字、$id 重定基准、外部/间接/悬空的 $ref、$dynamicRef/$recursiveRef、别名环、无法满足的封闭必需字段以及生成名称冲突,输出会在返回字节之前失败。输入模式没有固定的大小上限;每个工件的上限为每个输入字节四个字节,且至少 16 MiB。固定上限为:单个编解码值 16 MiB;定义数、每个对象的字段数或有限值数各 65,536;深度 128;每个 GraphQL 名称 255 字节。
独立的开发期判定依据(oracle)用 purrdf-jsonschema 对源值分类,用锁定版本的官方 GraphQL.js 16.14.0 构建 SDL,并执行真实的变量强制转换。它验证结果完全一致,验证每个封闭的损失类别及其位置、名称映射与生产用编解码器,以及刻意损坏时的失败。每个有效值还会经由其输出类型返回,且 GraphQL.js 必须原样序列化它:
make graphql-oracle
GraphQL.js 仅用于开发。输出与值转换仍是不访问文件系统、wasm-clean 的 Rust。
规则、节点表达式与形状图认证
验证之外还有四个工具。每个宿主都到达同一个库入口点,因此命令行、Python、WebAssembly 与 C 在答案上不可能出现分歧。
| 工具 | Rust | CLI | Python(purrdf.shapes) | WebAssembly | C ABI |
|---|---|---|---|---|---|
| 运行规则,写出推理图 | purrdf_shapes::infer, srl::infer | purrdf rules | apply_rules | shaclApplyRules | purrdf_shacl_apply_rules |
| 检查 SPARQL 1.2 RL 规则集,不运行任何规则 | srl::check | purrdf rules --srl FILE --check | check_rules | shaclCheckRules | purrdf_shacl_check_rules |
| 对单个节点表达式求值 | free_expression::evaluate | purrdf node-expr | eval_node_expr | shaclEvalNodeExpr | purrdf_shacl_eval_node_expr |
| 认证形状图 | lint::lint | purrdf shapes lint | lint_shapes | shaclLintShapes | purrdf_shacl_lint_shapes |
规则。 规则来源要么是形状图(运行其 SHACL 1.2 规则,即其默认规则集),要么是 SPARQL 1.2 RL 规则集,但不能两者兼有。结果是推理图:只包含推出的三元组,绝不包含数据图,以 N-Triples 1.2 按唯一的规范顺序给出。应请求,每个宿主还会返回每个推出三元组的证明。证明对每个三元组给出一个块:derived S P O .,随后是 rule R,以及规则体所匹配的每个事实各一行 premise S P O .。SPARQL 1.2 RL 数据块中的三元组则改为 data-block。
每个宿主在其两个 SHACL 规则入口点上都接受同样的四个规则求值上限:上文的规则运行,以及 SHACL-AF 蕴涵(Python shapes.entail、WebAssembly shaclEntail、C purrdf_shacl_entail_to_ntriples),后者对自身运行施加的界限与规则运行完全相同。在 WebAssembly 中,两个入口点都在导入表与 shapesGraph 之后按以下顺序连续接受这些上限:shaclApplyRules(dataNt, shapesTtl?, srl?, shapesBase?, srlBase?, explain?, importIris?, importDocuments?, shapesGraph?, maxTermGeneratingRounds?, maxGeneratedTerms?, maxStoredFacts?, maxJoinSteps?) 与 shaclEntail(shapesTtl, dataNt, shapesBase?, importIris?, importDocuments?, shapesGraph?, maxTermGeneratingRounds?, maxGeneratedTerms?, maxStoredFacts?, maxJoinSteps?)。
- 生成新项的轮数上限限制那些推出图中原本没有的项的求值轮数。默认值为 16384 轮。一个步进到 10,000 的计数器会完成。一个没有界的计数器每轮推出一个新项,同样受这一上限约束。
- 生成项预算限制在输入所含的项之外推出的项。默认值为
max(65536, 4 × N),其中N是数据图(以及 SPARQL 1.2 RL 规则集的数据块)中不同项的数量。新项每次迭代都翻倍的规则集会在几次迭代之内达到该预算,远早于达到轮数上限。 - 存储事实上限限制求值存储所持有的事实:数据图、规则集的数据以及每一条推出的三元组。默认值在原生环境下为 4,194,304 条事实,在 WebAssembly 中为 131,072 条,因为那里的存储位于同一块线性内存中。一条把 70,000 条
ex:p三元组逐条复制到ex:q的规则,或一条千节点链的传递闭包(500,500 条三元组),都能在原生环境下完成。 - 连接步数上限限制规则体所枚举的候选解。默认值在每个宿主上都是 1,048,576。它约束那些枚举的候选远多于其推出三元组的规则体:一个规则体在某一轮的候选会在检查上限之前就被全部持有,因此大得多的默认值会让笛卡尔积式的规则体先耗尽内存。需要更多工作量的规则集——千节点链的非线性传递闭包要枚举超过 6700 万个候选——需声明更大的上限。
越过任一上限的运行都会被拒绝。错误信息会点名该上限、相关数值、用于提高该上限的参数;对于两个与项相关的上限,还会点名在最后一次迭代中推出了新项的规则。参数采用调用方宿主的写法:命令行上为 --max-term-generating-rounds、--max-generated-terms、--max-stored-facts 与 --max-join-steps;Python 中为关键字参数 max_term_generating_rounds、max_generated_terms、max_stored_facts 与 max_join_steps;WebAssembly 中为 maxTermGeneratingRounds、maxGeneratedTerms、maxStoredFacts 与 maxJoinSteps;C 中为参数 max_term_generating_rounds、max_generated_terms、max_stored_facts 与 max_join_steps。蕴涵入口点点名的是它自己的参数:Python 中为 entail(max_stored_facts=...),WebAssembly 中为 shaclEntail's maxStoredFacts,C 中为 purrdf_shacl_entail_to_ntriples's max_stored_facts。一个不断推出新项的规则集最终是否会停止是不可判定的,因此错误信息从不称其为发散。声明的上限是精确的,而且上限只能拒绝:它所允许的运行,推出的内容与在任何更大上限下完全相同。
形状规则(即关联到某个形状、对每个焦点节点各运行一次的规则)在每次迭代中只会针对答案可能已改变的焦点节点重新运行:新出现的焦点节点,以及——按规则的三元组模式与路径的读取方式——上一次迭代新增的某条三元组所涉及的焦点节点。若规则读取的某条三元组与 $this 相隔一个连接步,则会针对每个焦点节点重新运行该规则;而答案不可重复的规则——即生成空节点、调用 RAND()、NOW()、UUID()、STRUUID() 或 PurRDF 无法解读的函数,或以 LIMIT、OFFSET、SAMPLE、GROUP_CONCAT 或 FOLD 挑选解的规则——会按规范的规定,在每次迭代中针对每个焦点节点运行。规则所读取的图会以每次迭代新增的内容进行扩展,而不是重新构建。推出的三元组、它们的空节点标签及其证明,都与每次迭代运行全部焦点节点时完全相同。改变的是代价:一条每次迭代生成一个新焦点节点的形状规则,每次迭代只需付出一次运行的代价,而不是按迄今为止的焦点节点数各运行一次,因此一条永不停止的规则会被某个项上限拒绝——新项保持较短时为轮数上限,每个新项都比上一个更长时为固定的 16 MiB 项存储区上限——而绝不会被连接步数上限拒绝。
查询为合取模式(三元组模式、FILTER 与 BIND,不含 OPTIONAL、UNION、MINUS、子查询或图访问)的全局 SPARQL 规则,会以规则元素的方式运行。于是每次迭代只需为新增的内容付出代价,而不必遍历整个求值图,且推出的三元组相同。BIND 变量必须出现在每个模板三元组中,且模板不得含有空节点。否则,该规则仍像以前一样,作为作用于整个图的生产者运行。
import purrdf

out = purrdf.shapes.apply_rules(data_nt, shapes_ttl, explain=True,
                                max_term_generating_rounds=1024)
print(out["inferred"])   # 推理图,N-Triples
print(out["proof"])      # 证明文本
out = purrdf.shapes.apply_rules(data_nt, srl=srl_text)  # SPARQL 1.2 RL
检查 SPARQL 1.2 RL 规则集。 规则集可以在不运行的情况下接受检查。检查会施加截至某一级别的静态检查,每一级都包含之前的各级。syntax 检查规则集及其 IMPORTS 闭包所读取的每份文档的 SPARQL 1.2 RL 语法。well-formed 还会检查每条规则(包括导入的规则)是否良构。stratified 还会检查合并后的规则集能否分层。它是默认级别,并且恰好就是规则运行在求值之前施加的那组检查:每个宿主的规则运行都会先经过同一检查。导入从运行所接受的同一导入表解析。不读取任何数据图,也不运行任何规则。通过检查的规则集会返回其规则、数据块三元组数量、导入的规则集、VERSION 标签和分层,以及一行每个宿主都以相同方式打印的摘要。被拒绝的规则集以拒绝它的那一阶段的错误失败。W3C SPARQL 1.2 RL 套件的语法、良构性与分层测试都通过这一检查评分。正向语法测试「regardless of well-formedness and stratification」都是有效的,因此以 syntax 级别评分。其中十五个在完整检查中失败,由后面的阶段拒绝。
syntax 阶段还会约束规则集宣告其版本的位置。SPARQL 1.2 RL §7.1 写道「The version announcement SHOULD be made early in the document」,PurRDF 将其读作必须。若规则集的第一条 VERSION 指令位于某个 RULE 或 DATA 块之后,则在 syntax 阶段被拒绝,并点名该句。规则集可以不宣告任何版本;在较早的 VERSION 之后出现的后续 VERSION,对文档中其后的部分而言仍是一条指令。
purrdf rules --srl closure.srl --check              # 全部静态检查
purrdf rules --srl closure.srl --check=syntax       # 仅检查语法
节点表达式。 形状图中的单个节点表达式针对数据图的某个焦点节点求值,即 SHACL 1.2 节点表达式中的 evalExpr(expr, focusGraph, focusNode, scope)。表达式由形状解析器本身解析,因此自定义函数、形状引用与 sh:prefixes 的绑定方式与在形状内部相同。作用域变量按名称绑定,并由 shnex:var 读取。输出节点以 N-Triples 项的形式返回,顺序由表达式的序列语义决定,与之并列返回的是形状图的强制诊断——求值会像其他每一次运行一样报告它们(参见报告是一个数据集):purrdf node-expr 在其 node-expr outputs N 行之后向 stderr 写出 shacl diagnostic RULE SHAPE 行,Python 的 eval_node_expr 返回 {"outputs", "diagnostics"},WebAssembly 的 shaclEvalNodeExpr 返回一个带有 outputs 与 diagnostics 的 ShaclNodeExprOutcome,C 的 purrdf_shacl_eval_node_expr 则把 diagnostic RULE SHAPE 行写入非 NULL 的 out_diagnostics。
每个宿主都以下列三种方式之一指名表达式:
- 节点本身:一个 IRI,或以
_:label表示形状文档所标注的空节点。不作为任何三元组主语的 IRI 是常量表达式,求值结果为其自身。 - 从一个具名节点出发的游走:一个起始节点以及一个或多个谓词,按顺序沿其前进。每一步都必须恰好到达一个值;到达零个或多于一个值的步骤会被拒绝,错误信息会点名该步骤与计数。匿名的
[ … ]表达式就是这样被指名的,而大多数节点表达式正是以匿名形式书写的。ex:Label再接sh:values,就是该属性形状的计算值表达式。W3Csht:EvalNodeExpr测试条目的表达式是:该条目,然后mf:action,然后sht:nodeExpr。该套件全部 143 个节点表达式测试都以这种方式经由purrdf node-expr运行。 - 内联 Turtle:一份在形状文档的前缀与基准下读取的 Turtle 文档,其自身的指令优先。它被合并进形状图,因此其中的形状引用与函数调用在那里绑定,而它的空节点与形状文档的空节点保持分离。表达式是该文档唯一的根:作为某个三元组的主语、且不作为任何三元组宾语的那个空节点。没有根或有多个根的文档会被拒绝。
| 宿主 | 节点 | 游走 | 内联 Turtle |
|---|---|---|---|
| CLI | --expr | --expr-at NODE --expr-via PREDICATE… | --expr-turtle, --expr-turtle-file |
| Python | expr | expr_at=, expr_via=[…] | expr_turtle= |
| WebAssembly | expr | exprAt, exprVia | exprTurtle |
| C ABI | expr | expr_at, expr_via, expr_via_count | expr_turtle |
Rust(purrdf_validate) | ExprSelector::Node | ExprSelector::At | ExprSelector::Turtle |
三者一个都不指名,或指名多于一个,都会被拒绝。
purrdf.shapes.eval_node_expr(shapes_ttl, data_nt, "_:suffix",
                             "http://example.org/a", scope={"suffix": '"!"'})
purrdf.shapes.eval_node_expr(shapes_ttl, data_nt, None, "http://example.org/a",
                             expr_at="http://example.org/Label",
                             expr_via=["http://www.w3.org/ns/shacl#values"])
purrdf.shapes.eval_node_expr(shapes_ttl, data_nt, None, "http://example.org/a",
                             expr_turtle="[ sh:path ex:name ] .")
purrdf node-expr --shapes shapes.ttl --expr-turtle '[ sh:path ex:name ] .' \
  --focus http://example.org/a data.ttl
形状图认证。 加载形状图是热路径:它拒绝遇到的第一个无法如实求值的构造,且不为依据 W3C shacl-shacl.ttl 验证该图付出代价。lint 按需付出这一代价一次,并报告七个部分:
load:加载器的裁决,即接受,或它抛出的拒绝。shacl-shacl:依据随库固化的shacl-shacl.ttl验证形状图所得的每条结果。该文件早于 SHACL 1.2 Core 的部分放宽(取列表值的sh:nodeKind、以路径为值的sh:equals、以节点表达式给出的sh:targetNode)。若某条结果所指出的构造在 SHACL 1.2 Core 中是良构的,该结果会被标记为superseded,不算作问题,但仅在加载器接受了该图时如此。functions:每个节点表达式函数调用绑定到哪个实现——native、custom、sparql-registered或host-extension。对于合并了 W3C SHACL 1.2 词汇表的形状图,即使图中声明了sh:SPARQLExprExpression,sh:sparqlExpr调用仍绑定为native。validators:形状图为内置约束组件声明的每个验证器,这些验证器被原生实现取代,从不运行。这些行从不算作问题。unexecuted:每个违反预绑定限制、且从不被运行的查询,即内置组件的验证器、其组件的任何使用都未选中的验证器、没有任何调用的sh:SPARQLFunction,或没有任何形状实例化的sh:SPARQLTargetType。加载会接受它们;它们在这里各计为一个问题。违反语法规则的声明从不列在这里,因为它会使加载失败。diagnostics:每一条强制诊断,每个sh:in或sh:xone列表为空的形状各占一行diagnostic RULE SHAPE。RULE是语法规则 id,即in-minListLength或xone-minListLength(「Each such list SHOULD have at least one member」)。这样的形状图是良构的,也可以正常验证(见下文),但该规则向作者传达了需要知道的信息,因此无论加载是否成功,lint 都会报告它,且每一行都算作一个问题。shacl-shacl.ttl会就同一个空列表发出警告;该结果列出时标记为diagnosed RULE,不会被重复计数。unanchored-imports:导入闭包中每条因其主语不是所在文档的锚点而不属于导入的owl:imports三元组(参见形状图中的owl:imports)。每一条都是数据,因此不会去查找任何文档。这些行从不算作问题。W3C 标记的情形改由shacl-shacl报告:其shsh:DataGraphImportsShape会以sh:Info严重级别,报告使用了owl:imports却不带owl:Ontology类型的sh:DataGraph。
当加载器接受了该图、每条 shacl-shacl 结果都已被取代(sh:Info 结果与其他结果一样计入)、没有任何未执行的查询违反预绑定限制,且没有任何强制诊断适用时,报告即为干净。unanchored-imports 从不影响这一点。每个宿主渲染同一份确定性的文本;CLI 参考给出了示例。
从 Python 调用
from purrdf import shacl

report = shacl.validate(shapes_ttl="...", data_nt="...")
print(report["conforms"])  # True / False
print(report["results"])   # 违规字典列表
每个结果字典保留稳定的键 focus、path、value、severity、component、source_shape 与 messages(每条 sh:resultMessage,各为一个字典,含 text,存在时还含其 language / direction / datatype)。携带 SHACL-SPARQL 结果注解的结果还带有 annotations:一个元组列表,每个元组由一个属性 IRI 与一个采用 N-Triples 语法的值组成。
带日期的 SHACL 法则
未选择时,SHACL 验证按兼容法则运行。调用方按稳定标识符选择一种精确的、带日期的 SHACL 法则:shacl-rec-2017-07-20(2017 年推荐标准)、shacl-wd-2026-09-18(SHACL 1.2 工作草案)或 shacl-ed-2026-10-16(W3C SHACL 1.2 测试套件所取自的 data-shapes 编辑草案,也是 PurRDF 的 EARL 报告据以评分的法则)。每个宿主都以同样的方式选择同一种法则,并且每个宿主都通过 purrdf_validate::complete_profile 把该标识符精确地解码一次。
| 宿主 | 写法 |
|---|---|
| CLI | validate 上的 --shacl-profile <ID>,可与 --shapes、--shapes-product(预备产物不存储 SHACL 法则,因此恢复时从请求中取得法则)或 --changes 搭配使用 |
| Python | shapes.validate 与 Shapes 构造函数上的 shacl_profile= |
| WebAssembly | shaclValidateToSarif 末尾的 shaclProfile 参数;其异步孪生入口则在选项对象中接受它 |
| C | purrdf_shacl_validate_to_sarif_law 上的 shacl_profile,它在 purrdf_shacl_validate_to_sarif_xpath_regex 的基础上增加该参数,且不改变任何现有签名 |
purrdf validate --shapes shapes.ttl --shacl-profile shacl-ed-2026-10-16 data.ttl
不对应任何法则的标识符(包括 shacl-ed-2026-10-17)会被拒绝,状态为 unsupported-profile,也不会替换为相近的版本。所选法则的文本所拒绝的形状图,会在加载时被拒绝,绝不会改用另一种法则验证。每个宿主上同一对用例都表明了这一点。兼容法则会在加载时拒绝 sparql/pre-binding/pre-binding-009,因为它在一个未预绑定的变量上使用了 VALUES,而编辑草案会验证它。工作草案会拒绝 sparql/node/prefixes-003(它通过版本 IRI 到达前缀声明),而编辑草案会验证它。
带日期的法则自带其 XPath 法则组合(见带日期的 XPath 正则法则)。在它旁边指名另一种 XPath 法则,例如 --shacl-profile shacl-ed-2026-10-16 --xpath-regex xpath-2.0-2010-12-14,会作为用法错误被拒绝;指名同一种法则则被接受。节点表达式与 SPARQL 1.2 RL 记录与法则无关,不接受 SHACL 法则。
带日期的 XPath 正则法则
sh:pattern 及其 sh:flags,以及 SHACL-SPARQL 目标、约束与 SHACL-AF 函数中的 REGEX 与 REPLACE,都运行在兼容正则表达式之上,除非调用方按名称选择一种带日期的原生 XPath 法则:xpath-2.0-2010-12-14(XPath and XQuery Functions and Operators 2.0,第二版)或 xpath-3.1-2017-03-21(Functions and Operators 3.1)。两者都接受反向引用,因此 sh:pattern "^(a)\\1$" 接受 "aa"。只有 3.1 接受非捕获组和 q 标志。求值模式的形状图工具同样接受该法则。对规则而言,它覆盖 SHACL 规则、SHACL-AF 函数、节点表达式以及 SPARQL 1.2 RL 过滤器与赋值中的 REGEX/REPLACE,以及规则条件中的 sh:pattern。对节点表达式而言,它覆盖过滤形状的 sh:pattern,以及函数调用与基于 SPARQL 的表达式中的 REGEX/REPLACE。lint 不编译也不匹配任何模式,因此不接受法则。
| 宿主 | 写法 |
|---|---|
| Rust | PreparedShapes::with_xpath_regex(profile, limits)(返回一个 XPathPreparedShapes)以及自由函数 purrdf_shapes::xpath::validate_dataset;purrdf-validate 的 *_with_xpath_regex 孪生函数(validate_to_sarif_string、validate_changes_to_sarif_string、validate_with_shapes_product、validate_with_rebuilt_shapes_product、entail_to_ntriples、apply_rules_to_ntriples 与 eval_node_expr)接受 xpath_regex::parse_profile 返回的 profile |
| CLI | validate(配合 --shapes、--shapes-product 或 --changes)、rules 与 node-expr 上的 --xpath-regex <NAME>;rules --check 拒绝该标志,shapes lint 不提供该标志 |
| Python | shapes.validate、Shapes.validate_nt、Shapes.validate_store、PreparedShapes.validate_nt、PreparedShapes.validate_store_changes、shapes.entail、shapes.apply_rules 与 shapes.eval_node_expr 上的 xpath_regex= |
| WebAssembly | shaclValidateToSarif、shaclValidateChangesToSarif、四个 shaclProductValidateToSarif… 入口、shaclEntail、shaclApplyRules 与 shaclEvalNodeExpr 的尾随参数 xpathRegex;它们的异步孪生方法在选项对象中接受它 |
| C | purrdf_shacl_validate_to_sarif_xpath_regex、purrdf_shacl_validate_changes_to_sarif_xpath_regex、purrdf_shapes_product_admit_xpath_regex、purrdf_shapes_product_admit_expecting_xpath_regex、purrdf_shapes_product_rebuild_xpath_regex、purrdf_shapes_product_rebuild_expecting_xpath_regex、purrdf_shacl_entail_to_ntriples_xpath_regex、purrdf_shacl_apply_rules_xpath_regex 与 purrdf_shacl_eval_node_expr_xpath_regex 上的 regex_profile |
import purrdf

report = purrdf.shapes.validate(
    shapes_ttl, data_nt, xpath_regex="xpath-3.1-2017-03-21"
)
名称须精确匹配,因此 xpath-3.1 会被拒绝,并附上可接受名称的列表。未作选择时(没有关键字参数、选项或标志,或 regex_profile 为 NULL),兼容正则表达式的行为与以往完全一样。预备形状产物无需重新打包,因为法则属于求值,而不属于预备好的形状。
所选法则未定义的模式或标志,按无效模式一贯的方式报告:作为声明它的形状的一条结果。所选法则还在有限的资源上限下运行,其中包括 64 KiB 的模式源文本。超出任一上限会使验证以该资源的 xpath-* 代码失败,并且不写出任何报告、数据集或输出。资源拒绝绝不会变成判定为符合约束的图。
报告是一个数据集
ValidationReport::to_dataset() 把 W3C 验证报告——sh:ValidationReport 节点及其各个 sh:ValidationResult——物化为一个冻结的 RdfDataset,直接由报告自身的项构建,而不是经过 to_ntriples() → parse_dataset() 的往返(转换)。这条直接路径携带报告所含的每一个 RDF 1.2 项(包括作为焦点节点的三元组项)。以任意语法渲染报告时,需要先处理 to_dataset() 的结果,再把返回的数据集交给 serialize_dataset。这正是 purrdf validate --format 所做的。
报告携带来自两个图的空节点:焦点节点、值与注解值来自数据图,源形状来自形状图。空节点标签局限于使用它们的那个图,因此两份文档常常用同一个标签表示不同的节点。于是,报告把每个图的空节点写在该图自己的标签空间中:数据图为 _:dg0、_:dg1、…,形状图为 _:sg0、_:sg1、…,按首次出现的顺序编号。两个不同的节点绝不共享同一标签,同一个节点在其出现的每一处都保持同一标签,SARIF 投影中也是如此。这些标签不取决于由哪个解析器读取文档,因此以 Turtle、TriG 或 RDF/XML 写出的同一个形状图会得到相同的报告字节。ValidationReport::with_report_blank_labels() 返回重新标记后的报告,以及一个 ReportBlankLabels 映射,把每个报告标签映射回其所属的图与原始标签。内存中的 results 保留原始标签。报告所_生成_的空节点(报告节点、每条结果各一个、复杂 sh:path 的内部节点)与这两个标签空间都不相同。
验证产生的每份报告还会给出 sh:shapesGraphWellFormed。SHACL 1.2 Core §6.7.1.4 写道,检查形状图的处理器「SHOULD use the property sh:shapesGraphWellFormed to inform the consumer of the validation report about this fact」,而 true 表示「the processor was certain that the shapes graph that was used for the validation process is well-formed」。PurRDF 在验证之前就会拒绝格式错误的形状图,因此该值始终为 true。空的 sh:in 或 sh:xone 列表并不改变这一点。附录 A 的 in-minListLength 与 xone-minListLength 写道「Each such list SHOULD have at least one member」,PurRDF 把它们作为强制诊断来执行:形状图是良构的,验证按经批准的 W3C 测试 core/node/in-002、in-003、xone-002 与 xone-003 的要求照常进行,而 purrdf shapes lint(以及每个宿主的 lint 入口点)总会把每个空列表报告为一个点名该规则 id 的问题。ValidationReport::shapes_graph_well_formed 携带该值,SARIF 运行则以 properties.shaclShapesGraphWellFormed 携带它。
报告这些诊断的不只是 lint:每一次运行都会报告同样的诊断。验证报告把它们放在 ValidationReport::diagnostics 中——每个空列表对应一条 MandatoryDiagnostic,含规则 id 与形状——与结果并列,却绝不混入结果之中:诊断不是 sh:ValidationResult,它既不改变 sh:conforms,也不改变任何结果,W3C 评分也不受影响。它也不会被写入报告图。SHACL 没有定义任何可用于陈述形状图的报告项,而 PurRDF 不生成任何词汇,因此 RDF 报告与没有该诊断时完全相同。各个宿主转而在各自的专属位置中携带它。SARIF 日志把每条诊断放在 invocations[0].toolExecutionNotifications 中,作为级别为 note 的通知(「The notification is purely informational. There is no required action」,SARIF 2.1.0 §3.58.6),其 descriptor 在 tool.driver.notifications 中点名该规则。命令行在判定行之后向 stderr 写出 shacl diagnostic RULE SHAPE。Python 的 validate 字典与 ValidationReport 对象都有一个由 {"rule", "shape"} 字典组成的 diagnostics 列表。规则运行、蕴涵运行或节点表达式运行也会报告同样的诊断:purrdf rules 与 purrdf node-expr 写出同样的 stderr 行,Python 的 apply_rules、entail 与 eval_node_expr 字典携带 "diagnostics",WebAssembly 的 ShaclRulesInference、ShaclEntailment 与 ShaclNodeExprOutcome 有一个由 ShaclDiagnostic 值(rule、shape)组成的 diagnostics 数组,C 的 purrdf_shacl_apply_rules、purrdf_shacl_entail_to_ntriples 与 purrdf_shacl_eval_node_expr 则把 diagnostic RULE SHAPE 行写入非 NULL 的 out_diagnostics。这种编码在各宿主间是统一的:规则与形状是两个独立字段——在 Python 中是字典键,在 WebAssembly 中是 getter——C 的输出行以相同顺序携带同样的两个字段,规则在前。
SARIF 输出
验证报告在引擎中保持结构化;SARIF 2.1.0 边界是独立的 purrdf-validate crate(purrdf::validate),它把报告——或解析器诊断——渲染为可追溯到源位置、逐字节确定性的 SARIF 日志,供编辑器、CI 与代码扫描仪表板使用:
use purrdf::validate::{validate_to_sarif_string, SarifOptions};

let shapes = r#"
    @prefix sh:  <http://www.w3.org/ns/shacl#> .
    @prefix ex:  <http://example.org/> .
    @prefix xsd: <http://www.w3.org/2001/XMLSchema#> .
    ex:PersonShape a sh:NodeShape ;
      sh:targetClass ex:Person ;
      sh:property [ sh:path ex:age ; sh:datatype xsd:integer ] .
"#;
let data = r#"<http://example.org/alice> <http://www.w3.org/1999/02/22-rdf-syntax-ns#type> <http://example.org/Person> .
<http://example.org/alice> <http://example.org/age> "nope" .
"#;

let sarif = validate_to_sarif_string(shapes, None, data, &SarifOptions::default())
    .expect("sarif produced");
assert!(sarif.contains("\"version\": \"2.1.0\""));更底层的入口点(build_report_sarif、build_diagnostics_sarif)构建的是 SarifLog 值而非字符串,因此宿主可以在序列化之前合并多个 run。
一致性
该验证器由随库固化的 W3C SHACL 1.0 data-shapes 套件、随库固化的 W3C SHACL 1.2 套件、随库固化的 DASH SHACL-AF/规则语料,以及一个含 73 个用例、预期报告逐字节冻结的第一方冻结语料把关;SHACL Rules 的输出按 RDFC-1.0 同构与预期推理图比较。解析器还受 SHACL 1.2 规范自带的 SHACL-for-SHACL 形状图约束:在每个第一方与 W3C 形状图以及一组生成的变异体上,除已点名的用例外,它恰好在 shacl-shacl.ttl 报告违规时拒绝该图。参见一致性与测试。
预备形状产物
在查看任何一个焦点节点之前,形状图就已经过解析、链接与分析,而这项工作在同一文档的每次验证中都完全相同。预备形状产物(prepared shapes product)只做一次这项工作,并把结果以字节形式写出:一个确定性的、带版本的、经过认证的工件,携带编译后的 SHACL 模型及其可复用的分析结果,从而使进程可以恢复一个预备好的验证器,而无须重新解析 Turtle。
purrdf shacl pack 写出产物。purrdf validate --shapes-product 恢复产物,而不是解析形状文档。purrdf shacl verify 与 purrdf shacl explain 是这些字节的准入接口。
从磁盘读回的产物是不受信任的,对其解码是准入(admission),而不是解析。 产物中的任何内容都不能证明其自身的溯源。阶段 id、profile 以及完整的输入绑定都会在其中任何部分到达验证器之前受到检查,不匹配的情况会在一个具名维度上被拒绝,而不是在错误的配置下进行验证。这一设计所要防止的故障是静默的:在某一前缀映射、基准、词汇表或函数注册表下预备的产物,在不同的前缀映射、基准、词汇表或函数注册表下恢复时并不会崩溃——它会进行验证,并返回一份良构的报告,而报告所针对的形状图无人请求过。
这一接口背后的设计记录见 docs/design/purrdf-prepared-products.md。
生成产物
purrdf shacl pack \
  --shapes shapes.ttl \
  --base https://example.org/shapes \
  --out shapes.purrshp
--shapes 与 --out 是必需的;--out - 把原始字节写到 stdout。回执在工件_之后_写到 stderr,因此绝不会污染经管道传出的产物:
$ purrdf shacl pack --shapes shapes.ttl --out shapes.purrshp
shacl product bytes 4213
--shapes 指定一个路径;显式提供 --base 时,也可用 - 从标准输入读取。产物会记录其形状图解析时所用的基准,而标准输入没有可从中推导基准的检索 IRI;未提供 --base 时传入 --shapes - 属于用法错误。对于未显式提供 --base 的路径,会推导出文档自身的 file:// 检索 IRI——即 validate --shapes 解析该文档时所用的同一基准,因此打包与直接验证在相对引用解析为何物这一问题上不可能出现分歧。
除非 --shapes-from 指明另一种 RDF 语法,否则形状文档按 Turtle 读取。其编解码器所报告的前缀映射(Turtle 与 TriG 的 @prefix/PREFIX,RDF/XML 的 xmlns)是每个 SHACL-SPARQL 与 SHACL-AF 查询据以解析的后备前缀环境,产物会记录这一映射。同一个形状图无论以上述哪种语法写成,打包后都得到相同的裁决。
owl:imports 在打包时折叠,方式与 validate --shapes 的折叠方式相同
shacl pack 接受与 validate --shapes 完全相同的 --import IRI=FILE 表,解析同一个传递闭包,并打包合并后的图——闭包语义参见形状图中的 owl:imports,二者使用的是共享代码,而不是一份平行的重新实现:
purrdf shacl pack \
  --shapes root.ttl \
  --import https://example.org/lib=lib.ttl \
  --out shapes.purrshp
只有位于形状文档自身 IRI 上、owl:Ontology 头上、sh:ShapesGraph(包括 sh:RulesGraph 及其子类)上,或以其中之一作为其 owl:versionIRI 的节点上的 owl:imports 才是导入;在其他任何节点上(包括仅为 sh:DataGraph 的节点),它都是数据。对形状文档自身 IRI(--base、其 file:// 获取 IRI,或文档内的 @base)的导入,或对形状图中已有的图(<X> a owl:Ontology、<X> a sh:ShapesGraph,或 owl:versionIRI 为 <X> 的本体)的导入,都无需配对。其他任何没有配对能够解析的 owl:imports 都会被点名拒绝,与 validate --shapes 完全一致;导入闭包从未到达的配对会作为未使用而被拒绝。产物绝不会从比所指名者更小的形状图打包而成。
过去并非总是如此。shacl pack 曾经通过一条既无导入表、也完全没有诊断通道的路径读取形状文档,因此未解析的 owl:imports 会在没有任何输出的情况下被丢弃,所得产物携带的形状比其打包来源文档更少——每次恢复时都会给出一个已判定的、良构的、错误的裁决。如今,用 --import 打包与用同一 --import 验证该文档,按构造就会得到逐字节相同的报告:两条命令通过同一个函数读取并折叠闭包。
Python、C-ABI 与 WebAssembly 绑定以各自的导入表经由同一解析过程打包——Python 中为 imports=,JavaScript 中为 importIris / importDocuments,C 中为 import_iris / import_documents / import_count——导入闭包未备齐时,会以与其验证函数所抛出的相同的类型化导入错误被拒绝。参见每个宿主上的同一规则。
--shapes-graph 在打包时解析并记录,方式与 validate --shapes 的解析方式相同
SHACL-SPARQL 把形状图本身公开为一个命名图——sh:select 主体可以读取 GRAPH $shapesGraph { … }——而 --shapes-graph IRI 指定该图的名称,覆盖文档所声明的 sh:shapesGraph:
purrdf shacl pack \
  --shapes shapes.ttl \
  --shapes-graph https://example.org/shapes \
  --out shapes.purrshp
相对值依据形状文档解析时所用的同一基准进行解析——即 --base 指定的基准,或文档自身的 file:// 检索 IRI——这与 validate --shapes --shapes-graph 使用该标志时的推导完全相同。这种一致正是关键所在:用 --shapes-graph IRI 打包的产物与用 --shapes --shapes-graph IRI 验证的文档,会在同一个绝对 IRI 下公开 $shapesGraph,并得到逐字节相同的报告。在这个标志出现之前,shacl pack 根本无法记录任何覆盖,因此一个 SHACL-SPARQL 主体依赖 $shapesGraph 的形状图,经由 --shapes 验证得到一个答案,经由恢复的产物验证却得到另一个答案,而命令行上没有任何手段能够弥合这一差距。
省略 --shapes-graph 时,打包行为与以往完全相同:产物记录形状图自身声明的 sh:shapesGraph,若无声明则不记录。
其他每个宿主都以同样的方式记录它:Python 的 pack_product(..., shapes_graph=IRI) 与 Shapes(..., shapes_graph=IRI).prepare().to_product(),WebAssembly 的 shaclPackProduct(..., shapesGraph),以及 C 的 purrdf_shapes_product_encode(..., shapes_graph_iri, ...)。每一个都与命令行一样,相对于形状文档的基准解析相对值。
--box-role-vocab 在打包时解析并记录,方式与 validate --shapes 的解析方式相同
图盒角色注解(graph-box role annotation)功能采用调用方提供的词汇表——由一个命名空间通过拼接推导出的六个术语 IRI——而 PurRDF 不生成任何自有的词汇表 IRI,因此不存在默认值:没有 --box-role-vocab 时,该功能只是处于未激活状态,与以往完全一样。
purrdf shacl pack \
  --shapes shapes.ttl \
  --box-role-vocab https://example.org/meta/ \
  --out shapes.purrshp
--box-role-vocab NS 推导出 NSgraphBoxRole、NSboxABox、NSboxTBox、NSboxRBox、NSboxCBox 与 NSboxConfigBox,把该命名空间记录到产物的身份中(即 box-role-vocab 组成项——参见拒绝维度),并且与 validate --shapes --box-role-vocab NS 使用该标志时的推导完全相同:用该标志打包的产物与用同一标志验证的文档,会解析出相同的 box_role_vocab,因此会在完全相同的 vocabulary 组成项下恢复或运行。省略该标志时,打包行为与以往完全相同:该组成项记录为缺失,不收集也不标记任何角色注解。
写出器是逐字节确定性的。挂钟时间、随机性与哈希迭代顺序都不会影响它,因此对同一文档、基准 IRI 与导入表的两次运行会产生完全相同的字节,而基于产物内容寻址的缓存键是稳定的。
在 Rust 中:
use purrdf::shapes::engine::{parse_shapes, PreparedShapes};
use purrdf::shapes::product::ShapesProfile;
use std::sync::Arc;

let shapes = parse_shapes(shapes_ttl, Some("https://example.org/shapes"))?;
let prepared = PreparedShapes::new(Arc::new(shapes));
let product: Vec<u8> = prepared.to_product(&ShapesProfile::CORE)?;
ShapesProfile::CORE 需要显式指定,不存在默认值。它是本构建实现的唯一一个 profile——SHACL Core 加 SHACL-SPARQL 加 SHACL-AF,且没有任何宿主注入的依赖——调用方无法生成自己的 profile,因为调用方能够拼写出来的 profile 将是关于产物的一项声称,而不是关于产物的一项事实。
「零宿主注入依赖」是关于产物_需要_什么的陈述,而不是对宿主接线的禁止。注入原生 SPARQL 函数或自定义聚合的 Rust 宿主,通过宿主注入的实现中描述的入口点进行打包与恢复;其他所有调用方,以及所有非 Rust 绑定,都使用上面的普通路径。
产物携带什么,不携带什么
产物携带三个部分,总是三者齐全:
| 部分 | 携带内容 |
|---|---|
| identity(身份) | 预备阶段 id、profile id,以及解析输入(基准、前缀映射、sh:shapesGraph IRI、盒角色词汇表) |
| dataset(数据集) | 形状数据集本身,采用 PurRDF 的简洁(succinct)打包容器 |
| model(模型) | 声明式 SHACL 模型——节点形状、约束、路径、节点表达式、SHACL-AF 规则、sh:SPARQLTargetType 声明——以及作为其最后一个字段的、由该模型推导出的可复用类分析 |
每个部分都携带自己的 SHA-256;封套另外在一个封存的尾部中添加身份区域摘要与整个容器的摘要,该尾部还会重申总长度,因此在任何位置被截断或在任何位置被追加内容的产物都会被拒绝。
形状数据集随产物一起传递,出于两个彼此独立的原因。SHACL-SPARQL 把形状图公开为一个命名图——每个 sh:select 主体都绑定了 $shapesGraph——因此丢弃它的产物会恢复出一个对 GRAPH $shapesGraph { … } 返回零行、并将其报告为成功的验证器。此外,当产物由另一个构建写出时,rebuild 正是从它重新推导的;参见恢复产物。
目标不被携带,也没有为目标设置的部分。 目标解析是_数据图_的属性:缓存了已解析目标的产物,会针对旧快照的焦点节点验证新快照,产生一份每项发现都正确、而产物写出之后新增的一切都根本不存在的报告。目标总是按每个绑定的数据集逐次解析。产物从恢复路径中去掉的是解析、模型构建与形状分析——可复用的预备工作与按数据集的绑定是预算中不同的两行。
形状分析确实被去掉了,而不仅仅是被检查。 类分析——一次对循环安全的遍历,收集每个可到达的 sh:class、sh:targetClass 与 shnex:instancesOf IRI,并为每个 IRI 分配一个绑定行位置——作为模型部分的最后一个字段被携带,admit 读取它,而不是再次遍历形状树。它是被绑定的,而不是被信任的:身份中的 class-catalog 组成项正是这些配对(包括位置)的摘要,因此所携带的分析若不是产物打包时的那一份,就会被拒绝。它也不会在不同构建之间过时,因为预备阶段 id 是从类遍历自身的源码摘要得出的——可达性规则不同的构建不可能与打包该产物的构建共享同一阶段 id,因此 admit 会拒绝它,而 rebuild 会改为重新推导。
它与模型共享同一部分,而不是单独占用第四个部分,这样在它开始随产物传递时,部分目录与容器格式版本都无须变动;第四个部分会让此前打包的每个产物都无法_打开_,而这正是 rebuild 无法挽救的唯一一种状态。
出于同类原因,恢复的溯源也不被携带。 产物记录的是决定其形状_含义_的输入;某个特定预备结果是如何_获得_的,是关于一个进程中一次恢复的事实,因此对其编码的产物所携带的值,对除写出者之外的每个读取者都是假的。它还会为一个完全不改变含义的变更而改动预备阶段 id——一个针对模型含义的摘要——从而使此前写出的每个产物都失效。答案改为存放在恢复后的预备结果上,在那里它是真的:参见哪些形状产生了这一裁决。
RDF 1.2 的项身份在往返中完整保留,包括引用三元组、具体化节点(reifier)绑定、陈述注解,以及基础方向构成其身份一部分的 rdf:dirLangString 字面量("x"@en--ltr 与 "x"@en--rtl 是两个不同的项)。
形状图声明的 SPARQL 函数会被携带,并且由数据集携带。 SHACL-AF §5 的 sh:SPARQLFunction 由一个 IRI、一个有序的 sh:parameter 列表、一个 sh:select/sh:ask 主体和一个 sh:returnType 组成——全部由形状图陈述——因此恢复时会从产物已经携带的形状数据集重新推导该声明,而不是从模型中对它的第二份转录推导。这些声明只有一个解析器,恢复时会运行它,这正是恢复出的函数与解析出的函数保持一致的原因。SHACL 1.2 以表达式为主体的声明(sh:ListParameterExpressionFunction)同样会被携带,来源是模型,因为它们的主体_就是_节点表达式。
有一种能力会在打包时被拒绝,而不是在恢复时丢失,报告为 unsupported-capability:
- 模型中没有任何部分到达的已声明函数——例如,一个仅从
sh:sparql查询文本中调用的、以表达式为主体的声明。携带这些声明的是模型,因此模型从未到达的声明不在其中,据此写出的产物会把该调用点解析为空,并给出通过(绿色)的验证结果。从形状模型中调用该函数,它就可以打包。
不完整的 owl:imports 导入闭包不是一个准入维度:它被拒绝时尚不存在任何产物,因此每个宿主都把它报告为与其验证函数所抛出的相同的类型化导入错误,而产物只会从合并后的导入闭包打包而成——参见形状图中的 owl:imports。
数据图的 sh:shapesGraph 链接同样不是准入维度,而且产物无法纳入被链接的图:它在数据图存在之前就已预备好。用产物验证时,会依据产物所持有的内容检查每个链接——它的基准、其 owl:imports 导入闭包所吸收的每份文档(产物在其身份区段中记录这些文档的 IRI,因此自身没有本体头、由导入表提供的文档同样被持有),或其合并图所声明的某个形状图、本体或版本 IRI——其他任何链接都会以类型化导入错误被拒绝,kind 为 unheld-shapes-graph-link,并点名该链接。若要验证一个链接了更多形状的数据图,请把被链接的图打包进来(从形状图导入它),或从形状文档出发进行验证,并把该链接对应的文档放入导入表——参见数据图指名其形状图。
分发产物
产物是写出它的那个 PurRDF 构建的工件,而不是稳定的交换格式。应将其与将要恢复它的二进制文件一同分发——在同一个容器镜像、同一个发布包、同一个构建缓存条目中——并把它的字节视为缓存键,而不是文档。
恢复能否成功,取决于两项版本事实:
- 容器格式版本不是本构建所解码的版本时,会被直接拒绝。应使用将要执行该产物的构建重新打包。
- 预备阶段 id 是一个由内容推导出的摘要,涵盖声明式模型及其含义所依赖的各个表。它从不手动递增,因此不可能与模型的含义脱节。携带本构建所不认识的阶段 id 的产物_并非_无法使用:
rebuild可以恢复它。
由于写出器是确定性的,构建系统可以按内容寻址产物:打包、对字节求哈希,并在该哈希已存在时跳过这项工作。purrdf shacl explain 会在不准入任何内容的情况下读出产物自身的身份摘要,这是在决定恢复之前询问「这是否就是对应此配置的产物?」的低成本方式。
恢复产物
purrdf validate --shapes-product shapes.purrshp --format sarif data.ttl
--shapes 与 --shapes-product 互斥,且必须恰好提供其中之一。其裁决与 --shapes shapes.ttl 得出的裁决完全相同:运行的是同一个引擎入口点,作用于同样恢复出的形状。
描述形状解析的四个标志在与产物同用时会被点名拒绝,而不是被接受后忽略,因为这里不会发生该解析:
| 标志 | 拒绝原因 | 应当使用之处 |
|---|---|---|
--shapes-from | 指定形状文档读取时所用的语法,而产物不是文档 | 不适用 |
--shapes-graph | 产物记录其自身的 sh:shapesGraph IRI | 把 --shapes-graph IRI 传给 purrdf shacl pack 并重新打包 |
--import | owl:imports 闭包在打包时已折叠 | 把 --import IRI=FILE 传给 purrdf shacl pack |
--box-role-vocab | 产物记录其自身的盒角色词汇表(或对其有意的缺省) | 把 --box-role-vocab NS 传给 purrdf shacl pack 并重新打包 |
描述数据图的一切仍然有效:--from、--base、--format、governor(执行调控器)标志(--fuel、--deadline、--max-intermediate-cells、--max-scratch-bytes、--max-remote-requests),以及位置参数 IN/OUT。
哪些形状产生了这一裁决
每次 validate 运行都会在裁决之前向 stderr 写出一行 shacl shapes-provenance,指明其形状的来源:
$ purrdf validate --shapes-product shapes.purrshp data.ttl
shacl shapes-provenance restored-admitted 9f2c…64 lowercase hex…1b
shacl conforms false
shacl results 2
$ purrdf validate --shapes shapes.ttl data.ttl
shacl shapes-provenance parsed
shacl conforms false
shacl results 2
该标记是完全的(total)——总会有一个,且其中没有任何一个表示「未知」。恢复的产物会呈现该工件自身的输入绑定,即 shacl explain 在其 identity-digest 行上打印的同样 64 个十六进制数字,因此报告与其背后的工件是按同一种拼写进行比较的:
purrdf validate --shapes-product shapes.purrshp data.ttl 2> receipt
awk '/^shacl shapes-provenance restored-/{print $3}' receipt   # 该工件
三个标记分别是 parsed、restored-admitted <digest> 与 restored-rebuilt <digest>。两个恢复标记保持区分,因为摘要在二者上的含义不同:admitted 表示在任何内容到达验证器之前,产物的绑定已针对本进程进行了检查;而 rebuilt 表示该摘要是从工件上读出的,并且有意_未_加检查——关于为何在那里检查它会恰好拒绝该路径所要挽救的那些产物,参见rebuild,前向兼容路径。
这回答了认证所不回答的那一半问题。准入问的是_本进程可以执行这些字节吗?;溯源行回答的是_这份报告出自哪个工件?,这正是使用方事后在日志中查看某个裁决时会提出的问题。
把恢复绑定到本意所指的产物
上面的每项检查问的都是本进程——这是否是写出该备忘(memo)的构建,这些是否是产物预备时所针对的注册表,产物携带的类分析是否就是其自身身份所固定的那一份。其中没有一项会问命令行上指定的文件是否就是所需的产物,因为产物中没有任何内容表明本意所指的是哪个产物。因此指定了错误的产物并不是错误:
$ purrdf validate --shapes-product WRONG.purrshp data.ttl
shacl conforms true
这是关于一个无人问及的形状图的、已判定的、良构的、经过认证的裁决,并且以 0 退出。--expect-identity HEX 就是用来说明本意所指产物的方式:
$ purrdf validate --shapes-product WRONG.purrshp \
    --expect-identity 9f2c…64 lowercase hex…1b data.ttl
shacl dimension shapes-graph
purrdf: --shapes-product WRONG.purrshp: shapes-graph: this product was prepared
from the shapes graph whose input binding is 4b81…, and the caller required the
product bound to 9f2c…; …
HEX 是产物的输入绑定:其身份的 64 个十六进制数字,该身份同时涵盖形状数据集、sh:shapesGraph IRI、前缀映射、基准、profile、盒角色词汇表、全部三个注册表以及类目录。可通过任一会打印它的动词从目标产物上读出——shacl explain 的 identity-digest 行,或 shacl verify 的 stdout——并原样传回:
WANT=$(purrdf shacl explain shapes.purrshp | awk '/^identity-digest /{print $2}')
purrdf validate --shapes-product shapes.purrshp --expect-identity "$WANT" data.ttl
该检查是恢复所做的第一件事,先于 profile 与阶段 id:指定了错误工件的调用方会被如实告知这一点,而不是被引导去重新打包一个从来就不是其所需的产物。其代价是一次 32 字节的比较,因为在字节打开之时,身份摘要就已经解码完毕。
一个得到满足的期望不会改变其他任何东西。以产物自身的摘要使用 --expect-identity,产生的报告与不带该标志运行时逐字节相同——该标志改变的是入口,而不是答案。
有两种写法会作为用法错误被拒绝(退出码 2),而不是被接受:对 --shapes 使用 --expect-identity,因为形状文档没有可供要求的预备绑定;以及不是 64 个十六进制数字的值,这种情况不指明任何维度,因为根本没有检查过任何产物。输入时不区分大小写,因此经由清单或 CI 变量以大写形式传递的选择器仍然指向其产物。
写出器是逐字节确定性的,因此绑定是形状图及其解析输入的属性,而不是某次特定打包运行的属性:在相同的基准与前缀下重新打包同一形状图会得到相同的摘要,这正是该选择器值得与其所指产物一起写入部署清单的原因。
在底层,产物重新成为验证器有两种方式,它们是同一边界上的两个入口点,而不是某一个入口点上的标志:
admit——常用路径。它不重新推导任何开销大的内容:验证 profile,验证阶段 id,检查宿主提供的注册表,恢复数据集,解码模型及随之携带的类分析,对其进行链接,并检查完整的输入绑定——包括所携带的分析。rebuild——前向兼容路径,在阶段 id 为本构建所不认识的 id 时采用。它完全忽略模型部分——连同所携带的类分析——并在产物自身记录的解析输入下,从产物携带的数据集重新推导形状及其分析。这正是它能作为补救手段的原因:按定义,它所必须挽救的产物,其携带的分析来自不同的可达性规则。
每种绑定都能到达这两条路径,而不仅仅是 Rust:CLI 的 validate --shapes-product --rebuild、Python 的 ShapesProduct.rebuild()、C ABI 的 purrdf_shapes_product_rebuild,以及 WebAssembly 的 shaclProductValidateToSarifRebuild,都是此处描述的同一个双入口点扩展点,每一个恢复的都是 admit 会恢复其备忘的那个同一携带数据集——因此重建一个当前产物(其阶段 id 为本构建所认识)时,在每个接口上都会得到与 admit 逐字节相同的报告。rebuild 也可以与「本意所指是哪个产物」的期望组合使用:--rebuild --expect-identity、rebuild_expecting,以及完全相同的 Rust ShapesProductView::rebuild_expecting,都会首先检查该期望,与 admit_expecting 完全一样,因此从数据集重新推导绝不会绕过调用方所要求的绑定。
rebuild 不是 Turtle 后备。 不解析任何 RDF 文本,也不读取任何文件;数据集在封套摘要的保护下随产物传递。另一种做法——只携带编译后的模型,并告诉调用方为格式变更的那一天保留源文档——会使前向兼容性依赖于一个产物并不拥有、也无法认证的文件。
use purrdf::shapes::product::{HostBindings, ShapesProduct, ShapesProfile, STAGE_ID};

// 询问这些字节是什么,而不准入它们。
let known = ShapesProduct::open(&product)?.stage_id() == &STAGE_ID;

// 两个恢复扩展点都会消耗该视图,因此需重新打开才能使用其中一个。
let view = ShapesProduct::open(&product)?;
let prepared = if known {
    view.admit(&ShapesProfile::CORE, &HostBindings::empty())?
} else {
    view.rebuild(&ShapesProfile::CORE, &HostBindings::empty())?
};

// 或者说明本意所指的究竟是哪个产物,并在不是该产物时按失败即关闭(fail closed)处理。
// `wanted` 是 `declared_identity().digest()` 为目标产物返回的摘要
// ——与 `shacl explain` 打印的值相同。`admit_expecting` 与
// `rebuild_expecting` 会最先检查它,先于任一恢复扩展点所检查的
// 其他一切,因此修复策略的选择绝不会绕过该绑定。
let prepared = ShapesProduct::open(&product)?
    .admit_expecting(&ShapesProfile::CORE, &HostBindings::empty(), &wanted)?;
let prepared = ShapesProduct::open(&product)?
    .rebuild_expecting(&ShapesProfile::CORE, &HostBindings::empty(), &wanted)?;
ShapesProduct::open 运行容器的低成本完整性层级——魔数、格式版本、部分目录、规范化偏移量、零填充、每个部分的 SHA-256、身份区域、尾部、整个容器的摘要——并且不准入任何内容。持有所得的视图只是关于封装结构(framing)的陈述,从不是关于适用性的陈述,而这正是读取被拒绝产物所声明的身份之所以有用的原因。
宿主注入的实现
上文的一切都传入 HostBindings::empty(),这正是 ShapesProfile::CORE 产物所需要的:此类产物所使用的每项能力都由形状图自身声明。Rust 宿主仍然可以接入自己的原生 SPARQL 函数或自定义聚合,而当它这样做时,产物会绑定关于该宿主的两项事实,而不是一项:
- 注册表的声明——每个注入条目的 IRI、元数与易变性——这是在另一个进程中可复现的指纹所能涵盖的全部内容;以及
- 一个实现身份:调用方用来指明这些声明所解析到的构建的不透明字节串,例如发布版本或提交摘要。
第二项并非多此一举。同一宿主的两个构建可以把同一个 IRI 注册到两个不同的闭包上,二者声明完全相同的元数与易变性,却计算出不同的答案——从注册表所能陈述的关于自身的每项事实来看都无法区分。仅基于声明的绑定会在另一个构建下准入针对某一构建预备的产物,并给出通过(绿色)的验证结果,而这正是该编解码器所要排除的静默错误答案。
因此,注入集合非空的预备结果完全不带身份时无法打包:写出器会以 unsupported-capability 拒绝,而不是输出一个其宿主那一半无法被任何东西检查的产物。而在不同身份下提供相同声明的恢复,会在承载该身份的注册表维度上被拒绝。
use purrdf::validate::{
    admit_shapes_product_with_implementations, prepared_to_product_with_implementations,
};

// 用于把宿主原生实现的这一构建与其所有其他构建区分开来的
// 字节串。PurRDF 从不解释它。
const BUILD: &[u8] = b"example.org/host@1";

// `prepared` 在 `Shapes::functions` 中携带宿主的原生实现。
let product = prepared_to_product_with_implementations(&prepared, BUILD)?;

// ……而恢复在其所接入的注册表旁指明同一个构建。
let restored = admit_shapes_product_with_implementations(
    &product,
    &functions,
    &aggregates,
    &property_functions,
    BUILD,
)?;
该机制不做的是验证身份。PurRDF 无法读取宿主的机器码并确认这些字节指明的就是它;身份是调用方关于其自身构建的声称,编解码器所强制的是:声称_不同_身份的恢复会在边界处停止。用同一个身份拼写两个不同构建的宿主,等于告诉了绑定它们是同一个构建。
缺失的身份是空字节串,并且编码后不占任何内容:三个宿主行仍然只是单纯的声明指纹。正因如此,未注入任何内容的产物——也就是上述路径写出的每个产物——与一个从未听说过实现身份的构建所产生的结果逐字节相同。
佐证产物
$ purrdf shacl verify shapes.purrshp
9f2c…64 lowercase hex…1b
verify 是编解码器的冷路径,并且有意设计为无法从恢复中到达。它对形状图的空节点重新规范化,并将结果与产物身份所声称的摘要进行比较——这是一种图同构计算,其开销可能超过产物本来要消除的形状解析开销。应在构建步骤、发布检查或一致性测试框架中调用它;绝不要在每次验证之前调用。
admit 就数据集所确立的是:该部分正是容器所封存的那一个——按部分计算的 SHA-256 与整个容器的摘要都覆盖其字节,因此被替换的部分会被拒绝。只有 verify 才能确立的是:这些字节_规范化_后得到身份所记录的摘要。一个存储的规范化摘要被篡改过的产物能够打开,能够准入,而会在 verify 中失败;这种划分由测试固定,并非分层带来的偶然结果。
它在 stdout 上打印产物的 64 个字符的小写十六进制身份摘要,并以 0 退出。拒绝会在 stderr 上指明其维度,并以 1 退出。
读取产物而不准入它
$ purrdf shacl explain shapes.purrshp
format-version 1
stage-id 7416f78d…
stage-known true
identity-digest 9f2c…
identity-components 13
identity source-dataset 0x1f0a…
identity shapes-graph "(present) https://example.org/shapes"
identity doc-prefixes 0x02657808…
identity base "(present) https://example.org/shapes"
identity profile "purrdf-shacl-core-v1"
identity box-role-vocab 0x00
identity user-functions-declared 0x4c1d…
identity user-functions-injected 0x4c1d…
identity aggregate-registry 0xb7e0…
identity property-function-registry 0xb7e0…
identity class-catalog 0x63aa…
identity parse-configuration 0x17657874…
identity included-graphs 0x0800000000000000…
parse-base https://example.org/shapes
parse-shapes-graph https://example.org/shapes
parse-prefixes 3
parse-prefix ex https://example.org/
parse-prefix sh http://www.w3.org/ns/shacl#
parse-prefix xsd http://www.w3.org/2001/XMLSchema#
按固定顺序输出的确定性 key value 行,以换行符结尾,因此使用方无须解析器即可按空白切分。身份组成项的值在其为可打印 UTF-8 时呈现为 "text",否则呈现为 0x… 小写十六进制。
stage-known 是据以行动的事实:false 表示本构建的 admit 会拒绝这些字节,而 rebuild 是仍能恢复它们的路径。
上面的 identity box-role-vocab 0x00 是缺失的编码——该示例打包的产物没有使用 --box-role-vocab。使用了该标志打包的产物会呈现一段更长的 0x…(六个推导出的术语 IRI,带长度前缀并按键排序),绝不会是 0x00;二者有意设计为可区分的,这样恢复就绝不会把「该功能未激活」与「该功能在一个由空 IRI 组成的词汇表上激活」相混淆。
正是这一点使具名拒绝成为可据以行动的信息,而不只是一行日志。在 prefixes 上被拒绝的恢复,应通过读取产物实际携带的是哪个前缀映射并修正配置来应对——而不是靠猜测,也不是盲目地重新打包。在两个产物之间——手头的那个与本意所指的那个——比较这一答案,用的是 shacl diff,而不是运行两次 explain 再用肉眼比较呈现结果。
比较两个产物
$ purrdf shacl diff a.purrshp b.purrshp
diff-count 1
diff box-role-vocab 0x00 0x0108626f78…
shacl diff 打开两个产物,但不准入其中任何一个——与 shacl explain 读取时所用的同一个仅限封装结构与完整性的层级——并打印每个值不同的身份组成项,每个组成项一行 diff <label> <value-in-a> <value-in-b>,按 A 自身的组成项顺序排列。diff-count 0 且没有 diff 行,表示两个产物声明了完全相同的身份。
正是这一点使具名拒绝在两个工件之间、而不只是在一个工件上成为可据以行动的信息。shacl explain 回答的是「这个产物声称自己是由什么编译而来的」;在 diff 出现之前,恢复在某个具名维度上被拒绝的操作人员必须运行两次 explain——一次针对手头的产物,一次针对本想恢复的产物——并用肉眼比较呈现结果,以找出是哪项声明发生了变动。diff 就是这一比较,一次完成,作用于 explain 所呈现的完全相同的已解码组成项,因此二者在某个组成项的值是什么这一点上永远不会出现分歧。
退出码沿用 shacl verify 的已认证/已拒绝划分,而不是 validate 的符合/不符合划分,因为发现差异的 diff 是一个关于两个工件的已判定答案,而不是关于数据的验证裁决:两个身份完全相同时以 0 退出,不同时以 1 退出(无论哪种情况,差异都打印在 stdout 上),用法错误时以 2 退出。
diff 从不准入任何一方,因此它也适用于预备阶段 id 不为本构建所识别的产物——阶段 id 存放在产物单独的预备备忘中,而不在 diff 所比较的身份中,而这恰恰是操作人员求助于 diff 来弄清楚的情形:「validate --shapes-product 直接拒绝了这个文件;如果重新打包,具体会有什么变化?」
拒绝维度
每次拒绝都带有二十二个稳定的 kebab-case 标签之一,以 shacl dimension <label> 的形式打印到 stderr。据以分支的是维度;供人阅读的是消息。 不支持按消息文本进行匹配。
各维度由容器外层向内依次检查,第一个失败的维度就是被报告的维度——因此标签总是指明最外层未满足的前提条件,而不是其下游症状。
这二十二个维度按哪个动词能够报告它们分为两组,而这种划分并非分类学:它是该编解码器所围绕的成本决策。恢复是常用路径,不得对形状图的空节点进行规范化;认证是会进行规范化的冷路径。只有两者之一能够到达的维度,并不是另一方悄悄跳过的东西——而是表明该动词从不作出这一陈述。
准入时维度
由 validate --shapes-product 在每次恢复时报告;由 shacl explain 报告其在打开字节时所到达的结构性各行;由 shacl verify 报告,因为它在认证任何内容之前会先打开产物。
| 维度 | 含义 | 处理方法 |
|---|---|---|
magic | 这些字节从来就不是预备形状产物 | 向加载器提供由 purrdf shacl pack 写出的文件 |
format-version | 容器格式不是本构建所解码的格式 | 使用将要执行它的 PurRDF 构建重新打包 |
stage-id | 模型备忘是针对本构建已不再具有的模型写出的 | 用 rebuild 恢复,或重新打包 |
profile | 在不同的预备 profile 下预备 | 使用将要执行它的构建重新打包 |
truncated | 字节在其所声明的某个结构内部就结束了 | 重新打包——这是一次被中断的写入,而不是原地损坏 |
trailer | 尾部缺失,或与其之前的字节不一致 | 丢弃并重新打包 |
section-digest | 某个部分已不再与其记录的摘要相符 | 丢弃并重新打包——产物已原地损坏 |
container-digest | 整个容器的摘要与字节不符 | 丢弃并重新打包——部分主体之外的某些内容发生了变动 |
shapes-graph | 在不同的 sh:shapesGraph IRI 下预备——或者,在 --expect-identity 下,所携带的输入绑定不是所要求的那一个 | 在同一个命名图下公开这些形状,并以该 IRI 重新打包,或者让期望指向本意所指的产物 |
prefixes | 针对不同的前缀映射预备 | 在相同的前缀下打包与执行——前缀映射决定了前缀名表示哪个 IRI |
base | 针对不同的基准 IRI 预备 | 在相同的基准下打包与执行——相对引用依据它进行解析 |
vocabulary | 在不同的盒角色词汇表下预备 | 向 purrdf shacl pack 与执行方传入相同的 --box-role-vocab NS(或都不传);PurRDF 不生成任何词汇表 IRI,也没有可供回退的默认值 |
function-registry | 针对不同的 SPARQL 函数注册表预备,或针对其背后宿主实现的不同构建预备 | 在执行宿主中接入相同的函数,并使用相同的实现身份 |
aggregate-registry | 针对不同的自定义聚合注册表预备,或针对其背后宿主实现的不同构建预备 | 在执行宿主中接入相同的聚合,并使用相同的实现身份 |
property-function-registry | 针对不同的属性函数注册表预备,或针对其背后宿主实现的不同构建预备 | 在执行宿主中接入相同的关系,并使用相同的实现身份 |
class-catalog | 产物所携带的类分析不是其自身身份所固定的那一份 | 丢弃并从形状图重新打包——该部分与基于它的绑定已不再描述同一份分析 |
parse-configuration | 在不同的已声明扩展函数或关系命名空间下预备 | 在执行端宿主上声明相同的命名空间 |
included-graphs | 产物的形状图所由组装的命名图集合(其 --import 文档与已解析的 sh:shapesGraph 链接)与其绑定所固定的集合不同 | 以相同的导入表重新打包——所记录的图决定产物持有哪些数据图链接 |
unsupported-capability | 良构的字节要求本构建无法兑现的东西,或者是本构建不会为之写出产物的预备结果 | 参见消息——模型中没有任何部分到达的已声明函数、超出当前生效的暂存(scratch)上限的解码,或打包器未获得身份的宿主实现 |
depth-limit | 某个结构的嵌套超出了解码器的固定上限 | 从本构建能够解析的形状图重新打包;该上限是栈保护,而不是语义限制 |
malformed | 以其他任何维度都未指明的方式在结构上无效 | 丢弃并重新打包 |
其中三个对应三种真正不同的处理方式,而这正是为它们命名的意义所在:malformed 是需要丢弃的损坏缓存,format-version 是需要重新编译的过时工件,而 function-registry 是调用方自身进程中的配置错误,重新打包无法修复。
认证时维度
| 维度 | 含义 | 处理方法 |
|---|---|---|
dataset-identity | 产物所携带的形状数据集_规范化_后得不到其自身绑定所声称的摘要 | 丢弃并从形状图重新打包——该部分与基于它的绑定已不再描述同一个数据集 |
只有 shacl verify 报告这一维度。恢复不会对形状数据集重新规范化:它从产物自身的绑定中取得该组成项,因为这项计算是针对形状图空节点的图同构,其开销很可能超过产物本来要消除的形状解析开销。在每条路径上,封套按部分计算的 SHA-256 与整个容器的摘要仍然覆盖这些字节,因此被替换的部分会以 section-digest 或 container-digest 被拒绝;只有认证才能确立的是,这些字节规范化后得到绑定所声称的结果。
因此,一个存储的规范化摘要被篡改过的产物能够打开,能够准入,而会在 shacl verify 中失败。 这是一个由测试固定、有文档记录的划分,而不是漏洞:如果需要这一陈述,就运行 verify——在构建步骤、发布检查或一致性测试框架中运行,绝不要在每次验证之前运行。
有一种失败不带有任何维度:无法解析的形状_文档_或数据_文档_从未到达准入边界,因此没有检查任何内容,为它指明一个维度就等于声称并非如此。在 CLI 上不会打印 shacl dimension 行;在 Python 中,异常的 .dimension 为 None;在 JavaScript 中,dimension 为 undefined。
命令行动词
| 命令 | 作用 | 退出码 0 | 退出码 1 | 退出码 2 |
|---|---|---|---|---|
purrdf shacl pack --shapes FILE --out OUT [--base IRI] [--shapes-graph IRI] [--import IRI=FILE] [--box-role-vocab NS] | 解析、预备、写出产物 | 产物已写出 | 形状未能解析、图中声明了产物无法携带的内容,或某条 owl:imports 未解析 | 错误的标志、未提供 --base 时使用 --shapes -,或形状图无法解析的 --shapes-graph/--import |
purrdf shacl verify [IN] | 依据所声称的身份佐证所携带的数据集 | 打印身份摘要 | 被拒绝,并在 stderr 上输出 shacl dimension <label> | 错误的标志 |
purrdf shacl explain [IN] | 打印产物声称自己编译自什么 | 打印 key value 呈现 | 这些字节不是良构的产物 | 错误的标志 |
purrdf shacl diff A B | 比较两个产物声明的身份,而不准入其中任何一个 | 两个身份完全相同 | 两个身份不同(diff 行仍会打印在 stdout 上) | 错误的标志,或 A 与 B 都指定为标准输入 |
purrdf validate --shapes-product FILE [--rebuild] [--expect-identity HEX] [IN] | 恢复并验证——--rebuild 从所携带的数据集重新推导,而不是准入备忘 | 验证已运行 | 产物被拒绝 | 错误的标志、对产物传入了解析标志、在没有产物时使用 --rebuild 或 --expect-identity,或 --expect-identity 的值不是 64 个十六进制数字 |
对于 verify 与 explain,IN 默认为 -(标准输入)。对于 validate,--shapes-product - 会与数据图自身的默认值 - 冲突,因而被点名拒绝:标准输入只有一个。diff 的两个产物 A 与 B 都是必需的位置路径,没有默认值,原因完全相同:把两者都指定为标准输入,会使每个产物各得到同一字节流的一部分。
validate --shapes FILE [--box-role-vocab NS] 在解析通道上接受完全相同的标志——参见上文的生成产物——并在与 --shapes-product 同用时点名拒绝它,见上面的四标志表。
validate 在 governor(执行调控器)预算触发时还会以 3 退出,并且总是在运行之前写出 shacl shapes-provenance <token>,在运行之后写出 shacl conforms true 或 shacl conforms false 以及 shacl results <N>,全部输出到 stderr——包括形状来自产物的情况。
从 Python 调用
from purrdf import shapes

prepared = shapes.Shapes(shapes_ttl, base="https://example.org/shapes").prepare()
product = prepared.to_product()           # 字节,逐字节确定性

view = shapes.ShapesProduct.open(product) # 仅限封装结构与完整性
print(view.format_version())             # 1
print(view.stage_known())                # True
print(view.identity_digest())            # 64 个小写十六进制字符
for label, value in view.identity_components():
    print(label, value)

restored = view.admit() if view.stage_known() else view.rebuild()
report = restored.validate_nt(data_nt)
print(report.conforms)

# 该裁决出自哪个工件?完全的(total)——总有答案,绝不会是
# "unknown":"parsed"、"restored-admitted <digest>" 或 "restored-rebuilt <digest>"。
print(restored.provenance())             # restored-admitted 9f2c…1b

# ……或者说明本意所指的是哪个产物,并在不是该产物时按失败即关闭(fail closed)处理。
restored = view.admit_expecting("9f2c…64 lowercase hex…1b")

# 同一绑定,经由重建扩展点:期望会最先检查,
# 先于重新推导,因此选择重建绝不会绕过它。
restored = view.rebuild_expecting("9f2c…64 lowercase hex…1b")
PreparedShapes.provenance() 是 CLI 的 shacl shapes-provenance 回执在 Python 中的写法,呈现完全相同的标记——其中的摘要就是 identity_digest() 所报告的值,因此可以直接回传给 admit_expecting()。由 Shapes(...).prepare() 构建的预备结果回答 parsed,因为它从未从工件中恢复过,也不得为它虚构任何工件。
ShapesProduct.certify() 是冷路径;应从构建步骤或测试中调用它。拒绝会抛出 shapes.ShapesProductError,其 .dimension 携带标签字符串(从未检查过任何产物时为 None)。
子模块是 purrdf.shapes。purrdf.shacl 是同一对象的向后兼容别名,仍然可用,但新代码应写规范名称:该别名早于本页所描述的接口,而两个名称解析到同一个模块,在学习者看来就像是两套 API。
admit_expecting(expected_identity) 是绑定到本意所指产物的 admit():它接受 identity_digest() 所报告的 64 个十六进制数字,当产物携带不同的绑定时,抛出 .dimension == "shapes-graph" 的 ShapesProductError。不是摘要的选择器则会抛出普通的 ValueError——没有打开任何产物,因此不能把责任归到某个产物上。
rebuild() 从 admit() 恢复其备忘的那个同一携带数据集重新推导,因此在当前产物(stage_known() == True)上调用它会得到逐字节相同的报告——它是通往同一产物的第二道门,绝不是第二个、有分歧的答案。rebuild_expecting(expected_identity) 是它的绑定孪生版本,接受与 admit_expecting 完全相同的 expected_identity:期望会最先检查,先于重新推导,与 admit_expecting 上完全一样,因此求助于前向兼容挽救手段的调用方绝不会失去绑定。
在 JavaScript / WebAssembly 中
import {
  ready,
  shaclPackProduct,
  shaclProductExplain,
  shaclProductCertify,
  shaclProductValidateToSarif,
  shaclProductValidateToSarifRebuild,
  shaclProductValidateToSarifExpecting,
  shaclProductValidateToSarifRebuildExpecting,
} from "@blackcatinformatics/purrdf";

await ready(); // 一次性的异步 wasm 实例化

const product = shaclPackProduct(shapesTtl, "https://example.org/shapes");
console.log(shaclProductExplain(product));

try {
  const sarif = shaclProductValidateToSarif(product, dataNt);

  // ……或者,对于本客体(guest)不认识的阶段 id,从所携带的
  // 数据集重新推导,而不是准入备忘——即上文 `stage-id` 拒绝
  // 所会指明的补救手段。
  const rebuilt = shaclProductValidateToSarifRebuild(product, dataNt);

  // ……或者说明本意所指的是哪个产物,并在不是该产物时按失败即关闭(fail closed)处理。
  const bound = shaclProductValidateToSarifExpecting(product, dataNt, wantHex);

  // ……或者两者兼用:重建,并且在不是本意所指的产物时按失败即关闭处理。
  // 期望会最先检查,先于重新推导,因此
  // 挽救手段绝不会绕过绑定。
  const boundRebuilt = shaclProductValidateToSarifRebuildExpecting(
    product,
    dataNt,
    wantHex,
  );
} catch (refusal) {
  console.error(refusal.dimension, refusal.message);
  refusal.free();
}
wasm 客体(guest)没有可从中推导基准的检索 IRI,因此由宿主显式提供 shapesBase;它会记录在产物中,恢复时无须该文档即可解析同样的相对引用。
shaclProductValidateToSarifRebuild 从 shaclProductValidateToSarif 恢复其备忘的那个同一携带数据集重新推导,因此在当前产物上调用它会得到逐字节相同的报告——它是通往同一产物的第二道门,绝不是第二个、有分歧的答案。shaclProductValidateToSarifRebuildExpecting 是它的绑定孪生版本,接受与 shaclProductValidateToSarifExpecting 完全相同的 expectIdentity:期望会最先检查,先于重新推导,与 shaclProductValidateToSarifExpecting 上完全一样,因此求助于前向兼容挽救手段的宿主绝不会失去绑定。
shaclProductValidateToSarifExpecting 接受 shaclProductExplain 在其 identity-digest 行上打印的 64 个十六进制数字。携带不同绑定的产物会以 dimension === "shapes-graph" 拒绝;不是摘要的选择器会以 dimension === undefined 拒绝,因为没有检查任何产物。shaclProductValidateToSarifRebuildExpecting 采用完全相同的选择器与完全相同的拒绝形式。
在 C 中
C ABI 公开了 purrdf_shapes_product_encode、purrdf_shapes_product_open、purrdf_shapes_product_admit、purrdf_shapes_product_admit_expecting、purrdf_shapes_product_rebuild、purrdf_shapes_product_rebuild_expecting 与 purrdf_shapes_product_certify,并由 purrdf_shapes_product_error_dimension 返回拒绝的稳定标签(形状文档只是未能解析时返回 NULL)。
purrdf_shapes_product_rebuild 是 purrdf_shapes_product_admit 的前向兼容孪生版本:它从产物所携带的形状数据集重新推导预备结果,而不是准入其备忘,这正是 purrdf_shapes_product_admit 的 stage-id 拒绝所指明的补救手段。purrdf_shapes_product_rebuild_expecting 是它的绑定孪生版本,接受与 purrdf_shapes_product_admit_expecting 完全相同的 expect_identity:期望会最先检查,先于重新推导,与 purrdf_shapes_product_admit_expecting 上完全一样,因此求助于前向兼容挽救手段的 C 宿主绝不会失去绑定。
purrdf_shapes_product_admit_expecting 是绑定到本意所指产物的 purrdf_shapes_product_admit:它接受 purrdf_shapes_product_open 所呈现的 identity-digest 值(以 NUL 结尾的 C 字符串),当产物携带不同的绑定时,返回 PURRDF_STATUS_SHAPES_PRODUCT_ERROR 以及维度 shapes-graph。不是 64 个十六进制数字的选择器返回 PURRDF_STATUS_INVALID_ARGUMENT,且不带维度。purrdf_shapes_product_rebuild_expecting 采用完全相同的选择器与完全相同的拒绝形式。参见 crates/rdf-capi/include/purrdf.h 与入门:C。
相关内容
- SHACL——验证器本身、其覆盖范围与报告模型。
docs/design/purrdf-prepared-products.md——设计记录:为何是准入而非解析、为何是三个扩展点、推导出的阶段身份、普查闭包(census closure),以及有界的保证。- 编解码器与确定性——每个 PurRDF 写出器(包括这一个)都遵循的逐字节确定性规则。
- 基准 IRI 与相对引用——
--base记录什么,以及产物为何拒绝猜测它。 - 性能——分解打包与恢复阶段的仅报告型基准测试。
ShEx
purrdf-shex(重新导出为 purrdf::shex)是 PurRDF 的原生 Shape Expressions Language 2.1 引擎:包含模式层与形状映射验证器,纯 Rust 实现且 wasm-clean。
模式:ShExC 与 ShExJ
- ShExC(紧凑语法,规范 §6)——一个手写的词法分析器与递归下降解析器,覆盖完整语法:指令、
start、AND/OR/NOT形状代数、节点约束与刻面表、带词干/范围/排除项的值集、具备所有基数形式的三元组表达式、$/&标签与包含、^逆向、注解以及%…{ … %}语义动作,并经由purrdf-iri依据BASE解析相对 IRI。 - ShExJ(JSON 线格式,规范附录 A)——严格且可往返(转换)的读取器与写出器,与 shexTest 的基准事实一致。
- 结构检查(规范 §5.7)——悬空引用、标签冲突、仅由引用构成的环,以及否定分层要求。
#![allow(unused)]
fn main() {
use purrdf::shex::{check_structure, parse_shexc, parse_shexj, to_shexj};

let schema = parse_shexc(
    "PREFIX ex: <http://example.org/>\n\
     PREFIX xsd: <http://www.w3.org/2001/XMLSchema#>\n\
     ex:S { ex:p xsd:integer? }",
    None,
).expect("well-formed");
check_structure(&schema).expect("well-formed");
let json = to_shexj(&schema);
let restored = parse_shexj(&json, None).expect("well-formed");
check_structure(&restored).expect("well-formed");
assert_eq!(restored, schema);
}
模式解析通过带类型的 ShexError 报告语法错误;check_structure 则报告 StructureError 违规项列表。不存在接受格式错误模式的宽松模式。
使用形状映射进行验证
验证(规范 §5.2–§5.5)是在冻结的 purrdf-core 数据集 IR 上、在驻留的 TermId 空间中进行的固定形状映射验证:由调用方提供 (node, shape) 关联,验证器为每个关联判定是否符合。它覆盖节点约束(节点类型、带词法有效性检查的数据类型、字符串/数值刻面、带词干与排除项的值集)、带 EachOf/OneOf 划分与分组基数的 EXTRA/CLOSED 三元组表达式匹配、逆向约束、基于类型指派的递归,以及一个 EXTERNAL 解析器钩子。
从 Python 调用:
from purrdf import shex

results = shex.validate(my_schema_shexc, my_data_ttl,
                        [("https://example.org/alice", "https://example.org/PersonShape")])
print(results[0]["conformant"])
带日期的 XPath 正则法则
字符串分面(facet)中的 PATTERN 运行在兼容正则表达式之上,除非调用方按名称选择一种带日期的原生 XPath 法则:xpath-2.0-2010-12-14(XPath and XQuery Functions and Operators 2.0,第二版)或 xpath-3.1-2017-03-21(Functions and Operators 3.1)。两者都接受反向引用;只有 3.1 接受非捕获组和 q 标志。
| 宿主 | 写法 |
|---|---|
| Rust | validate_with_xpath 与 validate_shape_map_with_xpath,其中 Profile 与 Limits 来自 purrdf_core::xsd_regex::xpath;XPathValidator::new(&schema) 用于对同一固定映射的重复验证 |
| CLI | shex 上的 --xpath-regex <NAME> |
| Python | shex.validate 上的 xpath_regex= |
results = shex.validate(my_schema_shexc, my_data_ttl,
                        [("https://example.org/alice", "https://example.org/PersonShape")],
                        xpath_regex="xpath-3.1-2017-03-21")
名称须精确匹配,因此 xpath-3.1 会被拒绝,并附上可接受名称的列表。未作选择时,validate、validate_with 与 validate_shape_map 完全保持兼容行为。ShExJ 按原样传递模式与标志文本。ShExC 保留其自身的具体语法转义文法,其中没有 \1,因此反向引用要用 ShExJ 书写。
所选法则未定义的模式或标志会使其分面失败,与任何无效模式一样。所选法则还在有限的资源上限下运行,其中包括 64 KiB 的模式源文本。超出任一上限会以该资源的 xpath-* 代码中止整个形状映射。否定、备选分支以及先前已判定的条目都无法把该拒绝变成不符合的条目或部分结果映射。
一致性
该引擎依据随库固化的官方 shexTest 套件把关,固定在标签 v2.1.0(vectors/shexTest/):完整的 validation/ 清单、schemas/ 中的 ShExC/ShExJ 配对与往返(转换),以及负例语法与负例结构套件。撰写时,验证清单在尝试的用例中通过 1,105/1,105,预期失败为零,特性跳过列表为空(导入与语义动作均包括在内);实时记分板见 docs/CONFORMANCE.md。
按套件惯例,所报告的一致性是逻辑层面的(通过/失败对等);结果结构的一致性在上游仍属实验性。
SHACL 还是 ShEx?
PurRDF 在同一个 IR 上原生实现了两者,因此选择权在使用者,而不在工具包:SHACL 适合约束报告(带严重级别的违规、SARIF 输出)以及 SHACL-SPARQL 这一逃生口;ShEx 适合在显式形状映射上作出类似模式的符合性判定。
蕴涵
purrdf-entail(重新导出为 purrdf::entail)是面向 PurRDF RdfDataset IR 的原生、wasm32-clean(可干净构建到该目标)的蕴涵实现。一组引擎位于同一个门面之后,每个引擎都是其对应 SPARQL 蕴涵机制(entailment regime)的合适工具——完全在驻留的 TermId 空间中把数据集闭合到其推理得出的不动点,不依赖外部推理机,不依赖异步运行时,也不做字符串往返。
接口一览
| 入口 | 蕴涵机制 | 引擎 |
|---|---|---|
materialize(ds, regime) | Simple、RDF、RDFS、OWL-RL、D | 通过原生的半朴素不动点,对该机制所声明的子句程序进行前向物化(「chase」)。返回 (closure, ReasoningReport);报告不是可选的。 |
materialize_dl_reported(...),或 materialize(ds, Materialization::OwlDirect(bgp)) | OWL-Direct | 基于 SHOIQ(D) tableau(表算法)的开放世界 OWL DL,由查询的基本图模式 bgp 引导;对于该机制,materialize 委托给它,而不是重新表述一遍。 |
materialize_rif(...) | RIF | 在已解析的 RuleSet 上进行 RIF-Core 规则蕴涵。 |
parse_rif_xml(...) / resolve_rif_imports(...) | RIF | RIF-XML 解析,导入解析由调用方持有且不涉及 I/O。 |
rules(regime) / implemented(regime) | — | 某一机制_据以定义_的规则表,以及本工作区实际触发的子集。二者之差就是可度量的差距。 |
calculus_program(regime) | — | 该机制的演算,以 DL 子句数据的形式给出——正是 materialize 所求值的那个程序,因此使用方可以重新计算其契约哈希。 |
Regime::from_iri(iri) | — | 把 sparql:entailmentRegime IRI 解析为对应的枚举值。 |
#![allow(unused)]
fn main() {
use purrdf::entail::{materialize, Completeness, Materialization};

let ds = purrdf::parse_dataset(
    b"<https://example.org/alice> <https://example.org/name> \"Alice\" .",
    "application/n-triples",
    None,
)?;
// 把冻结的数据集闭合到其 RDFS 不动点;结果是一个新的数据集,
// 以及一份说明本次运行做了什么的报告。
let (closed, report) = materialize(&ds, Materialization::Rdfs).expect("materializes");
assert_eq!(report.completeness(), Completeness::ExactWithinBoundaries);
assert!(closed.quad_count() > ds.quad_count());
Ok::<(), Box<dyn std::error::Error>>(())
}
同一个引擎,五种宿主
蕴涵并不按宿主各自重新实现。purrdf 命令行、Python、WebAssembly 与 C ABI 都经由同一个共享的字符串边界(purrdf_validate::regime)调用 Rust 引擎,各个接口都对照同一份已提交的黄金向量工件进行检查——因此一旦出现分歧,表现为某一个向量失败,而不是几个接口悄无声息地不再一致。机制的拼写(simple、rdf、rdfs、owl-rl、owl-direct、rif、d)在各处都相同。
| 宿主 | 物化 | 定义的规则表 | 已实现的规则 |
|---|---|---|---|
| Rust | materialize(&ds, Materialization::Rdfs) | rules(Regime::Rdfs) | implemented(Regime::Rdfs) |
| CLI | purrdf reason --regime rdfs、purrdf convert --entailment rdfs、purrdf query --entailment rdfs(purrdf entails 则提出以结论为导向的问题) | — | — |
| Python | purrdf.entail.materialize(dataset, "rdfs", "", imports, premise_iris)、purrdf.entail.materialize_nt(text, "rdfs", "", imports, premise_iris) | purrdf.entail.rules("rdfs") | purrdf.entail.implemented_rules("rdfs") |
| JavaScript / WebAssembly | entailMaterialize(doc, "rdfs", "", iris, docs, premiseIris) | entailRules("rdfs") | entailImplementedRules("rdfs") |
| C | purrdf_entail_materialize_to_nquads(...) | purrdf_entail_rules(...) | purrdf_entail_implemented_rules(...) |
每个宿主都能物化每一种机制;没有任何宿主拒绝其中之一。有两种机制需要的是一项「输入」,而每个宿主都为此提供了参数:CLI 上的 --rules <FILE>,Python、WebAssembly 与 C 接口上的 program 字符串,以及 Rust 中的 Materialization 值本身。rif 在这里接收一份规范性的 RIF-in-XML 规则文档;其他机制都不接收规则文档,若提供则是错误,而不是一个被丢弃的参数。owl-direct 的额外输入是一个_查询_的类表达式,因此「文档进、文档出」的调用运行的是与查询无关的增强,而查询接口(purrdf::query_with_entailment、purrdf query --entailment owl-direct)才是查询导向通道所在之处。
一条宿主相关的说明:
- WebAssembly 模块还导出
entailCheckGoldenVectors(),它在使用方实际加载的那个模块内部重放已提交的三宿主向量工件——因此无需信任本仓库的 CI,就能检查与参考实现是否一致。
换一种问法:以结论为导向的服务
物化回答的是「这个前提蕴涵什么?」。下面三个服务回答的是「这个前提是否蕴涵_那个_?」,这是另一个问题,而不是它看起来那样在推理闭包中做成员测试:结论中的空节点是必须被_映射_的存在量词,不相容的前提蕴涵一切,找不到映射并不说明任何问题,除非规则集对其所运行的前提是完备的——而且一个结论可以被蕴涵,却根本不出现在闭包中,这正是规则表之外那五种判定手段(mechanism)存在的原因(参见一致性)。
它们运行在同一个共享边界之上,覆盖全部五种宿主形态,purrdf 命令行即其中之一。scripts/check-entailment-surface.py 是把关的检查:它从 purrdf-entail 自身的公共入口推导出服务集合,并且只要其中任何一个服务无法_带着边界的完整参数列表_从每个宿主到达,检查就失败,因此一个服务或一个参数不可能只落地到四个宿主而在第五个上缺席。它还会在每次运行时对自身做变异测试——每项检查一处编辑,在内存中施加于已提交的代码树,每一处都必须使该检查失败——因为一项无法拒发绿灯的检查就不算检查。
| 宿主 | P 是否蕴涵 C? | 重新判定蕴涵证据(warrant) | 模式的确定答案(certain answers) |
|---|---|---|---|
| Rust | entails(&p, &c, Regime::OwlRl, &imports) | verify(warrant, &p, &c) | certain_answers(&p, &bgp, Regime::OwlRl, &imports) |
| CLI | purrdf entails --regime owl-rl --premise P --conclusion C | … --conclusion C --verify | … --pattern BGP |
| Python | purrdf.entail.graph_entails("owl-rl", p, c, imports, premise_iris) | purrdf.entail.verify_entailment(...) | purrdf.entail.certain_answers("owl-rl", p, bgp, imports, premise_iris) |
| JavaScript / WebAssembly | entailGraphEntails("owl-rl", p, c, iris, docs, premiseIris) | entailVerifyEntailment(...) | entailCertainAnswers(...) |
| C | purrdf_entail_graph_entails(...) | purrdf_entail_verify_entailment(...) | purrdf_entail_certain_answers(...) |
与上面的物化表相比有两点不同,二者都源于所提出的问题,而非任何宿主:
- 五种机制,而不是七种。
owl-direct由_查询_的类表达式引导,rif在_调用方_的规则文档下进行蕴涵,而「前提、结论、机制」两者都不携带。二者在每个宿主上都会被点名拒绝——绝不会在较弱的机制下作答并贴上所请求机制的标签——而二者仍然可以物化。 - 导入表在每个宿主上都是参数。 本体的导入闭包_就是_该本体,因此,若前提携带了一条调用方没有交给本次调用的
owl:imports,它就已是另一个前提。PurRDF 不获取任何内容,因此导入闭包以调用方提供的配置形式到达:一个有序的(本体 IRI, 文档)配对列表,在命令行上写作--import IRI=FILE。当某个导入指向前提文档本身时无需配对——在 CLI 上是file://获取 IRI 或--base,在 Python、WebAssembly 与 C 宿主上是premise_iris参数(JavaScript 中为premiseIris),即调用方读取前提所用的 IRI,裸文本则为[]——指向前提中已有的图(<X> a owl:Ontology、<X> a sh:ShapesGraph,或某个owl:versionIRI指名它)时,同样无需配对。其他任何未解析的导入都会以点名该文档的方式被拒绝,绝不会成为一个被静默截断的前提;前提的闭包从未到达的导入表条目同样会被拒绝——它会被读取,却从未被使用——在每个宿主上都是如此,正如 SHACL 验证会拒绝未被使用的形状图条目。其他每一个蕴涵服务都接受同一张表并施加同一条规则:物化(CLIreason、convert --entailment;Pythonmaterialize/materialize_nt;WebAssemblyentailMaterialize;Cpurrdf_entail_materialize_to_nquads;Rustmaterialize_with_imports)、蕴涵机制查询(CLIquery --entailment … --import IRI=FILE;PythonStore.query_entailment_governed(..., imports=…, premise_iris=…);WebAssemblyqueryEntailmentGoverned的importIris/importDocuments/premiseIris选项;Cpurrdf_query_entailment_governed的import_iris/import_documents/import_count;Rustquery_with_entailment_closure_governed),以及 OWL-Direct 相容性问题(CLIconsistency --import IRI=FILE;Pythonconsistency(data, imports, premise_iris);WebAssemblyentailConsistency(doc, iris, docs, premiseIris, …);Cpurrdf_entail_consistency)。每一个服务都对合并后的前提求闭包或作出判定,在其报告或证书中声明ontology-import-resolved,并完全像reason那样拒绝未解析的导入或未被到达的条目。不接受导入表的 Rust 入口点(query_with_entailment、query_with_entailment_governed)以空表进行解析,因此导入了自身不持有的文档的前提在那里同样会被拒绝,绝不会在缺少该文档的情况下求闭包。所读取的owl:imports与 SHACL 验证所读取的相同:位于前提自身的 IRI 上、owl:Ontology头上、sh:ShapesGraph(包括sh:RulesGraph及其子类)上,或以其中之一作为其owl:versionIRI的节点上。任何其他节点上的owl:imports(包括仅为sh:DataGraph的节点)都是普通的前提三元组。
模式是在任意位置(包括谓词位置)带有 ?name(或 $name)的 N-Triples。RDF 把该位置保留给 IRI,因此边界的做法是:把每个变量改写为取自某个命名空间的项(该命名空间由边界扫描调用方自己的文本后划出),之后再把每次出现映射回来;该命名空间的任何内容都不会出现在结果行、绑定或报告中。唯一不接受变量的位置是字面量的数据类型:"5"^^?d 要求在一个存放 IRI 而非项的位置上进行绑定,它会被点名拒绝——替身绝不能留在那里,否则它匹配的是边界自己的命名空间,而不是调用方的数据。谓词变量与其他变量一样被投影;在 owl-rl 下,它还会产生一个 limit:它的取值范围是整个谓词词汇表,因此也涵盖 schema 谓词,而规则表的完备性所依据的定理并不覆盖这些谓词。该定理是 OWL 2 Profiles §4.3 中的定理 PR1,其假设分为两半:前提处于 OWL 2 RL 语法之内,且结论是_断言型_的——即基于类名的类断言、属性断言,以及基于具名个体的 owl:sameAs 与 owl:differentFrom。只有两半同时成立时规则表才是完备的,因此对于 schema 结论,无论 scm-* 是否推出了它,规则表都不声称完备。谓词变量还涵盖由规则表之外的判定手段所判定的构造,而结果行所取自的推理闭包对这些构造不含任何内容。
每个答案都附带其背后那次运行的证书——与物化所输出的相同的 purrdf-reasoning-report 块,外加一行 mechanism,指明是六种判定手段中的哪一种得出了裁决。
规则覆盖
rules(regime) 是规范用来定义该机制的规则表;implemented(regime) 是求值器实际触发的子集。二者都是按规范表格顺序排列的 &'static 切片,因此差距是一个可执行的工件,而不是一句话:
| 机制 | 规则表 | 定义数 | 已实现 |
|---|---|---|---|
Simple | —(恒等闭包) | 0 | 0 |
RDF | RDF 1.2 Semantics §8.1.1 | 3 | 3 |
RDFS | RDF 1.2 Semantics §8.1.1 + §9.2.1 | 18 | 18 |
OWL-RL | OWL 2 Profiles §4.3 表 4–9 | 78 | 78 |
D | OWL 2 Profiles §4.3 表 8 | 5 | 5 |
OWL-Direct | —(SHOIQ(D) tableau,而非固定的表) | 0 | 0 |
RIF | —(调用方提供的规则集) | 0 | 0 |
逐条规则的明细——每个规则 id、其规范出处,以及是否触发——是由该 API 生成的,并受漂移防护,因此不会落后于代码。
数字止步之处:
- 四条存在性规则会触发,但其结论被扣留。
rdfD1、rdfD1a、rdfs14与rdfs14a各自得出关于一个_新_空节点的结论。受限 chase 为每个这样的空节点生成一个以前沿为地址的 Skolem 见证,并在其上求闭包,因此这些规则确实会触发——但在把闭包物化回来时,每个提及替代项(surrogate)的结论都会被丢弃,因为 SPARQL 蕴涵机制从作用域图(scoping graph)中取答案,而替代项不在其中。这种扣留以Construct::Surrogate报告。不含替代项的内容不会丢失:把一个项替换为新的空节点只会削弱一个三元组。 - 完整的规则表并不等于完整的推理闭包。
OWL-RL触发全部 78 条规则,而一次遇到边界的运行仍然报告Completeness::ExactWithinBoundaries,而不是Exact。这两项声明是有意分开报告的。完整的规则表也不等于蕴涵一致性:在本仓库随库固化的 W3C OWL 2 RL 蕴涵测试语料上,entails()到达了已发布的 27 个正向蕴涵中的 27 个,并在 23 个负向蕴涵中的 23 个上与 W3C 一致——这 23 个中有 3 个被_驳倒_(判定为非蕴涵),20 个被_接纳_(计算出推理闭包并观察到其中不含该非结论)。23 of 23应读作「未发现不可靠性」,绝不能读作「证明了 23 个非蕴涵」(参见下文一致性)。78 / 78 表示表 4–9 中的每条规则都已实现——而 W3C 发布的蕴涵中唯一一个只能由这些表之外的某条可靠规则到达的,是由一个扩展ext-eq-diff-sym到达的:extensions(Regime::OwlRl)列出了它,rules()与implemented()都不列出它,每份报告都在单独的extension行中输出它。另有八个是通过反驳而非匹配到达的,这些根本不增加任何规则:参见下文的一致性一节。 - 有十七条 OWL 2 RL 规则的结论是
false。 对这些规则而言,「已实现」意味着_已判定_:规则体一旦匹配,就成为EntailError::Inconsistent,并携带一个见证,指明该规则以及满足它的那些断言三元组。对一条没有结论的规则而言,这是它唯一能做的事。
chase(Simple / RDF / RDFS / OWL-RL / D)
materialize 运行一次前向物化 chase:为所选机制准备一个固定规则集,以半朴素不动点方式施加,直到不再出现新的四元组为止。由于它运行在冻结的 IR 上,它是确定性的——给定的输入与机制总是得出相同的推理闭包——又由于它在 TermId 空间中工作,途中没有任何项会被重新解析或重新序列化。
典型用法:先物化,然后用普通的 SPARQL 引擎查询,或用 SHACL 验证推理闭包(SHACL 验证器本身不做任何推理)。
规则集不会被写两遍。calculus_program(regime) 把它输出为 DL 子句,而 materialize 正是通过 purrdf-datalog 的半朴素求值器对这些子句求值,因此报告所携带的契约哈希标识的就是实际运行的子句。
RDF、RDFS、OWL-RL 与 D 通道在 purrdf-datalog 的求值上限下运行:每个图的存储可持有的事实,以及其规则可枚举的候选解。默认值在原生环境下为 4,194,304 条事实与 1,048,576 个连接步,在 WebAssembly 中为 131,072 与 1,048,576。需要其他上限的调用方需声明它们——Rust 中为 materialize_with(ds, plan, &options, stop),purrdf reason 与 purrdf convert --entailment 上为 --max-stored-facts 与 --max-join-steps,Python 的 materialize 与 materialize_nt 上为 max_stored_facts= 与 max_join_steps=,entailMaterialize 上为 maxStoredFacts 与 maxJoinSteps,purrdf_entail_materialize_to_nquads 上为 max_stored_facts 与 max_join_steps。越过上限的运行会被拒绝,并点名该上限、相关数值以及该宿主上的参数;在上限之内的运行返回的推理闭包,与任何更大上限下的完全相同,其报告的契约哈希指名的是所生效上限下的演算。
其他每一个对某个蕴涵机制的规则表求值的服务,都接受同样的两个上限,并点名调用方所调用的那个入口点上的参数——绝不会向无从触及 Rust 类型的调用方点名一个 Rust 类型。以结论为导向的服务用它们约束前提的推理闭包,以及反驳与冻结机制的每一次重新 chase:Rust 中为 entails_with 与 certain_answers_with(字符串边界上为 MaterializeLimits),purrdf entails 上为 --max-stored-facts 与 --max-join-steps,Python 的 certain_answers、graph_entails 与 verify_entailment 上为仅限关键字的 max_stored_facts= 与 max_join_steps=,entailCertainAnswers、entailGraphEntails 与 entailVerifyEntailment 上为末尾的 maxStoredFacts 与 maxJoinSteps,三个 C 入口点上则为位于 premise_iri_count 之后的 max_stored_facts 与 max_join_steps。蕴涵机制查询用它们约束自身的推理闭包:Rust 中为 EntailmentClosure::with_limits,purrdf query --entailment 旁为 --max-stored-facts 与 --max-join-steps,Store.query_entailment_governed 上为 max_stored_facts= 与 max_join_steps=,queryEntailmentGoverned 上为 maxStoredFacts 与 maxJoinSteps 选项,purrdf_query_entailment_governed 上则为这两个参数;查询 governor 仍然只为在推理闭包上的求值计价。OWL-Direct 相容性问题不运行任何规则表:其求值器是 hypertableau,在每个宿主上都受 step_cap 与 work_cap 约束,因此它不接受任何存储事实或连接步参数——那样的参数什么也约束不了。
每次运行都说明它做了什么
materialize 返回 (closure, ReasoningReport)。刻意不提供不带报告的变体,因为另一种做法——两个入口,其中一个丢弃证据——正是部分规则集被描述成完整规则集的由来。报告包含:
Completeness——由rules(regime)减去implemented(regime)得出,因此随着规则的加入会自行改善,并且它点名列出missing规则,而不只是计数;- 逐规则触发计数——哪些规则触发了,各自贡献了多少结论;
Boundary——本次运行遇到且无法闭合的构造,各附原因;- 求值预算——本次运行在其所处的求值上限下消耗了多少;
- 契约哈希——
purrdf-datalog对子句程序及所生效求值上限的摘要,因此在另一种演算下、或在不同上限下生成的缓存推理闭包可以被_拒绝_,而不是被信任; - 不相容见证,当一条结论为
false的规则匹配时给出:规则 id、按前提顺序满足其前提的断言三元组,以及它们所取自的图。
报告不可能在列出边界的同时声称 Exact。ReasoningReport 根本不存储完备性字段:completeness() 从边界列表本身推导出该值,因此矛盾的状态不可表示,而不只是被检查。这是有意为之——早先的设计存储了该字段,并把它与对同一组输入的推导结果相比较,这在构造上就是空洞的,永远不可能失败。
输出是字节稳定的,因此对于相同输入,Python、WebAssembly 与 C 宿主返回的报告文本与 Rust 相同。
OWL-Direct:tableau
OWL-Direct 语义是开放世界的描述逻辑,前向 chase 无法回答。materialize_dl_reported 改为运行一个 SHOIQ(D) tableau(表算法)——通过分类、实现(realization)与查询导向的物化来回答实例查询与包含(subsumption)查询。由于它需要查询的类表达式,它把这些表达式作为自己的 query_bgp 参数接收;materialize 对 Materialization::OwlDirect 委托给它,从而到达同一个 tableau,而不是重新表述它。
RIF
materialize_rif 在已解析的 RuleSet 上求值 RIF-Core 规则,覆盖 SPARQL RIF 蕴涵机制。
D(数据类型)蕴涵
D 会被物化,而不是被拒绝。PurRDF 把它实现为 Simple 蕴涵加上 OWL 2 Profiles §4.3 表 8 中的五条 dt-* 规则——即前向 chase 能为其枚举的固定规则表——由 purrdf-xsd 在 XSD _值_空间上判定,而不是通过比较词法形式。
表 8 未覆盖的是无限的值空间本身,这一点作为本次运行的 Construct::DatatypeValueSpace 边界被报告,而不是被声称已覆盖。因此 D 推理闭包是_在其所陈述的边界之内_完备的,而报告正是陈述该边界的地方。
每个宿主都能物化 d,命令行工具也不例外。
不存在「不支持的机制」错误。materialize 接收一个 Materialization,它携带每种机制各自的输入——OWL-Direct 是一个基本图模式,RIF 是一个 RuleSet——因此该类型的七个变体分别交给对应引擎处理。无效输入、不相容及资源上限耗尽会返回带类型的错误。Regime 仍然是报告与标识所用的类型,ReasoningReport::regime()、rules()、implemented() 与 Regime::from_iri 都以它表述。
不变量
- 不生成任何词汇。 该 crate 的
vocab模块中的每个常量都是取自蕴涵规范本身的标准rdf:/rdfs:/owl:IRI——按照工具包而非本体的规则,该 crate 不编造任何词汇。 - 依赖精简且 wasm-clean。 依赖项为
purrdf-core、purrdf-datalog、purrdf-xsd、purrdf-lex、purrdf-iri、purrdf-hash,以及以purrdf-core的固定密钥哈希器为键计算哈希值的hashbrown原始哈希表——每一个都是wasm32-unknown-unknown-clean(可干净构建到该目标),因此这些引擎可以原样带入 Rust、Python、WebAssembly 与 C,不依赖线程、文件系统或 RNG。 - 确定性。 相同的输入 + 机制 → 相同的推理闭包,始终如此——报告也逐字节相同。
一致性
两份语料度量的是两件不同的事,这一区别很重要:
-
W3C SPARQL 1.1 蕴涵机制测试组——70 个用例中 70 个通过,台账中残余为零:RDF/RDFS/OWL-RL chase、OWL-Direct(DL)tableau、RIF-Core 规则引擎,以及 RDF 公理性的谓词类型推定,全部经由 SPARQL 一致性测试框架运行。
-
W3C OWL 2 测试套件——262 个用例中 262 个裁决一致,0 例入台账,未入台账者为零。这份语料是_相容性_(consistency)形态的:全部 262 个随库固化的用例都是
otest:ConsistencyTest(226 个)或otest:InconsistencyTest(36 个)。因此它评判的是 DL/tableau 通道的可满足性裁决,对 OWL 2 RL 规则表则什么也没有说明。带类型的台账包含 0 个分歧。每一个分歧和每一条过时的台账条目仍会导致硬失败。这一行没有说明的有两点。第一,上游材料并非不含蕴涵测试——W3C 清单中有 206 个正向与 23 个负向蕴涵测试;这份语料缺少它们,是因为它所取自的扁平化版本提取了前提字面量而丢弃了结论字面量,而后者恰恰是蕴涵评分所需的那一半。它们已随库固化,并由下一条目评分。第二,这份语料是一个子集:上游 482 个相容性形态用例中的 262 个。在它排除的 220 个中,有 172 个在测量排除情况时被 tableau 判定(108 个相容,64 个不相容),0 个在 40 s 上限内未终止,25 个被扣留(20 个因推理机,5 个因解析),23 个不带 RDF/XML 前提——因此这种排除是对载荷的分拣,而非能力限制,而「262 个中 262 个」是基于一份语料的数字,而不是基于 W3C 所发布内容的数字。
这五个数字是一次注明日期的测量,记录在
census.tsv的dl_probe列中,并在该套件的PROVENANCE.md中说明。测试框架读取该列,并在每次运行时打印出来;它并不会对被排除的 220 个用例重新运行推理机,因此这一行无法发现其中的回归。重新推导这些数字意味着重新运行探测,这是一项有意的操作,而不是把关检查的一部分。 -
W3C OWL 2 RL 蕴涵测试——50 个用例中 50 个一致,0 例入台账,未入台账者为零。这是规则表的独立判定依据(oracle):W3C 自己的蕴涵测试,每个用例在
Regime::OwlRl下调用一次purrdf_entail::entails()作答。两个通道证明的是不同的事,分开报告。负向通道为 23 个中 23 个:无不可靠性。 chase 从未推出任何 W3C 公布为_不_被蕴涵的三元组。这是安全性结果,它在_全部_ 23 个负向用例上都成立——可靠性是每个用例都必须满足的,因此没有按 profile 过滤任何用例。
这 23 次一致是两种不同的结果,测试框架会打印其划分,单独占一行记分板:
OWL2-RL-NEGATIVE: total 23 = refuted 3 + admitted 20 (premise-outside-rl 5, conclusion-outside-rl 10, construct-not-read 5, refutation-budget 0, freeze-budget 0, data-range-containment 0) + unsound 0 + withheld 0其中三个是_已判定_的非蕴涵——定理 PR1 假设的两半都成立,因此推理闭包不含该非结论即构成证明。其余 20 个是_接纳_:推理闭包已计算,且不含该非结论,这就是可靠性观察的全部,除此之外不作任何声明。两者都一致,而且理应如此;它们的区别在于鉴别力,因为一个什么也推不出的推理机同样会得到
negative 23 of 23,只是refuted 0。23 of 23应读作「未发现不可靠性」,绝不能读作「证明了 23 个非蕴涵」。正向通道为 27 个中 27 个——W3C 自己在基于 RDF 的语义下归入 RL profile 的 27 个正向蕴涵——而带类型的分歧台账
purrdf_sparql_conformance::owl2_rl::LEDGER为空(EMPTY)——schema-conclusion为 0,negative-conclusion为 0,construct-outside-rl为 0,imports-unresolved为 0,且需要采取行动的项为 0(missing-rule为 0)。它过去包含的每一类都已关闭,而为了关闭其中任何一类,规则表一次也没有改变。
entails()以六种方式得出结论,其中五种不是匹配:- 反驳。 表 4–9 中仍然没有任何规则以否定事实为规则头——没有规则得出
owl:differentFrom,也没有规则得出属于某个owl:complementOf类的成员关系。该表_确实_拥有的是十七条结论为false的规则,这十七条构成一套不相容性演算:把结论的否定断言到前提中,在一个其相容性已由第一次运行确立的前提上重新运行同样的七十八条规则,并把由此得到的不相容读作证明。按 OWL 2 自身的定义,一个owl:AllDifferent集合是其n(n−1)/2个两两不等式的合取,因此它降为同样的形态,并且恰好在每一对都被驳倒时才被蕴涵——这就是为什么有两个条目随之离开了schema-conclusion类。 - 冻结后 chase。
p rdf:type owl:TransitiveProperty是一个全称量化的 Horn 蕴含式的缩写,而蕴含式通过对常量的概括来判定:在前提未提及的常量上冻结其规则体,重新运行规则表,并查找规则头。chain2trans1的规则头经由prp-spo2(78 条之一)得出。该公理的另一个合取项——p是对象属性——是在前提自身的推理闭包中的一次查找,而且这一步不可省略:模式公理是一个合取式,只确立其中有意思的那一半,就会声称该语义并不许可的结论。 - 概括(comprehension)。 结论可以断言某个「类存在」——一个匿名的
owl:unionOf、一个匿名的owl:Restriction——这由基于 RDF 的语义自身的概括条件所许可,但须满足一个关于运算对象的类型附加条件。只生成结论所点名的那些脚手架,且所用的空节点已检查在两份文档中都不存在。 - 自反性。
owl:ReflexiveProperty在 RL 语法之外,因此该 profile 没有为它给出规则——而如果有这样一条规则,它的取值范围将是每一个资源,从而扩大每个使用方默认都会计算的推理闭包。结论自身的自环改为从前提的自反类型声明中读出。 - 数据类型包含。 一个属性所声明的各个
rdfs:range数据类型会取交集,而该交集可能包含于前提从未提及的某个数据类型——xsd:byte ⊑ xsd:short,以及short ⊓ unsignedInt ⊑ unsignedShort,这两者都无法通过对三元组做连接来发现。在 XSD 值空间上判定,采用三值逻辑,否定答案只有在反例范围被精确判定时才会给出。 最后一个用例根本不需要任何判定手段,只需要其前提所点名的那份文档:webont-imports-011通过owl:imports导入了一个上游清单未内联的支持本体,因此它从 W3C 自己的 URL 获取后随库固化在这些用例旁边,并作为调用方持有的配置提供给entails()。该库仍然不获取任何内容。
清单本身没有任何变动:
rules(Regime::OwlRl)与implemented(Regime::OwlRl)仍然恰好是同样的 78 条,extensions(Regime::OwlRl)仍然只有那一条ext-eq-diff-sym,严格的Materialization::OwlRl输出也与原来逐字节相同。变动的是证据——每种判定手段都带有自己的EntailmentWarrant分支,携带它实际使用的内容(触发的那条以false为结论的规则,以及一个能蕴涵该结论的最小前提子集;被冻结的常量、规则体与规则头;生成的三元组以及许可它们的推理闭包三元组),以及它自己的检查器,无需运行推理机即可重新判定全部内容。过去唯一一个需要采取行动(actionable)的用例由一个扩展关闭,而这个扩展是被标注出来的,而不是被吸收进去的。
a owl:differentFrom b蕴涵b owl:differentFrom a,这是可靠的——owl:differentFrom表示不等,而不等是对称的——其形态与prp-symp完全相同,却不在那 78 条规则之中,因为表 4 中关于owl:differentFrom的规则只会得出false。PurRDF 把它表述为ext-eq-diff-sym,置于一个被声明为位于每张规范表格_之外_的规则族中:extensions(Regime::OwlRl)返回它,rules()与implemented()仍然恰好是同样的 78 条且都不返回它,RuleId::is_extension决定哪条属于哪类,而每份输出的报告都在其missing行旁边带有一行extension ext-eq-diff-sym。因此调用方得到的推理闭包是表 4–9 再加上一份它可以阅读并拒绝的清单,而OWL-RL 78 / 78仍然只是关于表 4–9 的声明,别无其他。 - 反驳。 表 4–9 中仍然没有任何规则以否定事实为规则头——没有规则得出
实时记分板见 docs/CONFORMANCE.md。
蕴涵规则清单
本文件是生成的,请勿手工编辑。 它由 cargo run -p purrdf-entail --example gen_rule_inventory 依据 purrdf_entail::RuleId、rules(regime) 与 implemented(regime) 输出;当提交的副本与一次新运行的结果不一致时,scripts/check-generated.sh 会使构建失败。用 make metadata 重新生成。
**Defined(已定义)**是规范据以定义该蕴涵机制(entailment regime)的规则表(rules(regime))。**Implemented(已实现)**是本工作区的求值器实际触发的子集(implemented(regime))。两者之差就是该蕴涵机制的缺口,也正是 ReasoningReport 在 missing 下列出的集合。
两列都不计入扩展——即本工作区会触发、但任何规范表都未陈述的规则。扩展单独列在下文它们自己的一节中(extensions(regime)),绝不并入覆盖率数字,因此像 OWL-RL 78 / 78 这样的数字始终只是关于 OWL 2 Profiles §4.3 表 4–9 的陈述,不涉及其他任何内容。
78 / 78 与 50 / 50 是两种不同的度量
本页是规则清单:78 / 78 表示 OWL 2 Profiles §4.3 表 4–9 陈述的每条规则都是 chase 会触发的规则。它并不说明由此能到达多少已发布的蕴涵;这两个数字针对不同的对象度量,可以各自独立变化。
第二种度量是蕴涵一致性,针对随库固化的 W3C OWL 2 RL 蕴涵语料:50 个用例中有 50 个与 W3C 发布的裁决一致,其中正例 27/27、负例 23/23,分歧台账为空。这个数字属于 crates/sparql-conformance/entailment-suite/w3c-owl2-rl/,以该处随库固化的内容为界——参见 docs/CONFORMANCE.md,它把该数字与其所度量的语料并列给出。
这 50 个中有 15 个,是通过某种判定手段到达的;这些判定手段之所以存在,是因为规则表无法判定任何该形态的结论:反驳、冻结后 chase、概括(comprehension)、自反性以及数据类型包含,每一种都在 purrdf_entail::EntailmentMechanism 上有文档说明。它们都不增加规则,这就是本清单与它们出现之前逐字节相同的原因——它们改变的是规则表被运行多少次以及其 false 被如何解读,而不是规则表陈述了什么。
这五种机制可以组合。结论图是一个合取式,而蕴涵在合取式上是单调的,因此一个在模式公理旁陈述否定事实的结论,当其每一半都被蕴涵时即被蕴涵:purrdf_entail::entails() 依次让残余部分穿过每一条通道,只匹配幸存下来的部分;需要其中两种或更多机制才能得到的答案,渲染为 composite,而不是任何单一组成机制的名称。没有任何随库固化的用例需要它——50 个用例中的每一个都由一条通道到达,或者无一到达——因此语料并不度量它,而由该 crate 自身的测试来度量。
按蕴涵机制的覆盖情况
| 机制 | --regime | 定义数 | 已实现 |
|---|---|---|---|
| Simple | simple | 0 | 0 |
| RDF | rdf | 3 | 3 |
| RDFS | rdfs | 18 | 18 |
| OWL-RL | owl-rl | 78 | 78 |
| OWL-Direct | owl-direct | 0 | 0 |
| RIF | rif | 0 | 0 |
| D | d | 5 | 5 |
规则表长度为零的蕴涵机制,是本 crate 不为其枚举规则的机制:Simple 是恒等闭包,而 OWL-Direct 与 RIF 分别由 tableau 与调用方提供的规则集提供服务,两者都不是固定的表。
扩展
本工作区的求值器会触发、但任何规范表都未陈述的规则。对任何蕴涵机制,扩展都不出现在上面的任一列中:rules(regime) 与 implemented(regime) 只指名规范规则,extensions(regime) 只指名这些扩展规则。RuleId::is_extension 决定哪条属于哪一类,ReasoningReport 则在 missing 列表旁的 extension 下渲染该列表——因此,只能依据规范性结论行事的调用方可以从报告中判断,而不必依赖文字说明。
每个条目在其所读取词汇的语义下都是可靠的;对于一条没有规范可依的规则,这是它唯一能达到的标准。
| 机制 | --regime | 规则 |
|---|---|---|
| OWL-RL | owl-rl | ext-eq-diff-sym |
RDF——3 条规则中已实现 3 条
| 规则 | 规范 | 已实现 |
|---|---|---|
rdfD1 | RDF 1.2 Semantics §8.1.1(RDF patterns) | 是 |
rdfD1a | RDF 1.2 Semantics §8.1.1(RDF patterns) | 是 |
rdfD2 | RDF 1.2 Semantics §8.1.1(RDF patterns) | 是 |
RDFS——18 条规则中已实现 18 条
| 规则 | 规范 | 已实现 |
|---|---|---|
rdfD1 | RDF 1.2 Semantics §8.1.1(RDF patterns) | 是 |
rdfD1a | RDF 1.2 Semantics §8.1.1(RDF patterns) | 是 |
rdfD2 | RDF 1.2 Semantics §8.1.1(RDF patterns) | 是 |
rdfs1 | RDF 1.2 Semantics §9.2.1(RDFS patterns) | 是 |
rdfs2 | RDF 1.2 Semantics §9.2.1(RDFS patterns) | 是 |
rdfs3 | RDF 1.2 Semantics §9.2.1(RDFS patterns) | 是 |
rdfs4 | RDF 1.2 Semantics §9.2.1(RDFS patterns) | 是 |
rdfs5 | RDF 1.2 Semantics §9.2.1(RDFS patterns) | 是 |
rdfs6 | RDF 1.2 Semantics §9.2.1(RDFS patterns) | 是 |
rdfs7 | RDF 1.2 Semantics §9.2.1(RDFS patterns) | 是 |
rdfs8 | RDF 1.2 Semantics §9.2.1(RDFS patterns) | 是 |
rdfs9 | RDF 1.2 Semantics §9.2.1(RDFS patterns) | 是 |
rdfs10 | RDF 1.2 Semantics §9.2.1(RDFS patterns) | 是 |
rdfs11 | RDF 1.2 Semantics §9.2.1(RDFS patterns) | 是 |
rdfs12 | RDF 1.2 Semantics §9.2.1(RDFS patterns) | 是 |
rdfs13 | RDF 1.2 Semantics §9.2.1(RDFS patterns) | 是 |
rdfs14 | RDF 1.2 Semantics §9.2.1(RDFS patterns) | 是 |
rdfs14a | RDF 1.2 Semantics §9.2.1(RDFS patterns) | 是 |
OWL-RL——78 条规则中已实现 78 条
| 规则 | 规范 | 已实现 |
|---|---|---|
eq-ref | OWL 2 Profiles §4.3 表 4(相等性) | 是 |
eq-sym | OWL 2 Profiles §4.3 表 4(相等性) | 是 |
eq-trans | OWL 2 Profiles §4.3 表 4(相等性) | 是 |
eq-rep-s | OWL 2 Profiles §4.3 表 4(相等性) | 是 |
eq-rep-p | OWL 2 Profiles §4.3 表 4(相等性) | 是 |
eq-rep-o | OWL 2 Profiles §4.3 表 4(相等性) | 是 |
eq-diff1 | OWL 2 Profiles §4.3 表 4(相等性) | 是 |
eq-diff2 | OWL 2 Profiles §4.3 表 4(相等性) | 是 |
eq-diff3 | OWL 2 Profiles §4.3 表 4(相等性) | 是 |
prp-ap | OWL 2 Profiles §4.3 表 5(属性公理) | 是 |
prp-dom | OWL 2 Profiles §4.3 表 5(属性公理) | 是 |
prp-rng | OWL 2 Profiles §4.3 表 5(属性公理) | 是 |
prp-fp | OWL 2 Profiles §4.3 表 5(属性公理) | 是 |
prp-ifp | OWL 2 Profiles §4.3 表 5(属性公理) | 是 |
prp-irp | OWL 2 Profiles §4.3 表 5(属性公理) | 是 |
prp-symp | OWL 2 Profiles §4.3 表 5(属性公理) | 是 |
prp-asyp | OWL 2 Profiles §4.3 表 5(属性公理) | 是 |
prp-trp | OWL 2 Profiles §4.3 表 5(属性公理) | 是 |
prp-spo1 | OWL 2 Profiles §4.3 表 5(属性公理) | 是 |
prp-spo2 | OWL 2 Profiles §4.3 表 5(属性公理) | 是 |
prp-eqp1 | OWL 2 Profiles §4.3 表 5(属性公理) | 是 |
prp-eqp2 | OWL 2 Profiles §4.3 表 5(属性公理) | 是 |
prp-pdw | OWL 2 Profiles §4.3 表 5(属性公理) | 是 |
prp-adp | OWL 2 Profiles §4.3 表 5(属性公理) | 是 |
prp-inv1 | OWL 2 Profiles §4.3 表 5(属性公理) | 是 |
prp-inv2 | OWL 2 Profiles §4.3 表 5(属性公理) | 是 |
prp-key | OWL 2 Profiles §4.3 表 5(属性公理) | 是 |
prp-npa1 | OWL 2 Profiles §4.3 表 5(属性公理) | 是 |
prp-npa2 | OWL 2 Profiles §4.3 表 5(属性公理) | 是 |
cls-thing | OWL 2 Profiles §4.3 表 6(类) | 是 |
cls-nothing1 | OWL 2 Profiles §4.3 表 6(类) | 是 |
cls-nothing2 | OWL 2 Profiles §4.3 表 6(类) | 是 |
cls-int1 | OWL 2 Profiles §4.3 表 6(类) | 是 |
cls-int2 | OWL 2 Profiles §4.3 表 6(类) | 是 |
cls-uni | OWL 2 Profiles §4.3 表 6(类) | 是 |
cls-com | OWL 2 Profiles §4.3 表 6(类) | 是 |
cls-svf1 | OWL 2 Profiles §4.3 表 6(类) | 是 |
cls-svf2 | OWL 2 Profiles §4.3 表 6(类) | 是 |
cls-avf | OWL 2 Profiles §4.3 表 6(类) | 是 |
cls-hv1 | OWL 2 Profiles §4.3 表 6(类) | 是 |
cls-hv2 | OWL 2 Profiles §4.3 表 6(类) | 是 |
cls-maxc1 | OWL 2 Profiles §4.3 表 6(类) | 是 |
cls-maxc2 | OWL 2 Profiles §4.3 表 6(类) | 是 |
cls-maxqc1 | OWL 2 Profiles §4.3 表 6(类) | 是 |
cls-maxqc2 | OWL 2 Profiles §4.3 表 6(类) | 是 |
cls-maxqc3 | OWL 2 Profiles §4.3 表 6(类) | 是 |
cls-maxqc4 | OWL 2 Profiles §4.3 表 6(类) | 是 |
cls-oo | OWL 2 Profiles §4.3 表 6(类) | 是 |
cax-sco | OWL 2 Profiles §4.3 表 7(类公理) | 是 |
cax-eqc1 | OWL 2 Profiles §4.3 表 7(类公理) | 是 |
cax-eqc2 | OWL 2 Profiles §4.3 表 7(类公理) | 是 |
cax-dw | OWL 2 Profiles §4.3 表 7(类公理) | 是 |
cax-adc | OWL 2 Profiles §4.3 表 7(类公理) | 是 |
dt-type1 | OWL 2 Profiles §4.3 表 8(数据类型) | 是 |
dt-type2 | OWL 2 Profiles §4.3 表 8(数据类型) | 是 |
dt-eq | OWL 2 Profiles §4.3 表 8(数据类型) | 是 |
dt-diff | OWL 2 Profiles §4.3 表 8(数据类型) | 是 |
dt-not-type | OWL 2 Profiles §4.3 表 8(数据类型) | 是 |
scm-cls | OWL 2 Profiles §4.3 表 9(模式词汇) | 是 |
scm-sco | OWL 2 Profiles §4.3 表 9(模式词汇) | 是 |
scm-eqc1 | OWL 2 Profiles §4.3 表 9(模式词汇) | 是 |
scm-eqc2 | OWL 2 Profiles §4.3 表 9(模式词汇) | 是 |
scm-op | OWL 2 Profiles §4.3 表 9(模式词汇) | 是 |
scm-dp | OWL 2 Profiles §4.3 表 9(模式词汇) | 是 |
scm-spo | OWL 2 Profiles §4.3 表 9(模式词汇) | 是 |
scm-eqp1 | OWL 2 Profiles §4.3 表 9(模式词汇) | 是 |
scm-eqp2 | OWL 2 Profiles §4.3 表 9(模式词汇) | 是 |
scm-dom1 | OWL 2 Profiles §4.3 表 9(模式词汇) | 是 |
scm-dom2 | OWL 2 Profiles §4.3 表 9(模式词汇) | 是 |
scm-rng1 | OWL 2 Profiles §4.3 表 9(模式词汇) | 是 |
scm-rng2 | OWL 2 Profiles §4.3 表 9(模式词汇) | 是 |
scm-hv | OWL 2 Profiles §4.3 表 9(模式词汇) | 是 |
scm-svf1 | OWL 2 Profiles §4.3 表 9(模式词汇) | 是 |
scm-svf2 | OWL 2 Profiles §4.3 表 9(模式词汇) | 是 |
scm-avf1 | OWL 2 Profiles §4.3 表 9(模式词汇) | 是 |
scm-avf2 | OWL 2 Profiles §4.3 表 9(模式词汇) | 是 |
scm-int | OWL 2 Profiles §4.3 表 9(模式词汇) | 是 |
scm-uni | OWL 2 Profiles §4.3 表 9(模式词汇) | 是 |
D——5 条规则中已实现 5 条
| 规则 | 规范 | 已实现 |
|---|---|---|
dt-type1 | OWL 2 Profiles §4.3 表 8(数据类型) | 是 |
dt-type2 | OWL 2 Profiles §4.3 表 8(数据类型) | 是 |
dt-eq | OWL 2 Profiles §4.3 表 8(数据类型) | 是 |
dt-diff | OWL 2 Profiles §4.3 表 8(数据类型) | 是 |
dt-not-type | OWL 2 Profiles §4.3 表 8(数据类型) | 是 |
Datalog:不动点引擎
purrdf-datalog 是确定性的、wasm32-clean 的 Datalog 求值:一个列式关系存储、一个会选择索引的规划器,以及一个半朴素不动点,不带任何环境 I/O、挂钟时间或随机数生成器。
它的存在使规则集成为_数据_,而不是手写的循环。purrdf-entail 把 RDF、RDFS、OWL 2 RL 与 D 演算声明为 DL 子句程序并在此求值,正因如此,推理报告才能携带实际运行的那个确切程序的契约哈希,而不是一句关于本应运行哪些规则的声明。
purrdf-datalog 由总括 crate purrdf 重新导出为 purrdf::datalog 模块——蕴涵接口携带它的类型(ReasoningReport 会交出一个 datalog::cache::ContractHash 与一个 datalog::seminaive::BudgetReport),因此对这些类型做匹配的使用方不需要再额外依赖 purrdf-datalog。只有当只需要不动点本身、构建中不含其他任何 purrdf 接口时,才直接依赖该 crate(purrdf-datalog = "…")。
唯一的规则 IR:DL 子句
每条规则都具有如下形态
U₁ ∧ … ∧ Uₙ → ∃ȳ. (C₁ ∨ … ∨ Cₘ)
其中每个析取项 Cᵢ 本身是头部原子的合取。这一种形态就容纳了全部五种头部形式——原子式(普通的 Datalog 规则)、存在式、析取式、合取式以及空(false)——因此,像 A ⊑ ∃r.C 这样降为带一个_共享_见证的 ∃y. (r(x, y) ∧ C(y)) 的公理,是一条规则,而不是两条互不相关的规则。
半朴素求值器执行原子头和不含存在量词的合取头。多个头共享一次体求值;每条记录的推导都标明原始子句索引和头序号。递归、因子投影与分层否定使用同一个求值器。谓词须等到所有生成规则完成后才算完备,即使共享规则提前产生了较高层的头。独立证明检查所选的头序号;第 2 版编码显式携带这一序号。
存在式头、析取头和假头会被点名拒绝。存在形式并不会因这一拒绝而丢失:受限 chase 会消费它,生成按前沿寻址的 Skolem 见证,四个存在式 RDF/RDFS 模式正是由此触发,规则清单也因此显示为完整。永远不会发生的是替代项泄漏到答案中——上层的蕴涵层会在物化边界处扣留每一个提及见证的结论,并报告这一扣留,而不是凭空编造调用方并未要求的答案。
确定性
使用 Guard::not_equal("?left", "?right") 可进行原生项不等比较,无需回调。它精确比较已绑定项的身份,不进行数值强制转换。调用方定义的 Guard::filter("!=", ...) 仍是回调:决定原生行为并参与子句摘要的是操作种类,而不是名称。独立证明检查器根据已检查的前提重新求值原生顶层过滤器。
- 每个键下的行保持插入顺序;arrangement(排布)是已排序的;任何映射的迭代顺序都不会到达输出路径。
- 计划以一个 BLAKE3 摘要进行内容寻址,该摘要涵盖规划器版本、调用方的契约哈希以及子句程序的规范摘要。缓存由调用方持有,绝不是进程级全局变量——全局缓存会使答案依赖于求值历史。
- 凡是并行化的工作,都使用按源顺序归约的带索引
par_iter/par_chunks,从不使用par_sort或par_bridge,并在wasm32-unknown-unknown上退化为内联顺序执行。
相同的输入在每个目标上都产生逐字节相同的输出。
上限只会拒绝,从不截断
三个上限约束每一次运行所持有与枚举的内容。调用方通过 EvalOptions 选择所有上限,每项都有明确的默认值:
| 上限 | 所约束的对象 | 设置方式 | wasm32 上的默认值 | 其他平台上的默认值 |
|---|---|---|---|---|
| 连接步数 | 枚举的候选解 | EvalOptions::with_max_join_steps | 1,048,576 | 1,048,576 |
| 存储的事实 | 初始给定或推导出的事实 | EvalOptions::with_max_stored_facts | 131,072 | 4,194,304 |
| 项存储区字节数 | 驻留项的词法形式字节数 | EvalOptions::with_max_term_arena_bytes | 16,777,216 | 16,777,216 |
EvalOptions::without_term_arena_limit 移除词法形式字节数的逻辑上限。实际存储准入仍然适用。预算报告提供有效上限,该值也参与契约哈希。
存储事实准入在改变存储前检查每一次唯一插入。拒绝时,BudgetReport::stored_facts 报告已准入的数量,observed_stored_facts 报告第一次被拒绝的插入,恰好多一个。重复候选不再消耗存储事实额度。
存储事实的默认值之所以不同,是因为存储所在的内存不同:wasm32 上的求值与页面的其余部分共享同一块线性内存,其默认值就是此前该上限尚为固定值时所有目标平台共用的那个值。原生进程能够持有大得多的最小模型,而一个按浏览器确定的上限曾在那里拒绝普通的、会终止的规则集——仅仅是一条把 70,000 条 ex:p 三元组逐条复制到 ex:q 的规则。默认值在编译时依据目标架构选定,绝不经由 Cargo feature。
连接步数的默认值在所有目标平台上相同。求值器在展开候选项之前,从轮次共享的预算池中预留该候选项的额度;额度耗尽时停止继续展开。这个工作量上限与保留存储分开:提高它可能允许更大的中间缓冲区,但不会提高存储事实或项存储区的上限。程序若需要更多候选工作量,调用方必须显式声明该额度(命令行上为 --max-join-steps)。
阻止发散规则的并不是连接步数上限。一条每轮生成一个新焦点节点的 SHACL 形状规则,只会针对输入发生变化的焦点节点重新执行,而不是针对此前的每一个焦点节点。项生成有独立的防护:新项长度有界时,由生成新项的轮数上限约束;保留的词法形式增长时,由项存储区上限约束。
上限只能拒绝。在上限之内的运行返回程序的最小模型,在任何允许它完成的上限下都是同一个模型。只提供完整结果的调用越过上限时会返回拒绝。保留状态的 EvaluationSession 通过单独的 PartialModel 提供经认证的事实。每个传入相同选项的调用方都会得到相同的答案或相同的拒绝;生效的上限被纳入结果的契约哈希,因此在一组上限下、或在某个目标平台的默认值下计算出的推理闭包,绝不会冒用另一组的身份。连接步数还取决于求值器的计划,因此针对某个版本收得过紧的上限,可能会在下一个版本中拒绝;留有余量的上限则不会改变一个已完成的答案。
Datalog 求值器不读取时钟。宿主可以将基于挂钟时间的截止期限或取消标志适配为与答案无关的 StopSignal 接口。信号在会话入口和轮次边界处被轮询。已停止的会话可以使用新的信号继续执行;新旧信号都不会改变完成后的模型。
模型输出、证明与工作量计数
普通求值默认使用 DerivationMode::ModelOnly。需要导出推导时,设置 EvalOptions::with_derivation_mode(DerivationMode::Record)。禁用记录时,Evaluation::derivations 返回 None;启用记录但没有推导出任何内容时,返回 Some([])。证明构造以 ProofError::DerivationsNotRecorded 拒绝仅有模型的结果。记录不会改变最小模型、内部规范见证的优先选择或候选计数。
Evaluation::work 将唯一输入事实和已提交的事实插入与物理候选准入分开计数。对于普通且已完成的分层运行,事实计数与连接计划无关。候选计数可能随规划器变化;报告给出规划器版本,调用方可以比较每个已提交事实对应的候选数。调度撤回可能导致稍后再次提交同一事实,因此产生另一次提交事件。
EvalOptions::with_round_execution(RoundExecution::Sequential) 为一次调用选择直接执行路径,不改变全局线程池。两种调度策略使用同一个求值器、按程序顺序归并并排序提交,保持相同的模型和已记录推导。
evaluate_guarded 等只提供完整结果的入口在拒绝时不返回模型。错误会点名该上限、观测到的与允许的数值,以及用于提高该上限的参数;蕴涵层通过 EntailError::Evaluate 或 EntailError::Chase 报告这些错误。
经认证的部分模型与续体(continuation)
EvaluationSession::new 接管输入存储的所有权,并借用不可变程序和 guard(守卫)求值器。它的 SessionContext 要求调用方提供规范的快照、守卫语义和证据机制身份标识。会话还会纳入所编写程序的规范身份标识。保留其 binding() 值,并将该绑定原样传给 resume,同时提供累计上限和可选的停止信号。调度方式可以变化;推导记录模式保持不变。任一绑定坐标发生变化时,续算会在执行前被拒绝。原始词典在每次公开读取和续算的边界处检查其绑定源是否仍然有效。
ResumeProgress::Paused 携带原始的资源或停止拒绝。partial_model() 借用初始事实和经证明已发布的事实、实际已完成的工作量、可选推导,以及每一层的 Complete、SoundLowerBound 或 Withheld 状态。前面的层全部完成之前,执行不会进入后续层,因此否定不会观察到尚未完整的下层关系扩展。后续依赖这些层的结论暂不提供。部分结果的身份标识在单独的哈希域中纳入原始规范绑定、governor(执行调控器)和消耗量。运行时的项句柄和行句柄绝不参与该身份标识。
提高上限或提供新的停止信号,即可继续执行已保留的连接、守卫、规则/轮次工作、排序后的事实发布以及当前增量。已完成的工作只计数一次;在相同的已拒绝额度下重试,不会增加已完成的工作量或守卫调用次数。EvaluationProofs::of_partial 为已记录且已发布的推导构造证明,并由完整模型所使用的同一个独立检查器校验。源和守卫失败仍是硬失败,并阻止进一步续算。
只有 ResumeProgress::Complete 才允许 take_complete() 返回 Evaluation。尚未完成时提出该请求,不会改变会话状态。完成后的模型、推导和成功的连接步数,与在最终选项下不间断运行的结果相同;其演算身份标识使用普通的 contract_hash_with 配方。续体是在进程内持有状态的所有者,没有序列化令牌形式。
GTS 图传输
GTS(Graph Transport Substrate) 是一种与本体无关的二进制容器与传输格式,用于 RDF 1.2 数据集与内容寻址的二进制载荷。PurRDF 托管其参考 Rust 引擎 purrdf-gts(重新导出为 purrdf::gts)。
本章是面向用户的导览。线格式本身由 docs/GTS-SPEC.md 规定——分帧、折叠语义、注册表与一致性类别请查阅该规范;此处任何内容都不取代它。
容器模型概览
GTS 文件是由一个或多个只追加段组成的 CBOR Sequence。每个段是一个确定性的 CBOR 头,后接由 BLAKE3 内容标识符串联起来的确定性 CBOR 帧。逻辑数据集通过对段序列进行确定性折叠得到:四元组、具体化节点、注解与二进制 blob 都成为折叠后容器图中的行。
这一设计自然带来的性质:
- 内容寻址且只追加——历史从不被改写;抑制本身也是一条追加的记录。多段文件通过简单拼接即可组合。
- 部分可读,读取器是全函数——读取器校验 BLAKE3 链并折叠它能处理的内容;无法解码的帧(未知编解码器、无密钥的加密帧)会降级为_不透明节点_加一条诊断,而不是中止。
- 二进制载荷随行——图所引用的 blob 与其位于同一文件中,与其他一切一样按内容寻址。
- 原生 RDF 1.2——规范形式化了三元组项与
rdf:reifies的映射、空节点作用域以及多段值的并集。
从 Rust 读写
容器引擎(purrdf-gts)负责线格式的全部机制——读取器、写出器、折叠、校验、COSE、信任策略:
#![allow(unused)]
fn main() {
use purrdf::gts::reader;
use purrdf::gts::{model::{Graph, Term}, writer::Writer};

let mut source = Graph::default();
source.terms.extend([
    Term::iri("https://example.org/alice"),
    Term::iri("https://example.org/knows"),
    Term::iri("https://example.org/bob"),
]);
source.quads.push((0, 1, 2, None));
let bytes = Writer::deterministic(&source, "example-profile")?.into_bytes();

// 把 GTS 字节折叠为容器图模型,同时校验 BLAKE3 链。
let graph = reader::read(&bytes, /* allow_segments */ true, /* expected_head */ None);

// 折叠是全函数:四元组、具体化节点、注解与 blob 都是行,
// 任何无法解码的内容都会保留为一个不透明节点加一条诊断。
println!("{} quads, {} blobs", graph.quads.len(), graph.blobs.len());
assert_eq!(graph.quads.len(), 1);
assert!(graph.blobs.is_empty());
assert!(graph.diagnostics.is_empty());
assert_eq!(bytes, Writer::deterministic(&graph, "example-profile")?.into_bytes());
Ok::<(), Box<dyn std::error::Error>>(())
}写出器编写帧,并生成逐字节确定性的单段快照(Writer::deterministic)——GTS 写出器与每个 PurRDF 序列化器受同一确定性不变量约束。
RdfDataset 的导入/导出路径位于上一层:总括 crate 的 gts 模块把容器引擎与 RDF 层适配器(快照组合、内容链校验)结合起来,因此面向 RDF 的 GTS 工作直接经由 purrdf 完成。
签名与加密
帧可以用 COSE 签名与加密;基于 OpenPGP 的检查以及信任策略层也是引擎的一部分。所有密码学实现都是纯 Rust——不依赖 C 工具链、线程或系统调用——这正是整个引擎能保持 wasm 友好的原因。无法解密的加密帧在折叠中只是一个不透明节点:容器仍然可读。
仅限 Rust 库:压缩证书、证明与密钥环校验
除读取、写入与折叠之外,purrdf-gts 与总括 crate 的 gts 模块还带有一套其他任何接口都无法到达的校验栈——CLI、Python、wasm 与 C 都不行:
- 带证书的可流式压缩——
compact_streamable把一个累积式日志重写为一个按交付顺序排列的段(前置流索引、尾部偏移页脚、带内字典),而compact_and_certify/verify_compaction/compose绑定一个内容投影,使压缩前与压缩后的容器折叠出逐字节相同的规范内容;校验器用其自身的密钥环从压缩前的字节重新计算。压缩从不改变内容,也不生成任何内容签名。 - Merkle 山脉(Merkle mountain range)证明——
mmr::{root, prove, verify_proof, prove_file}(gts-mmr-proof-v1),以及verify_content_chain,后者依次走过 COSE 签名 → 链头(head)重放 → 摘要包含性。不存在透明日志,也不存在签名检查点服务。 - OpenPGP 传输密钥——ASCII 铠装的 Ed25519 证书与未加密的私钥(
parse_transport_key、parse_secret_signing_key),并用verify_file_with_keyring支持轮换;其他算法、加密的密钥以及 v5/v6 数据包都会被拒绝,且不存在密钥环存储或吊销存储。
原生单元测试覆盖文件媒体类型映射以及 tar/PAX 的序列化与解析。冻结向量以及压缩/认证测试夹具还覆盖其他路径。这些检查仅证明其所述用例,并不意味着文件 profile、嵌套的 GTS-in-blob 读取器、信任策略或 ULID 行为都已得到完整覆盖。上游 gmeow-gts 规范与冻结向量仍是线格式的权威。
一致性向量
GTS 一致性依据一个冻结的、与语言无关的向量语料(仓库中的 vectors/)定义,并在其他语言的兄弟 GTS 引擎之间逐字节共享。这些向量从不在本仓库中重新生成或被「修复」——该格式由 gmeow-gts 项目管理,规范与其他参考引擎也在那里。
C ABI 的 star 层往返(转换)
对一个含引用三元组/具体化节点绑定的数据集,GTS star 层往返(转换)经由内核的 to_gts → read_graph → import_gts_graph 路径成功完成,与不含 star 的往返相同;crates/rdf-capi/tests/abi.rs 中的 gts_star_roundtrip_preserves_the_statement_layer 固定了这一点。参见入门:C。
相关内容
docs/GTS-SPEC.md——规范性的线格式(版本 0.9-draft,线格式主版本 1)。- 切片、映射与溯源——RDF↔GTS 损失台账。
- 入门:Python——把容器读回为关系行。
切片、映射与溯源
在各引擎之外,PurRDF 还提供了一个严肃的词汇或数据管道项目所需的基础设施:用于组织所编写 RDF 的切片目录、用于有损投影的显式损失台账,以及 SSSOM 与 FnO 交换格式的原生编解码器。
切片目录
purrdf-slice(重新导出为 purrdf::slice)是面向以_切片_(slice)组织的本体/词汇仓库的工具——切片即所编写 RDF 的目录(slices/<group>/<name>/),每个都由一个 manifest.ttl 描述:
- 目录——基于清单的发现(
SliceCatalog::discover)、带类型的切片元数据(SliceRecord、SliceTier)以及工件角色。切片的标识来自清单,而不是目录名。 - 所有权与依赖——术语所有权分析(每个已声明的术语恰好有一个拥有它的切片)、附带证据的依赖边、禁止边规则(扩展切片只依赖核心切片),以及可由机器应用的修复建议。
- 内容寻址——用于增量管道的确定性工件摘要与缓存键。
- 生成器——投影/映射生成器与 lint:前缀映射、JSON-LD 上下文、FnO 函数目录、声称(claim)视图。
秉承 PurRDF 不生成任何词汇 IRI 的规则,切片框架读取或输出的每个术语都属于调用方的词汇:SliceVocab 由调用方构造(它没有 Default),并贯穿每一个公共入口传递。
#![allow(unused)]
fn main() {
use std::path::Path;
use purrdf::slice::{SliceCatalog, SliceVocab};

// 调用方自己的词汇命名空间——PurRDF 不编造任何命名空间。
let vocab = SliceVocab::for_namespace("https://example.org/vocab/");
assert_eq!(vocab.slice_class(), "https://example.org/vocab/Slice");

// 在调用方的 slices 目录下发现各个 manifest.ttl。
let catalog = SliceCatalog::discover(Path::new("slices"), vocab)
    .expect("slices discovered");
for slice in catalog.records() {
    println!("{} ({:?})", slice.manifest.slice_iri, slice.manifest.tier);
}
}
损失台账
PurRDF 的投影允许有损——但绝不静默。内核带有一个机器可读的 RDF↔GTS 损失矩阵(generated/rdf-loss-matrix.json,一个生成的工件)以及一个 LossLedger API:当不具 star 能力的编解码器丢弃具体化节点(reifier)绑定,或 CSV 结果丢弃溯源信息时,实际丢弃的数量会被记录下来并呈报给调用方。参见编解码器与确定性以及结果格式。
溯源
purrdf-core 为冻结的 IR 提供了一个通用的溯源旁挂结构(sidecar)——归属、源集合以及逐四元组的溯源,引擎可以携带它们而不污染数据图。SPARQL 结果扩展(结果格式)与 SARIF 边界都会在各自的序列化边缘,把这些仅在运行时存在的溯源 id 解析为公开的 IRI。
SSSOM 与 FnO
内核中有两个原生的交换格式编解码器:
- SSSOM——对 Simple Standard for Sharing Ontological Mappings 映射集 TSV 的支持(
SssomMappingSet、SssomMapping,附带带类型的诊断),用于在数据旁携带跨词汇的映射。SssomSetComment把集合级的普通注释与溯源建模为一个无损的文档封套,独立于类 YAML 的表头元数据。新追加的溯源使用可互操作的「元数据到表格」位置;解析得到的表后注释作为一种显式扩展被保留。原始的 Unicode 注释行及其顺序得以保留,而物理行尾在序列化时确定性地统一为 LF。 - FnO——一个 Function Ontology 函数目录编解码器(
FnoCatalog、fno_to_quads、fno_to_ntriples),切片生成器用它把函数目录描述为 RDF。
与工具包中的其他一切一样,这些是针对_调用方_数据的编解码器——PurRDF 不定义自己的映射或函数。SSSOM 封套注释同样仍是与调用方无关的投影数据:它们不生成 RDF 谓词,不改变映射验证,也不改变 RDF 投影。
相关内容
rdflib 兼容性
Python 的 rdflib 是该生态中既有的主流 RDF 库,PurRDF 以两个层级与之对接:一个显式的兼容模块,以及一个需主动启用的直接替换(drop-in)影子包。
第 1 层:显式兼容层
主 purrdf wheel 附带一个由原生引擎支撑的 rdflib 兼容层:
from purrdf.compat.rdflib import Graph

g = Graph()
g.parse(data="<https://example.org/a> <https://example.org/b> <https://example.org/c> .",
        format="turtle")
对于希望在 PurRDF 引擎上使用 rdflib 风格 API 的新代码,这是推荐路径:导入名称如实反映其身份,并且它可以与真正的 rdflib 安装共存。
Graph.query、SPARQL 处理器、Dataset 和 ConjunctiveGraph 采用编译到原生求值器中的上下文初始绑定语义。查询赋值可以替换初始值,而初始映射仍可供外层操作使用。命名图视图和 default_union 决定查询的图作用域。直接使用 purrdf.Store.query 和 Store.prepare 接口时,仍遵循原生预绑定规则。
第 2 层:purrdf[rdflib] 影子发行包
若要让 import rdflib 字面上零改动即可使用,请安装这个需主动启用的 extra:
pip install "purrdf[rdflib]"
这会拉入独立的 purrdf-rdflib 分发包,其顶层 rdflib 包重新导出兼容层的接口,于是现有第三方代码中的 import rdflib / from rdflib.namespace import RDF 便透明地运行在 PurRDF 之上。注意:该影子包占用了 rdflib 这一导入名,绝不可与真正的 rdflib 同时安装——二者无法共存于同一环境。它是一个独立的分发包(从不打进主 purrdf wheel),正是为了让需要真实 rdflib 的环境直接不装它即可。
兼容性如何得到保证
该兼容层并非「尽力而为」——它在 CI 中作为单一一致性矩阵(docs/CONFORMANCE.md)的一部分受到把关:
- rdflib 直接替换(LSP)检查针对 purrdf 直接替换包运行 rdflib 7.6 自身的、随库固化的测试套件。
- 对等性测试套件针对真正的 rdflib 7.6 运行
purrdf.compat的第一方差分测试。
两者都使用严格的预期失败台账:每个已知分歧都连同逐测试的原因一起列出,意外失败会使构建失败,而被静默修复的分歧同样会使构建失败,直到台账缩减为止。台账列明当前的分歧,并区分尚不支持的配置执行与有意采用的术语和查询准入差异。
性能
一个仅用于报告的基准测试框架,在解析、序列化、SPARQL 与三元组模式迭代上,对以原生引擎为后端的 purrdf.compat.rdflib 直接替换包与真正的 rdflib 进行计时(make bench-python)。方法说明以及一张有代表性的(依宿主而异的)结果表见 docs/BENCHMARKS.md——数字因宿主而异,因此请在本地复现,而不要相信某个固定的倍数。其理念见性能。
相关内容
JavaScript 中的 RDF/JS
在 JavaScript 中,PurRDF 不自创 API 形态:npm 包 @blackcatinformatics/purrdf 在编译为 wasm 的原生引擎之上实现了 RDF/JS 社区规范——DataFactory、DatasetCore 与 Stream/Sink。针对 RDF/JS 接口编写的代码可以直接处理 PurRDF 的项与数据集。
数据工厂
DataFactory 涵盖标准的 RDF/JS 项构造函数——namedNode、blankNode、literal(value, languageOrDatatype?)、variable、defaultGraph、quad、fromTerm、fromQuad——外加显式的 RDF 1.2 扩展:
import { ready, DataFactory } from "@blackcatinformatics/purrdf";
await ready();
const f = new DataFactory();

// RDF/JS 标准接口。
const q = f.quad(
  f.namedNode("https://ex/alice"),
  f.namedNode("https://ex/knows"),
  f.namedNode("https://ex/bob"),
);

// RDF 1.2 扩展:引用三元组项与基础方向字面量。
const quoted = f.quotedTriple(q.subject, q.predicate, q.object);
const rtl = f.directionalLiteral("مرحبا", "ar", "rtl");
typedLiteral 是在规范的重载 literal 之外提供的便捷方法。
数据集
Dataset 实现了 RDF/JS DatasetCore:add、delete、has、match、size 与迭代(for (const quad of dataset)),外加经由原生编解码器的解析与序列化:
import { Dataset } from "@blackcatinformatics/purrdf";

const ds = Dataset.parse("<https://ex/s> <https://ex/p> <https://ex/o> .", "ntriples");
for (const quad of ds.match(null, f.namedNode("https://ex/p"), null)) {
  console.log(quad.subject.value);
}
const trig = ds.serialize("trig");
可接受的格式名:turtle、ntriples、nquads、trig、rdfxml、trix、hextuples、jsonld、yamlld,或其媒体类型。由于这些就是原生编解码器,输出是逐字节确定的,并与 Rust、Python 和 C 接口所输出的完全相同(编解码器与确定性)。
SPARQL
运行不止一条查询,或调用方需要带类型的结果而非原始字符串时,使用 QueryEngine。该引擎持有原生 SPARQL 计划缓存,并返回包根级别的项与数据集:
import { QueryEngine } from "@blackcatinformatics/purrdf";

const engine = new QueryEngine();
const result = engine.select(
  ds,
  "PREFIX ex: <https://ex/> SELECT ?o WHERE { ex:s ex:p ?o }",
);
console.log(result.rows.take(0)?.o?.value);

const graph = engine.construct(
  ds,
  "PREFIX ex: <https://ex/> CONSTRUCT { ex:copy ex:p ?o } WHERE { ex:s ex:p ?o }",
);
SELECT 行在跨越 wasm 边界时是单一所有者且惰性的。可以迭代 result.rows,调用 result.rows.take(index) 按索引消费,或调用 result.rows.toArray() 物化剩余的行。一行只能被消费一次;在耗尽之前放弃某个结果时,应调用 result.free()。
QueryEngine.queryRaw(...) 把 SELECT/ASK 结果序列化为 SPARQL Results JSON/XML/CSV/TSV,并把图结果序列化为 Dataset.serialize 所接受的同一组图格式。QueryEngine.update(...) 以原子方式应用 SPARQL UPDATE:只有在整个更新成功之后,数据集才会改变。
流与接收器
本包在 purrdf-events 摄取扩展点之上使用异步的 RDF/JS Stream/Sink 协议:
Sink——流式消费者:每个四元组调用一次push(quad),finish()返回累积的Dataset。datasetToStream(dataset)/streamToDataset(stream)——在Dataset与 RDF/JS 流之间架桥,用于与其他 RDF/JS 工具之间的管道输入或输出。
范围说明
- 本包的
Dataset将数据保存在内存中;这里的 SPARQL 方法查询这一驻留数据集。同步方法不安装任何SERVICE或LOAD来源,因此在那里,远程SERVICE或LOAD会显式失败,除非写了SILENT;异步孪生方法只能经由宿主传入的处理函数到达远程端点(见异步查询与联邦查询)。 - 作为四元组宾语的引用三元组项可以在 Turtle、N-Triples、N-Quads、TriG、RDF/XML 以及 JSON-LD / YAML-LD 中往返;TriX 与 HexTuples 不支持三元组项,把携带三元组项的数据集序列化到二者之一会抛出异常(见范围与当前限制)。
相关内容
- 入门:JavaScript / WebAssembly
- RDF 1.2 特性——这些扩展的含义。
crates/rdf-wasm——本包背后的 Rust cdylib。
设计规则与不变量
PurRDF 必须保持快速、确定、乏味:同一个引擎,同一套行为,原样带入 Rust、Python、WebAssembly 与 C。这一承诺由一小组硬性不变量来兑现,每一条都由 CI 强制执行,而不是依靠约定。规范性表述是仓库中的 AGENTS.md;本章解释其_缘由_。
没有语义性的 Cargo feature——永远没有
工作区中没有任何语义性 feature 标志。其唯一的 feature 声明是空的 purrdf-capi:capi = [] 兼容性标记,cargo-c 在构建 C ABI 时会无条件启用它。该标记不控制任何代码,绝不能出现在 cfg(feature = ...) 中;CI 会验证它恰好是空的形态,并扫描 Rust 源码中受 feature 控制的行为。PurRDF 是数据载体,而可选性会让语义因使用方而异——「同一版本」的两个构建若以不同方式解析或序列化,就会使整个意义落空。没有其他 [features],没有可选依赖,也没有受 feature 控制的行为。每个使用方得到的都是同样的、逐字节相同的语义。
显式的应用词汇表
PurRDF 不是本体。结构化 Markdown 与有序 JSON 按各自已发布的规范提供具名的标准 profile 和词汇表;调用方须有意选择 profile,或自行提供词汇表。不存在隐式的命名空间回退。其他应用词汇表——切片清单、陈述元数据下行转换(downcast)、盒角色、SPARQL 扩展函数命名空间、JSON-Schema 命名空间——都是调用方提供的配置,没有任何杜撰的默认值。在缺少其词汇表的情况下使用某项功能,要么硬错误,要么保持未激活。库从不硬编码任何厂商命名空间(GMEOW 本体是一个_使用方_;依赖箭头从不由 PurRDF 指向它),测试夹具使用 example.org。使用方配置类型(SliceVocab、Namespaces、StatementMetadataVocab)统一在下游一次性构建的 OntologyProfile 之后。
字节确定性
序列化器与 GTS 写出器都是逐字节确定性的。任何输出路径都不允许依赖迭代顺序、时间或随机数生成器;热路径上的映射正是出于这一原因而使用固定密钥的 FixedHasher。改变输出字节的变更必须以可见的方式更新受影响的黄金文件(golden file)。
内核隔离带
purrdf-core 绝不能依赖 PyO3,并有一道卫生关卡对依赖树进行断言。根 crate purrdf-hash 保持零运行时依赖,其上的基础叶子 crate(purrdf-lex、purrdf-iri、purrdf-xsd、purrdf-events)只依赖其 layers.toml 行所允许的第一方 crate,不依赖任何第三方 crate。诊断在内核中保持结构化且不含 SARIF;SARIF 边界是 purrdf-validate 这个叶子 crate。
一切皆可编译到 wasm
每个发布 crate 都必须能构建到 wasm32-unknown-unknown,否则 CI 会硬失败。任何依赖都不得在 wasm 路径上引入线程、文件系统、C 工具链或挂钟/随机数系统调用——密码学实现保持纯 Rust,正是出于这一原因。这正是 JavaScript 包之所以是_同一个引擎_、而不是移植版本的原因。
宁可硬失败,绝不给错答案
在整个工具包中,超出范围的输入是一个带类型的错误,绝不是部分答案:格式错误的 RDF 是 RdfDiagnostic,不支持的 SPARQL 内建函数是 EvalError::Unsupported,ShEx 语法错误是 ShexError,越过的求值上限是 EntailError::Evaluate 而不是被截断的推理闭包,不支持的结果投影是带类型的格式错误。按设计有损的投影是允许的,但必须_显式报告_,经由损失台账。
硬失败只针对工具包无法处理的输入——绝不针对其自身签名所接受的值。purrdf-entail::materialize 过去会拒绝 OWL-Direct 与 RIF,因为 Regime 值既不携带查询的类表达式,也不携带规则集;那是一个披着完全(total)签名外衣的部分函数,而修复的方式是更改参数,而不是把这个漏洞写进文档。它现在接受 Materialization,其中携带每种蕴涵机制自身的输入,因而不再有任何「不支持的蕴涵机制」错误可以指称。
推理一侧在硬失败之上增加了第二条纪律:当一次运行_成功_但有界时,它会明言。materialize 随每个推理闭包返回一份 ReasoningReport——绝不只返回一个数据集——其中载有该蕴涵机制的完备性、已触发与未触发的规则、所遇到的边界,以及所运行演算的契约哈希。静默交付一个正确但不完备的答案,与交付一个错误答案属于同一种失效模式。
一致性语料就是契约
W3C 与社区的测试套件均随库固化(vendored)、字节冻结并经 SHA-256 校验;测试框架断言精确的计数,并在其预期失败台账上执行 XPASS 纪律。参见一致性与测试。
辅助规则
- 经过测量的性能——性能声称需要一个基准测试,而不是一个形容词(性能)。
- 同一版本,同步发布——crates.io、PyPI 与 npm 发布同一个工作区版本(版本与发布)。
- 不使用任何 nightly 特性,MSRV 基于 stable——工作区中任何地方都没有
#![feature(...)]属性,MSRV 下限(当前为 1.98,位于 stable 通道)由专门的 CI 作业强制执行,该作业恰好在这一版本的编译器上构建。贡献者与 CI 门禁使用rust-toolchain.toml中指定的_浮动_ nightly,以获得更锐利的 clippy 与 rustdoc lint 以及更强的默认借用检查器;发布工件在 stable 上构建。 - 品牌——项目在行文中写作 PurRDF,在标识符中写作
purrdf(docs/BRAND.md)。
一致性与测试
PurRDF 使用标准测试套件和第一方语料检验各个引擎。这些套件随库固化于仓库中并按字节冻结——从不手工编辑,在每次 make check 时进行 SHA-256 校验,因此任何静默的内容修改都会使构建失败。完整的实时记分板见 docs/CONFORMANCE.md;本章说明这套机制如何运作。
单一的一致性矩阵
原生 Rust W3C 测试框架与 Python rdflib 直接替换(drop-in)检查合在一起,作为同一个记分板报告:
make conformance # 把每个套件汇总到一张表中
汇总器按固定顺序运行每个套件,打印每个套件的通过 / xfail 或跳过 / 失败计数,并给出总体的 RED/GREEN 裁决。只要出现任何意外失败,它就以非零状态退出,而 docs/CONFORMANCE.md 中输出的矩阵本身也在 CI 中受漂移防护(若已提交的区块过时,检查即失败)。
把关范围
| 引擎 | 套件 |
|---|---|
| IRI(RFC 3987) | W3C IRI + RFC 3986 §5.4 解析向量 |
| 语法编解码器 | W3C rdf-tests(Turtle/TriG/N-Triples/N-Quads/RDF-XML) |
| CSVW | W3C RDF 转换与元数据验证清单,外加一个锁定版本的独立实现 |
| OBO Graphs | 官方 OBO Graphs 0.3.2 JSON Schema,外加损坏探测 |
| Research Object 载体 | 五个对抗性的原生测试夹具、一个 5×5 的稳定语义转码矩阵,以及随库固化的 Frictionless Data Package v1 schema |
| RDFC-1.0 | W3C rdf-canon 测试夹具 |
| SPARQL 1.1/1.2 | 完整的 W3C sparql11 + sparql12 + 蕴涵套件,外加第一方的 CONSTRUCT 与 DESCRIBE 语料 |
| SPARQL CDT(SEP-0009) | 随库固化的 awslabs/SPARQL-CDTs 语料——需结合 docs/CONFORMANCE.md 中记录的词法空间分歧来解读,任何上游向量都无法表达这一分歧 |
| SPARQL 执行 governor(执行调控器) | 一份第一方的冻结语料,包含上限区间用例与扩展点用例 |
| SHACL | W3C data-shapes + DASH SHACL-AF/规则 + 一份第一方冻结语料 |
| SHACL 1.2 | 随库固化的整套 W3C shacl12-test-suite:验证、节点表达式、推理规则与 SPARQL 1.2 RL |
| ShEx 2.1 | shexTest v2.1.0(验证、模式、负向语法/结构) |
| 蕴涵 | W3C SPARQL 蕴涵机制用例(经由 SPARQL 测试框架)、随库固化的 W3C OWL 2 套件(DL 相容性,入台账),以及 W3C 自己的 OWL 2 RL 蕴涵测试(规则表的独立判定依据(oracle),入台账) |
| GTS | 冻结的跨语言向量——39 个中有 38 个按字节精确折叠为其已提交的预期结果,第 39 个是一项入台账的分歧,所针对的上游预期结果与本读取器相矛盾 |
| rdflib 直接替换(drop-in) | rdflib 7.6 自身的、随库固化的测试 + 第一方对等性测试 |
撰写本文时,每个套件都是绿色的——例如,已尝试的 shexTest 验证用例 1,105/1,105、W3C SHACL 129/129、编解码器往返 264/264、W3C SPARQL 蕴涵机制用例 70/70,以及在随库固化的 W3C OWL 2 DL 相容性语料上 262/262 个裁决一致,带类型的 OWL 2 分歧为 0 个;SPARQL 台账条目为 0 个。其他套件中未通过的用例仍严格入台账。其中两个数字需要说明其范围:OWL 2 DL 语料是一个_子集_,即 W3C 所发布的 482 个相容性形态用例中的 262 个;而规则表覆盖并不等于蕴涵一致性——在这份随库固化的 W3C OWL 2 RL 蕴涵测试语料上,chase 得分 50/50,即正向 27 个中 27 个、负向 23 个中 23 个,后者意味着未发现不可靠性。请始终以 docs/CONFORMANCE.md 中的当前数字为准,而不是这份快照。
台账纪律
测试框架从不静默跳过。有四种机制保证记分板如实:
- 精确总数——每个测试框架都断言所发现测试的数量,因此语料漂移会显式报错失败。
- XFAIL 台账(预期失败台账)——每个已知缺口都连同原因字符串一起列出,而测试框架会断言它_仍然失败_。修复了缺口却不删除其台账条目会使构建失败(XPASS 纪律),因此这些台账同时也是路线图。
- 特性跳过(仅限 ShEx)——整个规范特性可以按清单中的特性标签跳过,并精确计数。该列表目前为空。
- 单调预算(棘轮)——一份已提交的基线记录每个套件允许入台账缺口的精确数量。实际数量更大时判为 RED(回归),而实际数量_更小_时同样判为 RED,直到把预算调低以锁定这一进步。预算只能向下修改,这使得「跳过列表只会缩短」成为一项机制上的保证,而不是一条惯例。
在本地运行这些套件
make conformance                                     # 单一矩阵
cargo test -p purrdf-shex                            # 全部四个 ShEx 套件
cargo test -p purrdf-shapes --test w3c_conformance   # W3C SHACL 记分板
cargo test -p purrdf-shapes --test w3c12_conformance # W3C SHACL 1.2 记分板
cargo test -p purrdf-sparql-conformance              # W3C SPARQL
cargo test -p purrdf-rdf                             # RDFC-1.0 + 编解码器黄金数据
make projection-oracles                             # W3C CSVW + 独立的 CSVW/OBO 检查
cargo test -p purrdf-gts                             # GTS 向量
make check——完整的本地把关检查(fmt、clippy、构建、测试、卫生检查)——作为工作区把关的一部分运行 Rust 套件。
冻结就是冻结
vectors/ 中的 GTS 向量与其他语言的同源 GTS 引擎按字节精确共享,在本仓库中从不重新生成;线路格式由 gmeow-gts 管理。同样的「绝不手工编辑」规则适用于每一份随库固化的语料以及 generated/ 下的一切。
性能
PurRDF 的性能是测量出来的,而从不是断言出来的。项目文档中的任何数字都不是保证:基准测试仅作报告用途、对计时敏感,并随宿主、CPU、分配器与构建标志而变化。应把每个数字视为依赖于宿主、需在本地复现的示例——而不是「快 N 倍」的承诺。方法论与一张具有代表性的结果表见 docs/BENCHMARKS.md。
按构造即快速
驻留的 RdfDataset IR(驻留数据集 IR)在字符串存储区中驻留词法文本,并以组成项 ID 存储三元组项。其可复制的 TermId 使用 NonZeroU32;独立的全局地址空间在 GlobalTermId 中使用 NonZeroU64。热点映射使用固定密钥的 FixedHasher。冻结四元组行带有惰性序数置换索引(每个已构建的置换中,每个四元组占四个字节)。显式的不含图分量的 TripleDataset 具有三个组成项的行,以及独立的具体化节点和注解表。求值在驻留 ID 上进行。
布局比较位于 crates/rdf-core/benches/ir_layout.rs。该基准套件在同一组冻结四元组上,将驻留四元组行存储与数组结构体、谓词邻接两种备选布局进行比较,报告分配次数、内存高水位和端到端延迟。它还报告不含图分量的载体的物理行表与已构建的序数索引。每项结果都只适用于其测量时的源码、工作负载和宿主。
两层基准测试
| 层 | 测量内容 | 运行方式 |
|---|---|---|
| Rust 基准套件 | 原生引擎的热路径——IR 布局、写时复制的变更、打包索引的备选方案、编解码器、图/表格/Research Object 投影、SPARQL 词法分析/求值/规划、SHACL 验证、蕴涵 chase、GTS 编写、IRI 解析。 | make bench |
| Python 兼容测试框架 | purrdf.compat.rdflib(由原生实现支撑的直接替换方案)对比真正的 rdflib 7.x,在确定性的 example.org 语料上测量解析、序列化、SPARQL 与三元组模式迭代。 | make bench-python |
两层都仅作报告用途:它们从不属于 make check,也没有任何测试关卡断言加速。
变更的纪律
任何声称带来性能提升的变更都必须扩展基准测试,而不是在行文中断言加速。当规划器或算法的选择对与正确性相关的行为有影响时,它由_确定性_测试而非计时来把关——例如,基于代价的 BGP 规划器优于已退役的结构性启发式方法,这一点由统计真实中间行数的单元测试以及一项差分语料测试来断言,而基准测试只负责监视性能回退。
NativeSparqlEngine::explain_query 公开所选的 BGP 连接顺序,因此无须运行查询即可审计规划器的决策(SPARQL:查询)。
Rust、LLVM 与硬件路径
Rust 与 SIMD 优化指南 说明源码的表达方式、数学约定、汇编检查和测量规范。其中关于哈希与压缩的章节涵盖常量下标与位旋转、有界轮次展开、SIMD 分块与父节点批处理、流式状态、直接写入输出的方式以及内存分配下限。指南明确区分指令覆盖情况与在目标硬件上测得的吞吐量。
在本地复现
make bench                              # 默认的基准集合
cargo bench -p purrdf-iri --bench parse # 单个包的基准测试
cargo bench -p purrdf-core --bench pack_index_compare # 打包索引实验
cargo bench -p purrdf-rdf --bench projections -- --quick # 投影/载体样例
make bench-python                       # rdflib 对比测试框架
应在安静的机器上进行基准测试,并在同等条件下比较:分配器、CPU 频率调节与构建标志都会改变数字。
版本管理与发布
PurRDF 以同一个工作区版本、同步地发布到三个注册表——crates.io 上的 crate 套件、PyPI 上的 purrdf 与 purrdf-rdflib 分发包,以及 npm 上的 @blackcatinformatics/purrdf 包。完整流程见 docs/RELEASE.md。
自 1.0.0 起的语义化版本(semver)策略
自 1.0.0 起,整套软件完整遵循语义化版本:
- 破坏性变更递增主版本号。带有
!或BREAKING CHANGE:脚注的提交会触发主版本递增,变更日志会把每个此类条目标记为 BREAKING; - 次版本递增仅作增补,且与 API 兼容;
- 补丁版本递增仅修复缺陷。
这就是版本号所承诺的内容;它是一项策略声明,而不是超出 semver 含义之外的稳定性声称。全部三个已发布的接口共享同一个工作区版本并一同发布;CI 中的版本一致性检查会在各版本来源(Cargo.toml、pyproject.toml、package.json、CITATION.cff)不一致时使构建失败。
唯一的例外是 C ABI。libpurrdf 的 purrdf.h 带有自己的 PURRDF_ABI_MAJOR.PURRDF_ABI_MINOR,在该生成头文件中声明,每当导出签名变更时递增,由 crates/rdf-capi/tests/abi_signatures.rs 固定,并在运行时通过 purrdf_abi_version 读回。它的版本独立于工作区,并保持在 0.x:它并未冻结,工作区的 1.0.0 对它不作任何承诺。
MSRV 策略
支持的最低 Rust 版本是根 Cargo.toml 中的 rust-version——当前为 1.98——位于 stable 通道,由专门的 CI MSRV 作业强制执行:该作业显式设置 RUSTUP_TOOLCHAIN,并断言它所度量的编译器确实是 1.98。提高 MSRV 是一项记入变更日志的显著变更;它随次版本提升进行,绝不在修订版发布中出现。
MSRV 是对使用方的承诺;开发工具链是一项工具选择,二者相互正交。rust-toolchain.toml 为本地工作与 CI 关卡指定了一个浮动的 nightly,以使用其当前的 clippy 与 rustdoc 分析。按照策略,源码不使用任何 nightly(不稳定)特性(没有任何 #![feature(...)] 属性,MSRV 作业在每次变更时都会证明这一点),而发布通道在 stable 上构建每一个已发布的工件。
由标签驱动的可信发布
发布由标签驱动:rust-v<version> 把 crate 套件发布到 crates.io,py-v<version> 发布到 PyPI,npm-v<version> 把 wasm 包发布到 npm。各通道共享 cargo 通道的供应链安全姿态:
- 发布通过 GitHub Actions OIDC 使用可信发布(Trusted Publishing)——没有长期有效的注册表密钥;
- 拥有特权的发布作业使用固定版本的 action,且不使用依赖缓存;
- 每个
.crate包都会获得一份 GitHub 构建溯源证明(build-provenance attestation); - 整套包会获得一份 SPDX SBOM 及 SBOM 证明;
- 发布的 crate 集合在发布前会在
wasm32-unknown-unknown上接受检查; - 每个工作区 crate 的版本都必须与标签版本一致。
33 个 crate 的发布集合中,每个 crate 的每个功能版本都由该通道发布。功能发布要求 crate 记录以 Require trusted publishing(trustpub_only)锁定。该设置阻止 API 令牌发布新版本:crates.io 会回应 403 Forbidden: New versions of this crate can only be published using Trusted Publishing。
在打标签之前建立新 crate 的记录。使用令牌发布一个独立、空且无依赖的 0.0.0 包,以创建每个缺失的记录;实际工作区 crate 保持其功能发布版本。配置其可信发布者(Trusted Publisher)条目并启用 Require trusted publishing,然后核对并更新 scripts/release-crates.sh 中的 PURRDF_UNBOOTSTRAPPED_CRATES。功能发布开始前,全部 33 个记录必须存在、全部发布者条目必须配置完毕、每个记录必须锁定,且台账必须为空。scripts/check-crates-io-records.sh --require-all 验证公开记录与锁定状态;发布者条目的配置需要单独确认。
随后,由标签触发的可信发布运行按依赖顺序发布功能版本。在这些版本通过验证后,使用具有独立撤回(yank)权限的令牌撤回空的 0.0.0 版本,同时保留记录与发布者设置。完整的设置流程与历史记录引导凭据见上文链接的发布流程文档。
有十二个工作区成员有意从不发布到 crates.io:purrdf-capi(经由 cargo-c 构建,以 libpurrdf 的形式分发)、purrdf-sparql-conformance(测试框架)、purrdf-conformance-kit(社区语料运行器所使用的清单、报告与结果评分)、purrdf-hash-conformance(purrdf-hash 的冻结向量测试套件)、purrdf-cli(purrdf 二进制文件)、purrdf-envelope-probe(微型硬件包络采集工具)、purrdf-bench(基准测试工具)、purrdf-alloc-probe(分配测试与基准测试进行测量时所共用的计数分配器)、purrdf-testkit(共用测试支持:黄金文件、临时路径、冻结向量与 harness = false 运行器)、wasm-link(wasm 包的链接后处理工具)、helper-census(共享辅助函数门禁背后的结构普查工具),以及 purrdf-python(扩展 crate,改为经由 maturin 发布到 PyPI)。
这十二个成员中,只有 purrdf-alloc-probe 和 purrdf-testkit 被已发布的 crate 所依赖,并且仅通过 [dev-dependencies] 引入。因此,它们在根 [workspace.dependencies] 中的条目只有路径、没有 version 键,这正是 cargo 将它们从打包后的清单中去除的原因:未发布的 crate 不能成为已发布 crate 的带版本依赖,而 cargo publish 的验证步骤也会解析 dev-dependencies。
切出一个发布
在隔离分支上准备版本递增,使用 make 辅助目标保持三个发布通道一致。先合并经过审阅的发布变更,再从干净且已同步的 main 创建标签:
将变更日志的 Unreleased 小节改为发布版本号和日期,并在 docs/releases/<version>.md 写入经过审阅的简短摘要。make changelog 仅用于依据提交历史生成的说明。
# 1. 同步递增发布版本号(除非最终各版本号相等,否则失败)。
make bump VERSION=0.2.2

# 2. 依据递增后的 crate 版本重新生成已提交的 C-ABI 头文件。
make capi-header

# 3. 完善变更日志与经过审阅的摘要,保留迁移指导。

# 4. 仅暂存经过审阅的版本递增、头文件、变更日志与摘要,然后提交。
git commit -m "chore(release): 0.2.2"

# 5. 合并发布 PR 后,在最新的 main 上执行带关卡的标签推送。
make release-tags VERSION=0.2.2
make release-tags 在以下条件未全部满足时拒绝运行:工作树干净、分支为 main 且与 origin/main 同步、版本及 crates.io 记录/锁定检查通过、VERSION 与工作树一致、完整的变更日志小节与通过验证且经过审阅的摘要均存在,且三个标签均未在本地或远程存在。随后它按以下顺序运行各项关卡:
make check:Rust 与 wasm 工作区关卡及仓库卫生检查。make capi-check:生成的 C-ABI/头文件检查,以及链接后的 C 冒烟测试。make pytest:原生 Python 绑定测试套件。make python-release-check:构建并审计两个 Python 分发包各自的 wheel/sdist,使用固定版本的发布工具检查它们,并将它们一同安装。make wasm-pkg-test:经过优化、带体积关卡的 npm/wasm 包测试。make capi-bundle:构建并审计原生 C 分发包,包括接收方许可声明与重定位后的链接冒烟测试。
只有在每个接口都通过之后,它才会重新检查干净且已同步的状态,并以原子方式一同推送 rust-v、py-v 与 npm-v 标签。在完整的跨接口预检通过之前,不会创建任何标签。每个标签触发各自的通道,而 cargo 通道还会额外发布一个 GitHub Release,使用 docs/releases/<version>.md 中已提交且经过审阅的摘要,并链接到完整的变更日志。共享检查器会在打标签与发布之前验证精确的版本及 64 KiB 的 UTF-8 体积上限;发布说明不会被截断。
引用 PurRDF
每个发布都带有 DOI;若在研究中使用 PurRDF,请引用它——参见仓库中的 CITATION.cff。
诊断代码参考
以 RdfDiagnostic 值报告的失败,除 severity、message、detail 和 location 之外,还携带稳定的、机器可读的 code。代码就是契约:测试、SARIF 生成器、CLI、Python ValueError 文本以及下游的匹配器都以它为键,而 message 是可能改变措辞的自由文本。本页按族列出这些代码,以及每个代码所指的失败和调用方可以采取的措施。这个集合是从源码树中的构造位置枚举出来的,而不是凭记忆写成的;如果看到的某个代码不在此列,以源码为准,本页已过时。
代码采用 kebab-case,以拥有它们的族作为前缀。它们永远不会被翻译,调用方应比较整个字符串,而不是前缀。
RdfDiagnostic::presentation() 可选地提供稳定的消息标识、具名且带类型的参数,以及结构化详情。通过 message_id() 选择展示模板:一个诊断代码可以涵盖多个模板。直接读取参数值,而不是从英文文本中提取。to_json() 输出带版本的机器记录,其中逻辑 64 位定位信息及带类型的整数以精确的十进制字符串表示。SARIF 在 properties.diagnosticRecord 中保留该记录;C 调用方使用借用的 purrdf_error_presentation_json 访问器。
iri-*——IRI 解析与基准解析(purrdf-iri)
IriError::diagnostic_code 是整个工作区中这些字符串的唯一所有者;每个编解码器、SPARQL、ShEx 与 SHACL 都把 IRI 失败交由它处理。与基准相关的代码区分无效的基准、缺少基准,以及语法禁止相对引用这三种情况;它们各有不同的补救办法。
| 代码 | 含义 | 补救办法 |
|---|---|---|
iri-empty | 在要求非空 IRI/URI 的地方,字符串为空。 | 提供一个非空的 IRI。 |
iri-missing-scheme | 该字符串没有 scheme(方案),因此不可能是绝对 IRI。 | 以带有 scheme 的绝对形式书写 IRI。 |
iri-bad-scheme | scheme 格式错误(它必须以字母开头,且只包含字母、数字、+、- 与 .)。 | 更正 scheme。 |
iri-bad-percent-encoding | 所报告字节偏移处的 % 后面没有跟两个十六进制数字。 | 对 % 本身进行百分号编码,或补全转义。 |
iri-disallowed-char | 所报告的字节偏移处出现了 IRI 语法不允许的字符。 | 对该字符进行百分号编码或删除它。 |
iri-bad-authority | authority 组件(//host:port)格式错误。 | 更正主机或端口。 |
iri-non-absolute-base | 为解析提供的基准 IRI 本身不是绝对的。 | 提供一个带有 scheme 的基准 IRI,例如 http://example.org/dir/。 |
iri-relative-no-base | 遇到一个相对 IRI 引用,但作用域内没有基准:没有文档内指令,没有调用方提供的基准,也没有获取 IRI。 | 为文档添加基准(Turtle 族语法中用 @base/BASE,RDF/XML 中用 xml:base,JSON-LD 中用 @context.@base),或向 API 传入一个基准 IRI。 |
iri-not-absolute-by-grammar | 该引用不是绝对的,而该语法根本不允许相对引用(N-Triples、N-Quads),因此任何基准都不可能适用。 | 以绝对形式书写 IRI;提供基准无济于事。 |
native-codec-*——文本与 XML 编解码器(purrdf-rdf)
| 代码 | 含义 | 补救办法 |
|---|---|---|
native-codec-parse | 编解码器(Turtle 族、RDF/XML、TriX、HexTuples)无法解析输入;位置信息指明行与列。项嵌套超过解析器深度上限,也以该代码报告。 | 在所报告的位置修正文档。 |
native-codec-limit | 累计的源字节/行计数器,或明确设有上限的局部列计数器,无法表示下一个位置。 | 将源拆分为分别寻址的文档,或缩短过长的行。 |
native-codec-utf8 | 输入字节不是有效的 UTF-8。 | 把文档重新编码为 UTF-8。 |
native-codec-panic | 编解码器在解析时发生 panic,被 panic 防护捕获。这是 PurRDF 的缺陷,绝不是输入的问题。 | 连同触发它的输入一起报告。 |
native-codec-read | 通过流式读取器读取 RDF 源时,因 IO 错误而失败。 | 检查源流或源文件。 |
native-codec-write | 写出序列化输出时,因 IO 错误而失败。 | 检查目标位置。 |
native-codec-serialize | 目标格式无法表示该数据集——例如单图格式中的命名图——或写出器失败。 | 选择一种能承载该构造的格式,或通过损失台账通道进行序列化。 |
native-codec-replay | 把已解析的数据集重放到事件接收器时失败,因为接收器返回了错误。 | 接收器自身的错误包含在消息中。 |
native-codec-unsupported-format | 该媒体类型或格式标识符不对应任何编解码器。 | 使用受支持的媒体类型或格式 id 之一。 |
native-codec-datatype-not-iri | 字面量的数据类型项不是 IRI。 | 为该字面量指定一个 IRI 数据类型。 |
native-codec-direction-without-language | 在一个没有语言标签的字面量上给出了基础方向(base direction)。 | 添加语言标签,或去掉方向。 |
native-codec-invalid-direction | 给出的字面量基础方向既不是 ltr 也不是 rtl。 | 使用 ltr 或 rtl。 |
native-codec-iri-missing-value | 某个 IRI 项事件携带了空值。 | 提供该 IRI。 |
native-codec-missing-reifier-binding | 某个三元组项(triple term)引用了一个没有绑定的具体化节点(reifier)。 | 在引用具体化节点之前先绑定它。 |
native-codec-predicate-not-iri | 只允许 IRI 的位置(谓词)上的项不是 IRI。 | 使用 IRI 谓词。 |
native-codec-reifier-not-triple | 具体化节点绑定的不是三元组项。 | 把具体化节点绑定到一个三元组项。 |
native-codec-term-out-of-range | 事件流中的某个项 id 超出了该流所引入的范围。 | 产生这些事件的流不一致;请重新生成该流。 |
native-codec-unbound-triple-term | 某个三元组项既未给出其组成部分,也未指明具体化节点。 | 为该三元组项给出其组成部分或具体化节点。 |
最后九个代码出现在编解码器通道消费项事件而非文本时——即某个 GTS 图正在经由编解码器接口被解析——并与下文的 gts-* 与 rdf-ir-* 代码相对应。
native-jsonld-* 与 jsonld-*——JSON-LD 与 YAML-LD
| 代码 | 含义 | 补救办法 |
|---|---|---|
native-jsonld-decode | JSON-LD 或 YAML-LD 输入在表层语法上格式错误:无效的 JSON/YAML、编码错误,或超出了物化载体的字节预算。 | 修正表层语法或缩减文档。 |
native-jsonld-parse | 输入是良构的 JSON-LD,但无法映射到 RDF。 | 更正 JSON-LD 结构。 |
jsonld-json-input | 严格的 JSON 读取器拒绝了该输入,例如出现重复的对象成员。 | 删除重复项或更正 JSON。 |
jsonld-context-invalid | 某个上下文文档,或严格的带版本选项文档,无效。 | 更正上下文文档或选项文档。 |
jsonld-context-limit | 超出了某项上下文处理上限:已加载字节数、工作计数、定义复杂度,或离线上下文注册表的大小。 | 缩减上下文,或提高选项文档所声明的上限。 |
jsonld-derived-invalid | 确定性的数据集 IRI derived 模式无法推导出前缀(无效的 IRI,或 null 映射)。 | 更正用于推导前缀的那个 IRI。 |
jsonld-derived-limit | 超出了派生上下文的工作量或字节上限。 | 缩减数据集的 IRI 词汇,或提高所声明的上限。 |
jsonld-options-unused | 为一种既非 JSON-LD 也非 YAML-LD 的格式提供了 JSON-LD 序列化选项。 | 去掉这些选项,或序列化为 JSON-LD/YAML-LD。 |
cdt-*——SEP-0009 复合字面量
cdt:List 或 cdt:Map 的词法形式表示的是外层文档作用域中的空节点,因此一个无法解析的词法形式会使该作用域处于未定义状态,于是整个文档被拒绝,而不是把该字面量作为不透明值保留。
| 代码 | 含义 | 补救办法 |
|---|---|---|
cdt-literal-malformed | 复合字面量的词法形式无法解析。 | 更正该字面量。 |
cdt-literal-scan-disagreement | 有界词法扫描器与完整解析器对该字面量的判断不一致。 | 这是 PurRDF 的缺陷;请连同该字面量一起报告。 |
rdf-ir-*——数据集结构(purrdf-core 冻结与 GTS 导入)
RdfDatasetBuilder::freeze() 会验证它即将冻结的数据集的结构;若某个容器中的项不构成良构的数据集,GTS 导入接收器也报告同一族代码。
| 代码 | 含义 | 补救办法 |
|---|---|---|
rdf-ir-term-out-of-range | 某个四元组引用了构建器从未驻留过的 TermId。 | 在推入该四元组之前先驻留该项。 |
rdf-ir-predicate-not-iri | 四元组的谓词不是 IRI。 | 使用 IRI 谓词。 |
rdf-ir-literal-subject | 字面量出现在主语位置。 | RDF 不允许字面量作主语;请重新组织该陈述。 |
rdf-ir-triple-subject | 三元组项出现在主语位置。 | RDF 1.2 只允许三元组项出现在宾语位置;请使用具体化节点。 |
rdf-ir-graph-name-invalid | 图名是字面量或三元组项。 | 图名必须是 IRI 或空节点。 |
rdf-ir-graph-already-exists | 在记住空图的模式下,创建图时发现该图已经存在。 | 选择一个新的图名,或使用 SILENT 抑制此语义错误。 |
rdf-ir-reifier-not-triple | 具体化节点绑定指向的不是三元组项。 | 把具体化节点绑定到一个三元组项。 |
rdf-ir-triple-cycle | 某个三元组项直接或通过嵌套包含了它自身。 | 消除该环。 |
rdf-ir-triple-nesting-limit | 三元组项的嵌套超出了构建器的深度上限。 | 将嵌套展平。 |
rdf-ir-dangling-term-ref | 某个 GTS 角色引用了一个没有任何项事件引入的项 id。 | 该容器不一致;请重新生成它。 |
rdf-ir-gts-fold-diagnostic | GTS 折叠报告了一条诊断,经由导入呈现出来。 | 折叠诊断自身的代码与详情包含在消息中。 |
rdf-ir-iri-missing-value | 某个导入的 IRI 项的值为空。 | 提供该 IRI。 |
rdf-ir-literal-datatype-not-iri | 某个导入的字面量的数据类型解析为非 IRI。 | 为该字面量指定一个 IRI 数据类型。 |
rdf-ir-missing-reifier-binding | 某个导入的三元组项引用了一个没有记录绑定的具体化节点。 | 在容器中绑定该具体化节点。 |
rdf-ir-term-nesting-limit | 导入的三元组项嵌套超出了深度上限。 | 将嵌套展平。 |
rdf-ir-unbound-triple-term | 某个导入的三元组项既未给出其组成部分,也未指明具体化节点。 | 为该三元组项给出其组成部分或具体化节点。 |
gts-* 与 rdf-*——GTS 图的解析、验证与写出
| 代码 | 含义 | 补救办法 |
|---|---|---|
gts-term-out-of-range | 某个 GTS 项 id 超出了该图的范围。 | 该容器不一致;请重新生成它。 |
gts-iri-missing-value | 某个 GTS IRI 项的值为空。 | 提供该 IRI。 |
gts-predicate-not-iri | 某个 GTS 谓词项不是 IRI。 | 使用 IRI 谓词。 |
gts-literal-datatype-not-iri | 某个 GTS 字面量的数据类型未解析为 IRI。 | 为该字面量指定一个 IRI 数据类型。 |
gts-direction-without-language | 某个 GTS 字面量带有基础方向,却没有语言标签。 | 添加语言标签,或去掉方向。 |
gts-invalid-direction | 某个 GTS 字面量的基础方向既不是 ltr 也不是 rtl。 | 使用 ltr 或 rtl。 |
gts-missing-reifier-binding | 某个 GTS 三元组项引用了一个该图未绑定的具体化节点。 | 在容器中绑定该具体化节点。 |
gts-unbound-triple-term | 某个 GTS 三元组项既未给出其自身的组成部分,也未指明具体化节点。 | 为该三元组项给出其组成部分或具体化节点。 |
gts-self-reaching-term | 某个 GTS 项经由其自身解析,因此对其组成部分的任何游走都无法终止。 | 消除该环。 |
gts-term-nesting-limit | GTS 项嵌套超出了深度上限。 | 将嵌套展平。 |
gts-fold-diagnostic | GTS 折叠报告了一条或多条诊断。 | 检查详情中列出的折叠诊断。 |
gts-verify-digest-inclusion | 内容寻址的 RDF 项未被包含在已验证的链中。 | 该容器的链没有覆盖其内容;不要信任它。 |
gts-verify-signature | COSE 签名验证失败。 | 检查签名密钥与容器的完整性。 |
gts-writer-codec | GTS 写出器的编解码器在写出时报告了错误。 | 编解码器自身的错误包含在消息中。 |
rdf-graph-name-not-node | 在构建 GTS 图时,某个命名图的名称不是 IRI 或空节点。 | 使用 IRI 或空节点作为图名。 |
rdf-reifier-not-node | 在构建 GTS 图时,某个 RDF 1.2 具体化节点不是 IRI 或空节点。 | 使用 IRI 或空节点作为具体化节点。 |
rdf-term-nesting-limit | 在构建 GTS 图时,RDF 项嵌套超出了深度上限。 | 将嵌套展平。 |
native-sparql-*——SPARQL 引擎边界(purrdf-sparql-eval)
| 代码 | 含义 | 补救办法 |
|---|---|---|
native-sparql-query-parse | 查询文本无法按 SPARQL 1.1/1.2 语法解析(包括格式错误的 VERSION 声明;格式正确但无法识别的版本属于 native-sparql-unsupported)。 | 在所报告的位置修正查询。 |
native-sparql-update-parse | 更新请求无法解析。 | 在所报告的位置修正更新。 |
native-sparql-query-explain | 在 --explain 下求值失败;求值器的错误包含在消息中。 | 处理底层的求值错误。 |
native-sparql-query-eval | 查询求值失败,且没有更具体的代码对该错误分类;求值器的错误包含在消息中。 | 处理底层的求值错误。 |
native-sparql-internal | 求值器的不变量遭到破坏。执行无法产生有效答案。 | 报告此失败时请附上查询和输入;该问题需要修复引擎。 |
native-sparql-composite-bound | 构造复合数据类型值时超出了元素数量或词法字节的资源上限。 | 减小所构造的值。 |
native-sparql-float-environment | 调用线程的浮点环境无法保持距离运算规定的 IEEE-754 结果。 | 在浮点环境受支持的线程上求值。 |
native-sparql-function-operational | 宿主函数或关系在执行期间失败:返回不透明错误、捕获到 panic、达到资源上限,或收到无效的协议响应。 | 修复被调用方或调整资源上限;此类失败无法得出验证结论。 |
native-sparql-source-read | 存储操作拒绝了正向/反向查找或完整的行迭代消费。这是致命错误,即使在 SERVICE SILENT 内也如此;不会发布部分答案。 | 修复源或调整其明确的资源限制,然后再重试。 |
native-sparql-workspace-unpriced | 某项执行操作没有经过准入的工作内存所有者,或调用原始求值器入口时未持有所需的预留。 | 使用携带视图所提供的自有工作内存准入的引擎入口,并补全宿主或提供方所需的工作内存证明。 |
native-sparql-workspace-bound-overflow | 经过认证的工作内存上界计算超出了 u64。 | 降低查询的中间结果基数或模式数量。 |
native-sparql-update-eval | 更新求值失败,且没有更具体的代码对该错误分类;求值器的错误包含在消息中。 | 处理底层的求值错误。 |
native-sparql-algebra | 查询的代数在求值之前被拒绝:Query::validate 拒绝了它,或者某个预备好的计划需要针对本次求值提供的注册表重新规划。 | 按消息所说修正查询,或在执行之前预备改动后的代数。 |
native-sparql-construct | 类型化的图构建收到的查询不是 CONSTRUCT。 | 用 CONSTRUCT 查询构建图。 |
native-sparql-execution-parameter | 预备好的执行收到了它未声明的参数名或槽位。 | 只绑定该执行所声明的参数;消息中列出了它们。 |
native-sparql-relation-incomplete | 某个属性函数关系只用其部分数据作答,而所在的入口没有用于标注这一不完整应答的证据槽(不受管控的查询通道,以及 UPDATE)。消息会指名该关系及其自身给出的原因。 | 在受 governor 管控的入口上运行查询——其回执携带该关系的见证——或等待该关系完整。 |
native-sparql-property-function | 属性函数(property function)扩展点拒绝了该查询:某个已声明命名空间下的谓词没有注册,某个调用点的元数与该关系不匹配,没有任何全序能用于某条链,或者一个预备好的计划正在一个与其预备时不同的注册表下求值。 | 注册该关系、更正元数,或在同一个注册表下预备并求值。 |
native-sparql-aggregate-function | 自定义聚合扩展点拒绝了该查询:某个 AGG(<iri>, …) 没有指向任何已注册的聚合,或者一个预备好的计划正在另一个聚合注册表下求值。 | 注册该聚合,或在同一个注册表下预备并求值。 |
native-sparql-custom-function | 某个函数或聚合 IRI 没有解析到任何已注册的自定义函数、原生函数或 XSD 构造函数。 | 在该 IRI 下注册函数,或使用原生函数。 |
native-sparql-quoted-triple-term-variable | 在基本图模式或属性路径中,某个变量占据了引用三元组项的一个组成部分;结构化的三元组项匹配不在支持范围之内。 | 把三元组项作为整体绑定,或通过具体化节点接口匹配其组成部分。 |
native-sparql-heldin-unconfigured | 调用 heldIn 时没有调用方提供的 standpoint(立场)谓词配置。 | 在使用 heldIn 之前先配置 standpoint 谓词。 |
native-sparql-evaluation-stack-exhausted | 请求的嵌套深度超出了求值它的线程栈所能容纳的范围:在递归遍历开始之前,求值器会用剩余的栈空间衡量计划的整体高度(关联替换在其所做副本的每一层也会检查),并在耗尽之前拒绝,而不是让进程中止或让 wasm 实例陷入 trap。解析器已接受该请求,在更大的栈上同一请求可以得到应答。 | 在以更大的栈创建的原生线程上求值,或减少请求的嵌套深度。在 wasm 中,两条通道运行在大小相同的栈上——异步作业的栈区域与模块自身的影子栈完全一样大——因此在那里的补救办法是减少嵌套深度,消息也不会给出其他办法。 |
native-sparql-unsupported | 请求本身是良构的,但使用了本引擎拒绝按原样求值的内容——例如没有任何解为其指明端点的 SERVICE ?e、(不写 SILENT 时)绑定到字面量的 ?e,或无法识别的 VERSION。消息会指出具体是什么,并在可行时给出改写方式。Cloudflare 适配器以 400 应答。 | 按消息所述改写请求。 |
native-sparql-host-stack-exhausted | 仅限 wasm:请求的嵌套深度超出了 JavaScript 引擎自身调用栈所能容纳的范围。PurRDF 为求值每个请求保留该栈中固定的 640 KiB 预算——图模式最多嵌套 284 层,整棵树最多 2 048 层外加每个嵌套组八层,表达式与路径最多 2 304 层——而 V8 为同步通道和异步作业分配的栈相同,因此超出预算的计划会在运行之前被拒绝,两条通道一致。解析器在堆上分配的栈中处理嵌套;这些上限用于求值器准入。Cloudflare 适配器以 400 应答。 | 减少请求的嵌套深度。 |
native-sparql-bnode-mint-prefix | 选项中提供的空节点生成前缀无效。 | 提供一个有效的前缀。 |
native-sparql-service-denied | 已安装的 ServiceCatalog 未向请求指名的某个 SERVICE 端点授予所需的能力——该端点没有 profile,或其 profile 未授予所需的 query、network 或 credentials 能力——因此没有联系任何端点。在 SERVICE SILENT 下该子句则是连接的单位元,并记录为一次被静默的 denied 调用。Cloudflare 适配器以 403 应答。 | 在目录中为该端点授予该能力,或去掉 SERVICE。 |
native-sparql-service-host-denied | 宿主自己的服务解析器依据其自身策略拒绝了某个 SERVICE 请求,且没有指名任何目录能力——例如某个 JavaScript resolveService 应答了 { kind: "denied" }——因此没有联系任何端点。在 SERVICE SILENT 下该子句则是连接的单位元,并记录为一次被静默的 host-denied 调用。Cloudflare 适配器以 403 应答。 | 在宿主策略中允许该请求,或去掉 SERVICE。 |
native-sparql-service-failed | 已联系某个 SERVICE 端点,但它没有给出可用的应答:传输失败、HTTP 错误状态、重定向、解析器自身的超时,或无法解码的响应体。在 SERVICE SILENT 下该子句则是连接的单位元,并记录为一次被静默的调用。Cloudflare 适配器以 502 应答。 | 让该端点可达,或写作 SERVICE SILENT。 |
native-sparql-service-unconfigured | 没有任何远程查询来源能到达请求指名的某个 SERVICE 端点:要么没有配置来源,要么已配置的来源应答说它所持有的内容都到达不了该端点。在 SERVICE SILENT 下该子句则是连接的单位元,并记录为一次被静默的 unconfigured 调用。Cloudflare 适配器以 500 应答。 | 配置一个能到达该端点的来源,或去掉 SERVICE。 |
native-sparql-load-no-resolver | 请求了 LOAD <iri>,但没有提供 GraphResolver 宿主扩展点。LOAD SILENT 则会成功返回、不加载任何内容,并记录为一次被静默的 unconfigured 调用。 | 注入一个解析器,或去掉该 LOAD。 |
native-sparql-load-denied | 已安装的 ServiceCatalog 未向 LOAD 来源授予所需的能力(LoadError::Denied)——该来源或某次重定向指明的位置没有 profile,或其 profile 未授予所需的 network 或 credentials 能力——因此没有抓取任何内容。LOAD SILENT 则会成功返回、不加载任何内容,并记录为一次被静默的 denied 调用。Cloudflare 适配器以 403 应答。 | 在目录中为该来源授予缺少的能力,或去掉 LOAD。 |
native-sparql-load-host-denied | 宿主自己的 LOAD 解析器依据其自身策略拒绝了该来源,且没有指名任何目录能力(LoadError::HostDenied)——例如某个 JavaScript resolveLoad 应答了 { kind: "denied" }。LOAD SILENT 则会成功返回、不加载任何内容,并记录为一次被静默的 host-denied 调用。Cloudflare 适配器以 403 应答。 | 在宿主策略中允许该来源,或去掉 LOAD。 |
native-sparql-load-failed | GraphResolver 无法抓取该文档(LoadError::Transport)——例如 wasm 包的异步 resolveLoad 应答了 { kind: "transport" }、抓取超出了其目录 profile 的超时,或跟随了五次以上的重定向。LOAD SILENT 则会成功返回、不加载任何内容,并记录为一次被静默的调用。Cloudflare 适配器以 502 应答。 | 让该来源可达,或写作 LOAD SILENT。 |
native-sparql-load-decode | GraphResolver 抓取到了文档,但无法解析它(LoadError::Decode)——例如 wasm 包的异步 resolveLoad 交付的文档所用的媒体类型没有解析器可读,或者字节并不是所指名的语法。LOAD SILENT 则会成功返回、不加载任何内容,并记录为一次被静默的调用。Cloudflare 适配器以 502 应答。 | 以解析器能够解析的语法提供文档,或写作 LOAD SILENT。 |
native-sparql-load-stopped | 在等待 LOAD 期间,请求自身的停止信号(取消或截止时间)被触发(LoadError::Governed)。受 governor 管控的请求报告的是 governor 触发,而不是这个代码,无论是否写了 SILENT。 | 放宽截止时间,或不要取消该作业。 |
native-sparql-load-fault | GraphResolver 的处理函数发生故障(LoadError::Fault)——例如 wasm 包的异步 resolveLoad 抛出异常、返回被拒绝的 Promise、什么也没有应答,或指明了协议未定义的失败种类。消息携带处理函数自己的原话。LOAD SILENT 则会成功返回、不加载任何内容,并记录为一次被静默的 fault 调用。Cloudflare 适配器以经过清理的 500 应答,真正的原话以关联 id 写入其日志。 | 返回一份带媒体类型的文档、一个 Response、一个 Dataset、一次重定向或一个带类型的失败——绝不要抛出异常。 |
native-sparql-cancelled | wasm 异步通道:一个不受 governor 管控的操作被取消(其 AbortSignal 已触发)。受管控的操作则在其结果中报告这次触发。Cloudflare 适配器以 503 应答。 | 不要取消该操作。 |
native-sparql-deadline | wasm 异步通道:一个不受 governor 管控的操作超过了截止时间。Cloudflare 适配器以 503 应答。 | 放宽截止时间。 |
native-sparql-not-acceptable | wasm 异步通道:一个协商查询的结果——一个带有命名图的图——没有任何 Accept 请求头允许的格式能够承载。Cloudflare 适配器以 406 应答,并列出能够承载它的格式。 | 接受 TriG、N-Quads 或 JSON-LD。 |
native-sparql-update-in-flight | wasm 异步通道:同一数据集的另一个异步更新已在途,或者数据集在该更新运行期间被修改,因此该更新被拒绝,而不是针对一个它从未见过的状态求值(或提交在其之上)。Cloudflare 适配器以 409 应答。 | 等待第一个更新完成,再发送下一个。 |
native-sparql-host-fault | 失败的是宿主,而不是请求,也不是某个端点:某个 SERVICE 来源的处理函数在不带 SILENT 的子句中发生故障(EvalError::ServiceHostFault)——例如某个 wasm resolveService 抛出异常、返回被拒绝的 Promise、以不是应答的内容作答,或指明了协议未定义的失败种类(在 SERVICE SILENT 下该故障是连接的单位元,并在证据中记录为一次被静默的 fault);或者,在 wasm 异步通道上,某个作业的交付协议被破坏,或其栈帧覆写了其栈区域的金丝雀字。Cloudflare 适配器以经过清理的 500 应答,真正的原话以关联 id 写入其日志。 | 修正宿主的处理函数。 |
native-sparql-governor-ceiling | 协议边界:某个确定性的 governor 上限叫停了该操作——上限已达到,或规划器的估算已经超出。操作的结果携带这次触发;这是宿主据以应答它的 problem 的 code(Cloudflare 适配器的 422)。 | 提高上限,或收窄请求。 |
native-sparql-evaluation | 协议边界:操作的求值失败,且没有更具体的代码;这是宿主据以应答它的 problem 的 code。 | 处理底层的求值错误。 |
native-sparql-update-bad-destination | ADD/MOVE/COPY/LOAD 的目标是 NAMED 或 ALL;它必须是 DEFAULT 或单个命名的 GRAPH。 | 指定单个目标图。 |
native-sparql-update-graph-missing | UPDATE 使用默认的 RememberEmpty 图生命周期,但其命名的输入图不存在。CLEAR、DROP、ADD、COPY 和 MOVE 会在更改目标图之前拒绝该输入;SILENT 保持本次操作的状态不变。以自身为目标的 COPY 和 MOVE 无条件地不做任何操作。 | 创建或加载输入图,或使用 SILENT。 |
native-sparql-subst-iri | 某个替换值不是有效的 IRI。 | 提供一个有效的 IRI。 |
native-sparql-subst-triple-predicate | 某个被替换的引用三元组的谓词不是 IRI。 | 使用 IRI 谓词。 |
native-sparql-subst-literal-datatype | 被替换的字面量的数据类型不是 IRI。 | 使用 IRI 数据类型。 |
native-sparql-subst-langtag | 预绑定字面量的语言标签不是该词法 profile 所接受的。 | 提供一个良构的语言标签。 |
native-sparql-xpath-operational | 所选的带日期 XPath 法则发生了运行层面的失败,且未指明单一的 xpath-* 资源。查询被中止,不发布任何答案。 | 报告此失败时请附上查询和输入。 |
xpath-*——带日期的原生 XPath 正则表达式(purrdf-core)
这些代码仅在调用方为 SPARQL REGEX 与 REPLACE、SHACL sh:pattern 或 ShEx 模式分面选择了带日期的 XPath 法则(xpath-2.0-2010-12-14 或 xpath-3.1-2017-03-21)时出现。未作选择时,运行的是兼容正则表达式,这些代码都不会出现。purrdf_core::xsd_regex::xpath::Resource::code 是它们唯一的所有者。每个代码都指明一个 Resource:要么是 Limits 的某个上限扣留了它(Error::Resource,附带确切的需求量与上限),要么是宿主拒绝为它分配存储(Error::Allocation)。每一行都给出了 Limits::new() 设定的生产上限;上限为零即完全扣留该资源。
每个 xpath-* 代码都是运行层面的。它绝不是语法裁决,也绝不是不匹配:无效的标志(FORX0001)、无效的模式(FORX0002)、匹配空字符串的替换模式(FORX0003)或无效的替换文本(FORX0004)则是宿主普通的无效模式结果,即 SPARQL 表达式错误、SHACL 结果或失败的 ShEx 分面。拒绝会使整个操作失败。查询不发布任何答案,更新不改变任何内容,验证不写出任何报告;拒绝绝不会变成未绑定的值、false 的过滤结果或符合约束的图。C ABI 以 PURRDF_STATUS_REGEX_RESOURCE_ERROR(13)报告它。
这些上限适用于每个模式。匹配会计入实际执行的工作:字符比较、分支选择、状态复制、搜索位置推进和替换输出。匹配器的一步没有通用的纳秒耗时;每字节一步或一到三步的范围都不能描述所有搜索。
在按日期指定的法则下,输入不可能达到的有限最大次数不再产生不同的计数状态。兼容性法则中能匹配空串的主体仍保留有限次数边界和原有捕获优先级。贪婪的单字符连续段,包括选择分支和捕获链,只扫描一次,并按优先级保留可停位置。主体不能匹配空串的大计数重复在边界比较保持不变时可以复用相对状态,并在接近边界时恢复精确计数。
采用生产默认值的测试覆盖四 mebibyte 输入上的 ^[\s\S]{0,10000000}$、^[^\n]{0,10000000}$、^[^<>]{1,5000000}$、^[\p{L} ]{1,5000000}$ 和 ^(\w+\s?){1,5000000}$,以及四 mebibyte 输入上的精确次数选择 ^(a|b){4194304}$ 和 (a|b){4000000}。是非判断和捕获搜索的整数工作量上限为:这些字符类与分组单词每字节四步,这些选择分支每字节六步。将不约束输入的最大次数扩大十倍,工作量保持不变;这些测试夹具的上限并不是通用的准入或耗时保证。对两 mebibyte 分组单词执行 REPLACE 会保留最后一次迭代的捕获,并计入模板和输出工作。native_xpath_large 基准组测量这些形式及其计数和输入大小阶梯,同时保留原有的字面量、分组和对抗性邻例。
主体能重复空串的嵌套计数重复仍会区分计数组合。在 aaab 上,((a?){3000}){3000}b 能给出答案,而 ((a?){5000}){5000}b 会达到操作上限。没有通用的最小计数阈值:哪些状态同时存在取决于模式和输入。含反向引用的模式保留回溯匹配器,其指数级探索(在四十个 a 上的 ^(a|aa)*c\1$)可能达到步数上限。这种拒绝是使操作失败的硬错误,不是 false、缺失的捕获或部分替换结果。
| 代码 | 含义 | 补救办法 |
|---|---|---|
xpath-pattern-bytes | Resource::PatternBytes:模式源文本的 UTF-8 字节数超过上限(64 KiB)。无论其语法是否有效,源文本都会在解析之前被拒绝。 | 缩短该模式。 |
xpath-compile-steps | Resource::CompileSteps:编译该模式所需的编译器操作(包括扫描的字符与集合运算)超过上限(4,000,000)。 | 简化该模式,例如其字符类运算。 |
xpath-program-nodes | Resource::ProgramNodes:编译后的程序所需的节点数超过上限(262,144)。 | 简化该模式,或减少其计数重复。 |
xpath-compile-slots | Resource::CompileSlots:构建程序所需的构造单元数超过上限(2,097,152)。 | 简化该模式,或减少其计数重复。 |
xpath-match-steps | Resource::MatchSteps:实际匹配、捕获搜索或替换工作超过 250,000,000 次操作。较大的非约束最大次数和符合条件的单字符计数不会使每字节工作量成倍增加;嵌套计数组合、状态闭包、反向引用和替换输出仍可能耗尽这一上限。不发布答案或部分替换。 | 简化代价高的模式结构,在不需要其语义时移除反向引用,或处理更短的输入。 |
xpath-match-states | Resource::MatchStates:匹配所需的同时待定的备选状态数超过上限(65,536)。 | 减少该模式的选择分支与重复。 |
xpath-match-slots | Resource::MatchSlots:活动状态、捕获与续延所需的单元超过上限(1,048,576)。主体能匹配空串的嵌套重复是否达到该上限取决于其计数的组合。 | 减少该模式的捕获与重复,或匹配更短的输入。 |
xpath-output-bytes | Resource::OutputBytes:REPLACE 的输出超过上限(64 MiB)。 | 在更短的输入上替换,或使用更短的替换文本。 |
reasoning-*——在蕴涵机制(entailment regime)下执行的 SPARQL(purrdf)
| 代码 | 含义 | 补救办法 |
|---|---|---|
reasoning-closure-relation-witness | 从推理闭包派生的属性函数关系,不能与其受限 chase 生成了存在性见证的 OWL Direct-Semantics 运行组合使用:遍历闭包的关系可能返回一个生成的空节点,而该机制的作用域图并不包含它。 | 在不生成见证的机制(rdf、rdfs、owl-rl、d、rif、simple)下查询,或从该调用中去掉由数据集派生的关系。 |
reasoning-closure-relation-rebuild | 在推理闭包上重建属性函数关系失败。 | 关系构建器自身的错误包含在消息中。 |
statements-*——陈述元数据的摄入(purrdf-rdf)
当把文档的 rdf:reifies 与 owl:Axiom 陈述读入陈述层时,会出现这些代码。
| 代码 | 含义 | 补救办法 |
|---|---|---|
statements-turtle-parse | 陈述元数据 Turtle 解析失败。 | 修正该 Turtle。 |
statements-non-iri | 在此上下文中必须是 IRI 的某个项不是 IRI。 | 使用 IRI。 |
statements-reifies-non-triple | rdf:reifies 的宾语不是三元组项。 | 对一个三元组项进行具体化。 |
statements-malformed-axiom | 某个 owl:Axiom 缺少其源、属性或目标。 | 补全该公理。 |
statements-conflicting-structural | 同一个主语在某个结构字段上带有两个不同的值。 | 只保留一个值。 |
其他单代码族
| 代码 | 含义 | 补救办法 |
|---|---|---|
sssom-tsv-parse | 某个 SSSOM TSV 文档格式错误:缺少表头行或表头行不可读、curie_map 条目或集合注释格式错误、某行格式错误,或置信度不是数值;位置信息指明所在行。 | 在所报告的行修正该 TSV。 |
content-id-scheme | 某个内容 id 的 scheme 前缀无效:为空、含非 ASCII 字符,或以十六进制数字结尾(这会使它与 64 个十六进制字符的尾部产生歧义)。 | 选择一个非空、纯 ASCII 且不以 0-9、a-f 或 A-F 结尾的前缀。 |
代码在何处呈现给调用方
- Rust——返回错误上的
RdfDiagnostic::code;其Display形式为<severity> <code>: <message>。 - Python——
ValueError消息即该Display形式(例如error native-codec-parse: …);IRI 失败则输出为<code>: <message>(例如iri-relative-no-base: …)。 - JavaScript——抛出的
Error的消息携带同样的文本,其code属性则携带代码本身。wasm 包自身的拒绝携带purrdf-wasm-*代码:purrdf-wasm-options(某个操作拒绝了一个选项或参数)、purrdf-wasm-usage(某个作业在不该请求的时候请求了某样东西)、purrdf-wasm-serialize(结果无法以所要求的格式写出)、purrdf-wasm-entailment(某个蕴涵机制或其推理闭包失败)、purrdf-wasm-extension-environment(无法构建聚合注册表)、purrdf-wasm-shacl与purrdf-wasm-shacl-product-refusal(某个 SHACL 接口失败,或拒绝了一个预备好的产物)。 - C——经由 C ABI 返回的错误字符串携带相同的文本。
- SARIF——每条结果的
ruleId即该代码,并在本次运行的规则表中带有一个reportingDescriptor(purrdf-validate)。